EVA는 긴 영상 전체를 한 번에 토큰화하는 대신 필요한 구간을 찾아 다시 보지만, 절약되는 토큰만큼 여러 번의 탐색과 추론 지연을 감수해야 합니다.
EVA는 긴 영상 토큰을 얼마나 줄일까: SFT, KTO, GRPO와 탐색 지연
전체 영상을 보지 않고 어디를 다시 볼지 정한다
긴 영상에서 일정 간격으로 프레임을 뽑으면 짧은 사건을 놓치고, 모든 프레임을 넣으면 컨텍스트와 VRAM이 빠르게 늘어납니다. EVA는 Summary, Plan, Action, Reflection의 반복으로 이 문제를 바꿉니다. 먼저 낮은 비용으로 전체 윤곽을 잡고, 질문에 필요한 구간을 계획한 뒤 도구로 해당 구간을 보고, 증거가 부족하면 다시 탐색합니다.
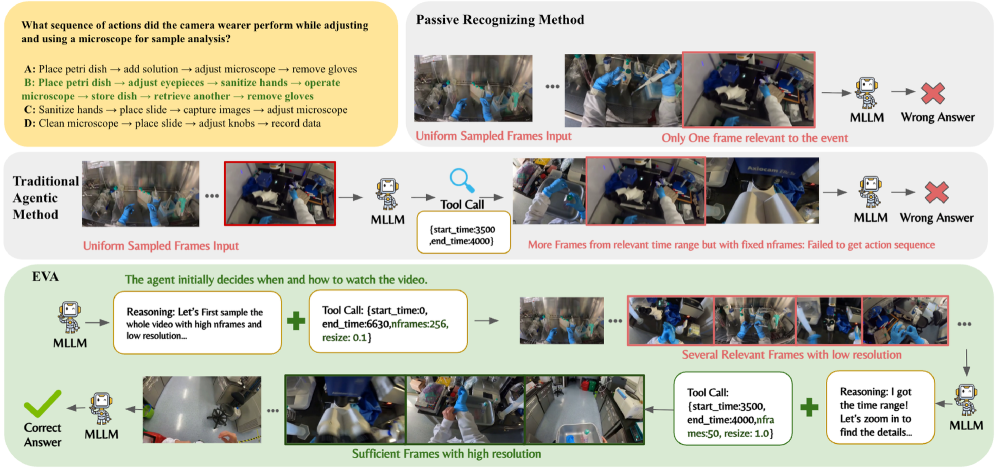
특징은 프레임 속도와 해상도를 고정하지 않는다는 점입니다. 긴 시간 범위를 훑을 때는 성기게 보고, 짧고 빠른 행동을 확인할 때는 fps나 해상도를 조절해 더 자세히 봅니다. 토큰을 시간 전체에 균등하게 쓰지 않고 불확실한 구간에 배분하는 셈입니다.
이 접근이 항상 적은 비용을 보장하지는 않습니다. 에이전트가 잘못된 구간을 반복해서 보면 한 번의 균일 샘플링보다 호출 수가 많아질 수 있습니다. 최대 탐색 횟수와 프레임 예산이 반드시 필요합니다.
세 단계 학습은 서로 다른 문제를 맡는다
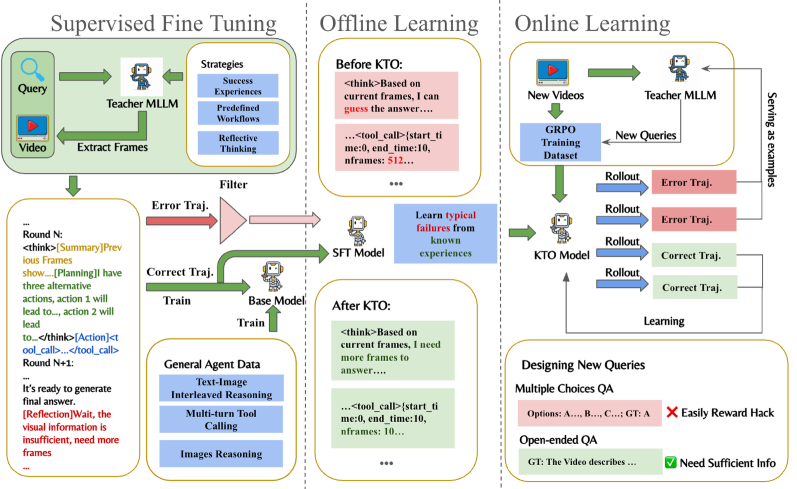
첫 단계 SFT는 합성 데이터로 도구 호출 형식과 기본 탐색 패턴을 가르칩니다. 모델이 어느 시간대를 어떤 해상도로 볼지 표현할 수 있어야 다음 최적화가 가능합니다.
KTO는 성공과 실패로 표시한 사례를 사용합니다. 원문은 DPO처럼 선호 쌍을 매번 만들지 않고도 잘못된 타임스탬프 탐색 같은 실패를 교정할 수 있다는 점을 강조합니다. 라벨이 간단해져도 성공 판정이 정확해야 한다는 전제는 남습니다.
마지막 GRPO는 여러 결과의 상대적 보상을 이용해 탐색 정책을 최적화하며, 원문은 별도의 무거운 value network 부담을 줄이는 선택으로 설명합니다. 이 세 단계는 설치 옵션이 아니라 학습 파이프라인입니다. 공개 모델을 추론에 쓰는 것과 자신의 영상 도메인으로 SFT→KTO→GRPO를 재현하는 일의 비용은 크게 다릅니다.
토큰 절감을 확인하는 실험 설계
원문에 제시된 도구 호출 JSON은 fps, resolution, 시간 구간을 동적으로 고르는 개념 예시이며 검증된 공개 API 스키마가 아닙니다. 실제 구현에는 비디오 디코더, 도구 반환 형식, 시간 좌표, 최대 프레임 수와 오류 처리가 필요합니다.
평가에서는 정답률만 보지 말고 다음을 함께 기록해야 합니다.
- 질문 하나당 읽은 총 프레임과 시각 토큰
- 탐색 라운드 수와 총 지연
- 처음 선택한 구간이 정답 증거를 포함한 비율
- 잘못된 구간에서 스스로 복구한 비율
- 프레임 추출과 모델 추론이 각각 차지한 시간
균일 샘플링과 같은 정확도에서 비교해야 토큰 절감이 의미가 있습니다. 세밀한 행동 질문과 장면 전체 요약 질문을 섞으면 평균값이 실제 장단점을 가릴 수 있으므로 유형별로 나눠야 합니다.
실시간 검색보다 비동기 분석에 가깝다
계획과 반성을 여러 번 수행하는 구조는 사용자가 즉시 답을 기다리는 경로에 불리합니다. 동시 요청이 늘면 반복되는 비전 토큰과 KV 캐시 관리도 복잡해집니다. 반면 장시간 영상에서 특정 사건을 찾거나 라벨을 만드는 비동기 작업은 몇 초의 추가 지연보다 읽는 프레임을 줄이는 이점이 더 클 수 있습니다.
도입 순서는 단순합니다. 먼저 고정 샘플링 기준선을 만들고, EVA에 라운드, 프레임 상한을 둔 뒤 같은 질문 세트로 정확도와 비용을 비교합니다. 이후 실패 사례가 특정 영상 도메인에 몰릴 때만 추가 학습을 검토합니다. 논문이 사용한 하이퍼파라미터와 자신의 데이터 분포가 다르면 학습 결과가 재현되지 않을 수 있다는 점도 예산에 포함해야 합니다.
EVA는 “긴 영상을 공짜로 이해하는 모델”이 아니라, 제한된 시각 토큰을 어디에 쓸지 학습한 에이전트입니다. 실시간성보다 탐색 효율이 중요한 업무에서 먼저 평가하는 것이 맞습니다.
질문 유형에 따라 탐색 전략이 왜 달라질까
“경기에서 첫 득점이 언제 나왔나”는 짧은 사건 위치를 찾아야 하고, “강의의 핵심 주제를 요약하라”는 전체 시간대를 골고루 봐야 합니다. 같은 성긴 요약에서 시작하더라도 첫 질문은 후보 구간을 좁혀 높은 fps로 다시 보고, 두 번째는 여러 구간의 대표 장면을 유지해야 합니다. 질문을 구분하지 않으면 에이전트가 모든 요청에 반복 확대를 하거나 전체 요약만 믿게 됩니다.
평가 세트는 순간 사건, 여러 구간을 연결하는 질문, 전체 요약과 사건 부재 질문으로 나눕니다. 사건이 없는 영상에서 답을 만들기 위해 끝까지 탐색하는지, 여러 구간의 증거가 필요한데 첫 후보만 보고 끝내는지도 확인합니다. 각 유형의 정확도와 읽은 프레임 수를 따로 봐야 적응형 샘플링의 이점이 어디에서 생기는지 알 수 있습니다.
시간 언어도 기준이 필요합니다. 모델이 “중반부”라고 계획한 값을 도구가 초 단위 구간으로 어떻게 바꾸는지, 영상의 가변 프레임률과 잘린 시작 시간이 좌표에 반영되는지 확인합니다. 타임스탬프 변환이 틀리면 추론은 맞아도 전혀 다른 장면을 보게 됩니다.
첫 구간 선택이 틀렸을 때 어떻게 복구할까
Reflection은 “증거가 부족하다”는 문장만 만드는 단계가 아니라 다음 탐색을 바꾸는 근거가 돼야 합니다. 직전 구간에 사건이 없었다면 인접 시간대로 넓힐지, 요약에서 다른 후보를 고를지, fps와 해상도를 바꿀지 명시합니다. 같은 구간을 같은 설정으로 반복하면 새 정보가 없으므로 루프를 중단해야 합니다.
복구 능력은 첫 선택을 의도적으로 틀리게 주는 대조 시험으로 볼 수 있습니다. 정답 사건과 먼 구간에서 시작한 뒤 몇 라운드 안에 근거를 찾는지, 잘못된 초기 요약을 수정하는지 기록합니다. 첫 선택이 항상 좋은 테스트만 사용하면 계획기의 오류가 전체 시스템에서 얼마나 위험한지 드러나지 않습니다.
에이전트의 확신만으로 종료하지 않는 편이 좋습니다. 최종 답에 사용한 프레임과 시간 구간을 남기고 질문의 핵심 사건이 실제로 보이는지 별도 검증기나 사람이 표본 확인합니다. 근거 프레임이 없거나 답과 맞지 않으면 추가 탐색보다 “찾지 못했다”고 끝낼 수 있어야 합니다.
SFT, KTO, GRPO의 품질을 어떻게 분리해 볼까
SFT 뒤에는 도구 형식이 유효한지와 시간 범위가 영상 안에 있는지를 먼저 봅니다. KTO를 더한 뒤에는 실패 예시와 비슷한 잘못된 구간 선택이 줄었는지 확인합니다. GRPO 뒤에는 최종 보상이 올랐는지뿐 아니라 더 많은 라운드와 프레임으로 점수를 산 것은 아닌지 비용을 비교합니다.
성공 라벨이 최종 답만 본다면 에이전트는 근거를 찾지 않고 일반 지식으로 맞히는 지름길을 배울 수 있습니다. 보상에는 답의 정오와 근거 시간대 일치, 프레임 예산과 유효한 도구 호출을 분리해 반영할 필요가 있습니다. 짧은 답을 맞혔지만 근거 구간이 틀린 궤적을 성공으로 넣으면 실제 영상 탐색 능력이 좋아졌다고 보기 어렵습니다.
도메인 학습 전에는 공개 모델을 그대로 사용한 기준선을 남깁니다. 추가 학습이 특정 카메라나 자막 표현을 외워 다른 영상에서 성능을 떨어뜨릴 수 있으므로 보지 못한 채널, 길이, 편집 스타일을 별도 평가합니다. 세 단계 중 어느 단계가 회귀를 만들었는지 알 수 있게 체크포인트별 같은 질문 세트를 실행합니다.
프레임 예산과 시간 예산은 어떻게 함께 제한할까
최대 라운드만 정하면 한 라운드가 지나치게 넓은 구간을 높은 해상도로 요청할 수 있습니다. 요청당 총 프레임, 총 시각 토큰, 디코딩 시간과 모델 호출 시간을 각각 제한합니다. 남은 예산을 상태에 넣으면 계획기가 다음 탐색을 줄일 수 있고, 예산을 넘으면 현재 근거와 불확실성을 반환하게 할 수 있습니다.
캐시도 비용에 영향을 줍니다. 여러 질문이 같은 영상을 탐색한다면 낮은 fps 요약과 이미 추출한 구간 특징을 재사용할 수 있습니다. 단, 영상 버전이나 프레임 추출 설정이 바뀌었을 때 오래된 캐시를 쓰지 않도록 키를 구성합니다. 캐시 적중 시간을 포함해 기준선과 비교하되 첫 질문의 실제 비용을 숨기지 않습니다.
실시간 경로에서는 최신 프레임을 기다리는 요구와 과거 구간 탐색이 충돌합니다. 라이브 영상에서 아직 저장되지 않은 구간을 다시 볼 수 있는지, 디코더가 동시 탐색을 감당하는지 별도 설계가 필요합니다. 논문의 긴 영상 질의 결과만으로 실시간 감시나 즉시 대응 성능을 가정하면 안 됩니다.
어떤 파일럿이면 도입 여부를 판단할 수 있을까
한 도메인의 실제 영상과 질문을 준비하고 균일 샘플링, 조밀한 전체 입력, EVA 탐색을 같은 정확도 목표로 비교합니다. 유형별 정답률, 근거 구간 회수율, 총 프레임, 토큰, P95 지연과 GPU 메모리를 남깁니다. 사람이 영상을 찾는 데 걸린 시간도 함께 보면 비동기 분석에서 자동화의 가치를 계산할 수 있습니다.
탐색이 특정 구간을 반복하거나 사건 부재 질문에서 항상 답을 만들어 내거나, 정확도를 유지하려면 조밀 입력보다 더 많은 프레임을 읽는다면 적용을 보류합니다. 반대로 짧은 사건과 다구간 질문에서 근거를 안정적으로 찾고 총비용을 줄인다면 해당 영상 유형에 제한해 배포할 수 있습니다.
운영 로그에는 질문, 선택 구간, fps, 해상도, 반성 이유와 종료 조건을 남깁니다. 최종 답만 저장하면 잘못된 답이 계획, 도구, 영상 인코딩 중 어디에서 시작됐는지 찾을 수 없습니다. EVA의 실용성은 정확한 답만이 아니라 제한된 예산 안에서 근거를 재현 가능하게 찾는지로 판단해야 합니다.
자료:
- [Github] https://github.com/wangruohui/EfficientVideoAgent
- Original Paper Link
함께 읽으면 이해가 이어지는 글
- Q-learning에서 DQN, Policy Gradient로 넘어가는 기준 — 상태, 행동 공간에 따라 Q-table에서 Q-Network, DQN으로 넘어가는 기준과 replay memory, target network, 확률 정책을 배우는 Policy Gradient의 차이를 설명합니다.
- SpatialScore가 왼쪽, 오른쪽 오류를 줄일까: 8만 쌍 보상모델의 범위 — 8만 쌍 이상의 공간 선호 데이터로 학습한 SpatialScore가 이미지 생성 모델을 평가, 개선하는 방식과, 보상 해킹, 학습 비용, 평가 범위를 점검합니다.
- FrozenLake Q-Learning이 자꾸 실패하는 이유: 탐험, 학습률, DQN까지 — FrozenLake 예제로 Q-Table의 갱신 원리를 짚고, 탐험과 활용의 균형, 할인율, 학습률이 왜 필요한지 설명합니다. 상태 공간이 커질 때 Q-Network와 경험 재생, 타깃 네트워크로 넘어가는 판단 기준도 함께…
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.