포스트

UniT는 Best-of-N보다 순차 편집이 나을까: 3.6회 학습, 4.7회 추론의 비용

UniT는 같은 수의 test-time image를 쓸 때 Best-of-N 후보를 독립적으로 뽑는 것보다 이전 결과를 검증하고 순차 수정하는 방식이 복합 지시를 더 잘 만족했다고 보고합니다. 다만 한 라운드마다 다시 생성, 검증해야 하므로 3.6회 학습 궤적에서 4.7회 추론으로 늘어난 능력은 품질 향상과 함께 지연, 과편집 위험도 키웁니다.
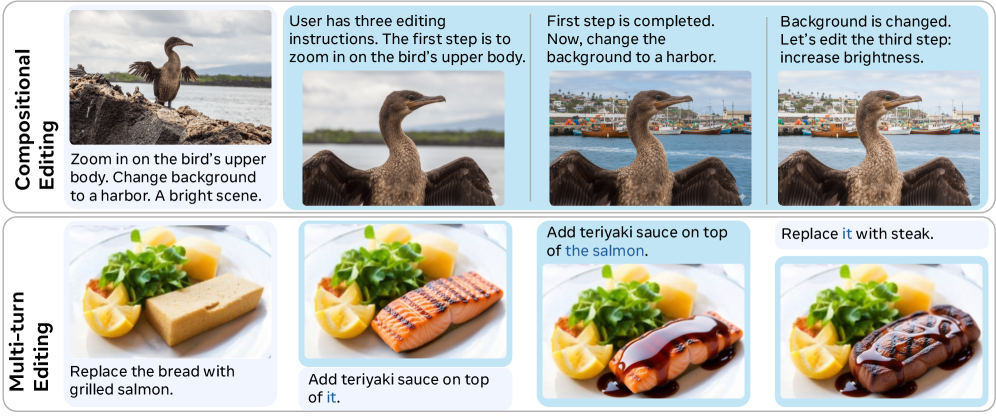
같은 이미지 예산에서 parallel sampling과 sequential CoT refinement를 비교한 UniT. 같은 이미지 예산에서 parallel sampling과 sequential CoT refinement를 비교한 UniT.
한 번에 만든 이미지가 조건을 빠뜨리면 어떻게 고칠까?

“공원에서 뛰는 강아지, 빨간 목줄, 뒤의 분수”처럼 조건이 여러 개면 single-pass 생성은 일부 속성이나 공간 관계를 놓칠 수 있습니다. 다시 처음부터 여러 장을 만들어 가장 나은 한 장을 고르는 Best-of-N은 각 후보가 같은 실수를 반복할 수 있습니다.

순차 편집은 첫 결과에서 목줄 누락을 찾고, 다음 라운드는 그 하위 목표만 수정합니다. 동시에 강아지와 배경의 identity를 memory로 유지해야 합니다. UniT가 test-time compute를 쓰는 방식은 후보 수를 늘리기보다 실패 정보를 다음 생성에 넘기는 것입니다.

Actor, Verifier, Planner는 어떻게 학습 궤적을 만들까?

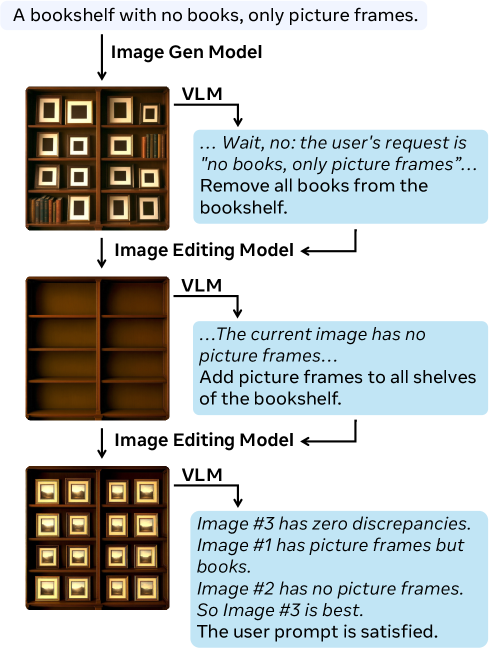
사람이 여러 단계의 수정 과정을 대량으로 labeling하기 어려워 세 모델이 합성 데이터를 만듭니다.

  1. Actor가 초기 이미지를 생성합니다.
  2. Verifier VLM이 prompt의 조건과 결과를 비교합니다.
  3. Planner가 누락, 오류를 하위 목표로 나누고 수정 지시를 씁니다.
  4. 검증이 통과할 때까지 결과와 지시를 이어갑니다.

생성, 검증, 계획을 반복해 multi-turn training trajectory를 만드는 과정. 생성, 검증, 계획을 반복해 multi-turn training trajectory를 만드는 과정.

UniT는 이미지 전후에 <thought> 형태의 planning text를 생성하도록 학습합니다. 중요한 것은 생각 문장의 길이가 아니라, 발견한 오류가 다음 editing instruction과 실제 결과 변화로 연결되는지입니다.

Verifier가 놓친 조건은 성공으로 잘못 종료되고, 존재하지 않는 오류를 지적하면 불필요한 편집 궤적이 데이터에 들어갑니다. 합성 loop의 상한이 verifier 품질에 묶이는 이유입니다.

3.6라운드 학습과 4.7라운드 추론은 무엇을 뜻할까?

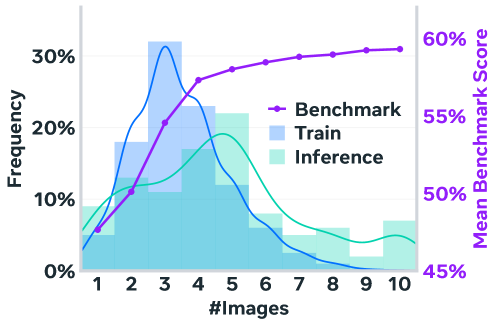
학습 trajectory는 평균 3.6 refinement round였고, test에서는 평균 4.7 round까지 수행했다고 설명합니다.

학습과 테스트에서 사용된 refinement round 분포. 학습과 테스트에서 사용된 refinement round 분포.

이는 학습 평균보다 긴 chain을 실행할 수 있다는 증거입니다. 그러나 4.7이 3.6보다 크다는 사실만으로 임의로 긴 reasoning에 zero-shot 일반화한다고 결론 내릴 수는 없습니다. round가 늘 때 성공률이 언제 포화되고 이미지가 언제 다시 나빠지는지가 필요합니다.

평균만으로 운영 비용도 정할 수 없습니다. 복잡한 요청의 P95 round, 각 round의 image generation 시간, verifier 호출 수를 함께 봐야 합니다.

순차 수정은 정답 외에 무엇을 유지해야 할까?

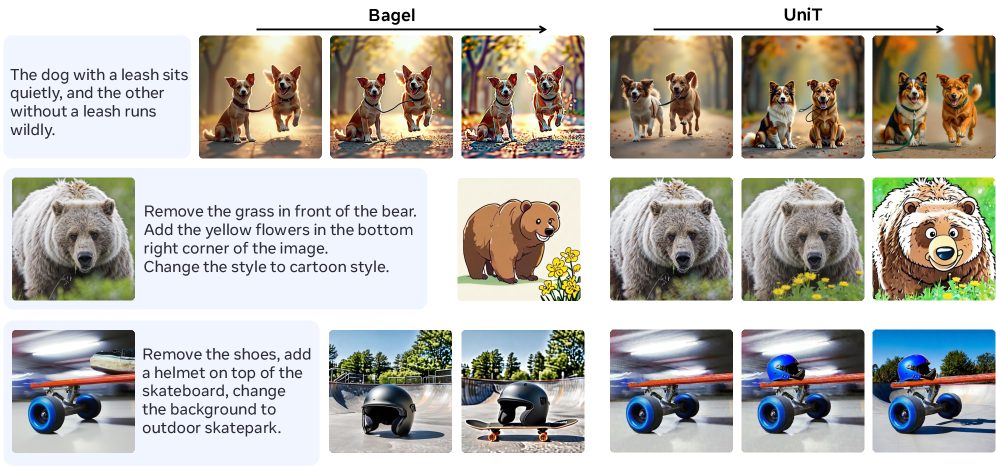
원문의 예시는 Bagel이 놓친 목줄 위치를 고치고, 곰과 skateboard의 identity를 여러 편집 동안 유지하며, artifact와 halo를 줄이는 사례를 보여줍니다.

조건 수정, subject consistency, 품질 보존의 정성적 사례. 조건 수정, subject consistency, 품질 보존의 정성적 사례.

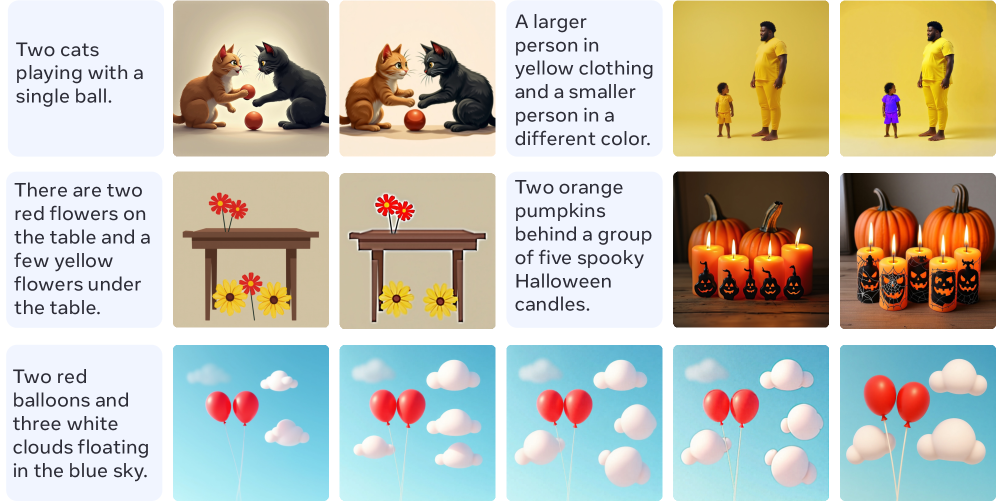
Compute budget에 따라 단계적으로 바뀌는 생성 결과. Compute budget에 따라 단계적으로 바뀌는 생성 결과.

이 글에는 benchmark별 절대 점수나 인간 평가표가 없습니다. CLIP, VLM score가 올라도 스타일, 심미성, 원본 보존이 좋아졌다고 자동으로 말할 수 없습니다. 매 라운드에는 최소한 prompt constraint 충족도, 수정 대상 외 영역의 변화, subject identity, artifact를 따로 평가해야 합니다.

더 편집할지 멈출지를 어떤 규칙으로 정할까?

UniT가 잘 맞는 과제는 여러 독립 조건을 순서대로 고칠 수 있고, 이전 결과를 보존하는 것이 중요한 편집입니다. 단순한 한 장 생성이나 응답 시간이 엄격한 서비스에서는 여러 round가 불필요할 수 있습니다.

실제 시스템에는 다음 중단 조건이 필요합니다.

  • 모든 필수 조건이 verifier threshold를 넘음
  • 두 라운드 연속 점수 개선이 없음
  • 최대 이미지 수, 시간, 비용에 도달
  • 수정 대상 밖 변화가 허용치를 초과
  • verifier들이 서로 모순된 판정을 냄

Sequential scaling의 장점은 계산을 많이 쓴다는 사실이 아니라, 이전 실패에 다음 계산을 집중한다는 데 있습니다. 어떤 오류가 더 이상 고쳐지지 않는지와 언제 멈춰야 하는지를 함께 설계하지 않으면 test-time scaling은 단순한 재생성 비용으로 바뀝니다.

Best-of-N과 공정하게 비교하려면 무엇을 고정할까?

순차 수정과 병렬 후보를 비교할 때는 최종 이미지 수만 같게 두는 것으로 충분하지 않을 수 있습니다. 순차 방식은 각 라운드마다 verifier와 planner를 호출하고 이전 이미지 문맥을 읽는 반면, Best-of-N은 후보를 독립 생성한 뒤 선택기를 사용합니다. 총 이미지 생성 횟수, VLM 호출 수, 입력, 출력 토큰, 벽시계 시간과 GPU 사용량을 함께 맞추거나 별도로 보고해야 계산 예산 대비 이득을 알 수 있습니다.

평가 prompt는 오류가 한 개인 사례와 여러 조건이 얽힌 사례를 나눕니다. 단순 생성에서는 병렬 후보 중 하나를 고르는 편이 빠를 수 있고, 목줄 위치, 동작, 배경처럼 독립 조건을 순서대로 고칠 수 있는 요청에서는 순차 방식이 유리할 수 있습니다. 두 집단을 평균 하나로 합치면 어떤 요청을 라우팅해야 하는지 알 수 없습니다.

편집이 좋아지다가 다시 무너지는 시점을 어떻게 찾을까?

각 라운드에서 전체 점수만 보지 말고 “이번에 고칠 조건”과 “보존할 조건”을 구분해 채점해야 합니다. 목줄을 고치며 강아지의 얼굴이 바뀌면 새 조건 점수는 올라도 결과 전체는 후퇴합니다. 수정 대상 밖의 픽셀, 주체 정체성, 스타일 변화가 허용치를 넘으면 이전 체크포인트로 되돌리고 다른 지시를 시도하는 rollback 규칙이 필요합니다.

Verifier가 성공이라고 말한 뒤에도 사람 평가나 독립 검증기로 표본을 다시 확인할 수 있습니다. 같은 verifier가 학습 trajectory를 만들고 배포 때 종료까지 판단하면 그 모델의 맹점이 반복됩니다. 서로 다른 검증기가 필수 조건에서 불일치하면 추가 편집보다 답을 보류하는 편이 낫고, 불일치 기록은 다음 학습 데이터의 우선 검수 대상으로 쓸 수 있습니다.

라운드별 개선 곡선도 중단 규칙을 정하는 근거가 됩니다. 첫 두 번은 조건 충족이 늘지만 이후에는 정체성과 화질이 떨어진다면 평균 4.7회라는 수치와 무관하게 해당 업무의 상한은 더 낮습니다. 요청 난도별로 개선이 멈추는 분포를 구해 최대 라운드를 다르게 두면 쉬운 사례에 불필요한 생성 비용을 쓰지 않습니다.

운영에서는 어떤 요청만 순차 편집으로 보낼까?

처음부터 모든 생성에 UniT식 loop를 쓰기보다 검증 가능한 복합 조건이 있고 수정 대상이 분리되는 요청을 우선 보냅니다. 광고 문구 위치, 제품 색, 인물 수처럼 체크 가능한 조건은 적합하지만, “더 아름답게”처럼 기준이 주관적인 요청은 verifier가 일관된 중단 신호를 주기 어렵습니다. 응답 시간이 엄격한 미리보기에는 single-pass를 주고 최종 산출물에만 순차 예산을 주는 방법도 있습니다.

운영 로그에는 각 라운드의 수정 지시, 조건별 점수, 되돌린 횟수와 종료 이유를 남깁니다. 성공률이 높아도 대부분 최대 라운드에서 끝나거나 rollback이 반복된다면 비용 구조가 불안정한 것입니다. 반대로 적은 라운드에서 누락 조건을 안정적으로 고치고 보존 점수가 유지된다면 순차 test-time scaling을 선택할 근거가 생깁니다.

사람 검토가 들어가는 제품에서는 모든 중간 이미지를 보여 주기보다 처음 결과, 가장 큰 개선이 있었던 결과, 최종 선택과 되돌린 이유를 묶어 제시할 수 있습니다. 사용자가 이미 만족한 요소를 잠그고 다음 편집 대상만 지정하게 하면 verifier가 주관적 선호를 대신 판단하는 범위를 줄입니다. 자동 중단과 사람의 승인 지점을 분리해 두어야 여러 라운드의 계산이 의도치 않은 최종 변경으로 이어지지 않습니다.

검토자가 최종본을 거절했을 때는 어느 라운드로 돌아갔는지 남겨 다음 중단 규칙을 조정해야 합니다. 반복되는 거절 원인이 같은 조건이라면 생성 횟수를 늘리기보다 해당 verifier의 판정 기준부터 고치는 편이 효율적입니다.

Original Paper Link

함께 읽으면 이해가 이어지는 글

THE END / OPSOAI

여기까지 읽었습니다

핵심 장면을 한 번 더 떠올려 보세요. 이해가 남았다면 이 책은 제 역할을 다했습니다.

다른 책 고르기
표지 1 —

←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.

CONTENTS

이 책의 목차

    9개 장 16 분읽는 시간