비디오를 실행 코드로 재현하게 하면 MLLM의 질량, 속도, 충돌 가설을 눈으로 검증할 수 있지만, 그 점수가 모델만의 물리 이해를 순수하게 측정하는 것은 아닙니다. 사용 가능한 API와 simulation backend가 올바른 역학을 대신 계산하므로, 장면 해석 능력과 도구 활용 능력이 함께 평가됩니다.
비디오를 코드로 재현하면 AI의 물리 이해를 검증할까: VisPhyWorld 209장면과 백엔드 편향
왜 객관식 정답보다 실행 코드가 더 많은 실패를 드러낼까?
기존 VQA는 “공이 어디로 움직이는가”를 고르게 할 수 있지만 모델이 궤적을 계산했는지 시각적 단서로 찍었는지 구분하기 어렵습니다. Violation-of-Expectation도 이상 장면을 찾는 능력은 보지만 모델이 믿는 물리 parameter를 직접 보여주지 않습니다.
VisPhyWorld는 관찰 영상을 재현할 코드를 요구합니다. 모델이 정해야 할 항목은 다음과 같습니다.
- 객체의 모양, 크기, 색과 초기 위치
- 질량, 속도, 가속도, 마찰과 반발 계수
- 중력과 경계 조건
- 시간에 따른 simulation과 rendering
코드가 실행되면 원본과 비교할 새 video가 나옵니다. 잘못된 충돌이나 속도가 결과에 나타나므로 자연어 설명보다 반례를 찾기 쉽습니다.
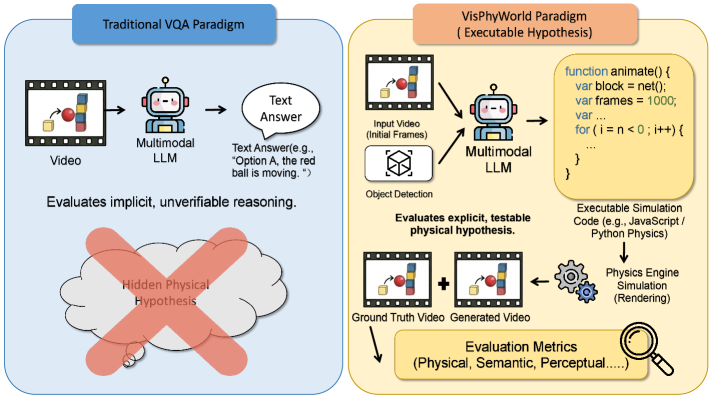 답을 선택하는 VQA와 executable reconstruction의 차이.
왜 Backend가 표현 도구이자 정답의 일부일까?
원문은 Three.js, P5.js 계열의 simulation backend와 SVG, Manim 같은 non-physics backend를 비교합니다. 물리 backend를 사용한 코드가 접촉과 강체 motion을 더 일관되게 재현했다고 설명합니다.
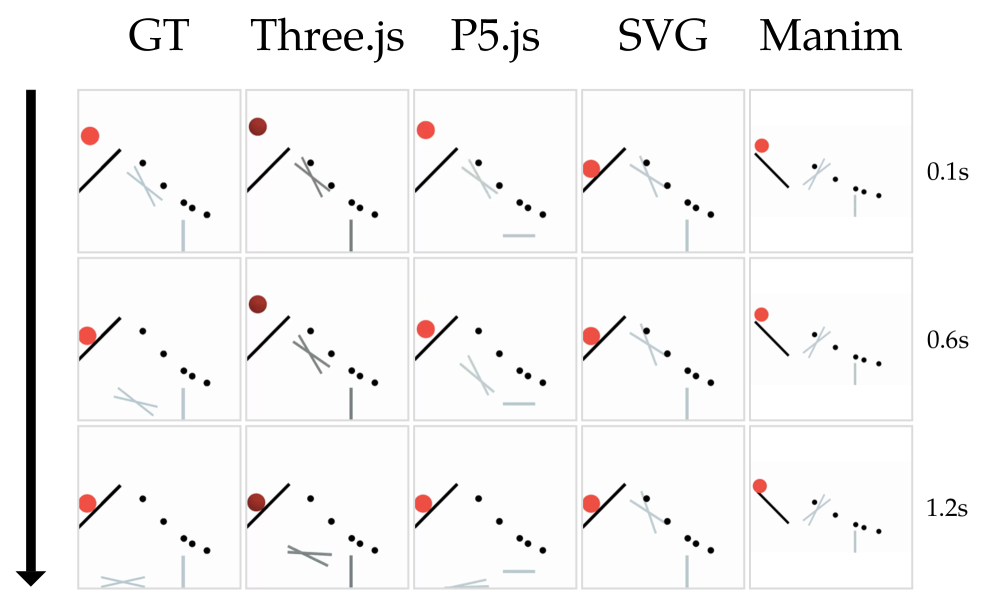 같은 입력에서 backend 종류에 따라 달라지는 collision과 motion.
이는 중요한 장점이면서 측정 혼합 요인입니다. 모델이 정확한 반발 계수를 추정했더라도 API 사용이 틀리면 실패하고, 반대로 parameter가 거칠어도 engine default가 그럴듯한 motion을 만들 수 있습니다. 지원하지 않는 유체나 연성체 현상은 모델이 이해해도 표현하지 못합니다.
따라서 결과는 최소 두 부분으로 나눠야 합니다.
- scene과 parameter를 영상에서 추정하는 능력
- 선택한 backend API로 그 가설을 정확히 구현하는 능력
이 글에는 전체 evaluator나 runnable reconstruction code가 포함돼 있지 않아, 구현 절차를 재현하려면 paper의 실제 code와 환경 사양이 별도로 필요합니다.
108개 템플릿과 209개 장면은 어디까지 평가할까?
VisPhyBench는 자유 낙하, 포물선 운동, 탄성 충돌, 경사면 운동 등을 포함한 108개 physical template와 209개 evaluation scene으로 구성됩니다. 원문은 PyBullet 등 simulator로 ground truth를 만들었다고 설명합니다.
평가는 세 축입니다.
| 지표 | 보는 것 | 사용 요소 |
|---|---|---|
| Appearance Score | 객체, 색, 위치 등 정적 장면 | DINOv2 embedding |
| Motion Score | 궤적과 속도 변화 | Dynamic Time Warping |
| Combined Score | 외형과 motion의 균형 | 두 점수의 조화 평균 |
Appearance가 높고 Motion이 낮으면 물체는 맞게 그렸지만 역학을 놓친 것입니다. Combined만 보면 이 차이가 숨겨질 수 있으므로 두 원점수를 함께 봐야 합니다. 209개 장면은 통제된 비교에는 유용하지만 복잡한 texture, camera motion, fluid, soft body가 많은 실제 영상 전체를 대표하지 않습니다.
모델은 왜 장면 인식과 동역학에서 다른 결과를 낼까?
원문은 GPT-4o와 “GPT-5(가칭/연구 단계)”가 appearance에는 강하지만 motion parameter에서 고전했다고 설명합니다. 정확한 GPT-5 version과 결과표가 이 글에는 없으므로 공개된 특정 모델의 확정 성능처럼 인용하면 안 됩니다.
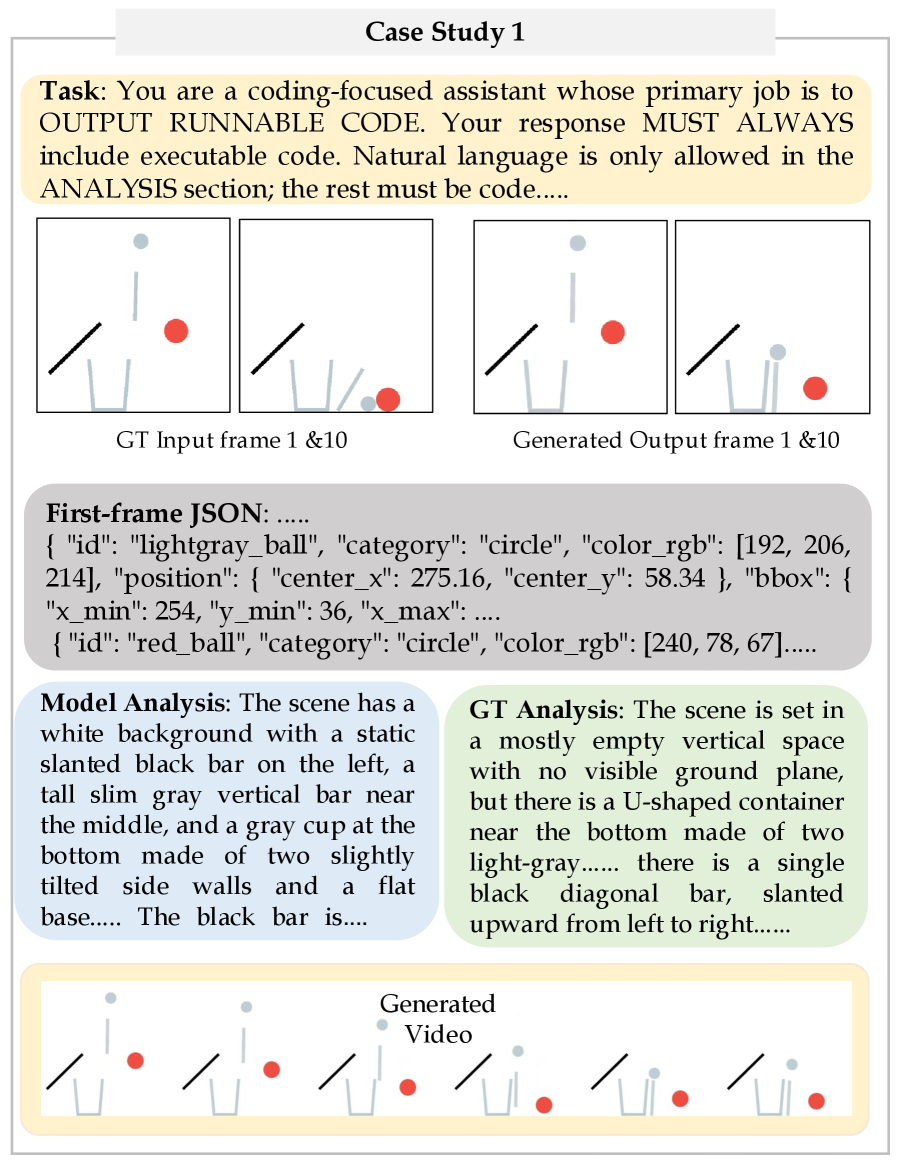 충돌 dynamics를 성공적으로 재현한 정성 사례.
SVD/img2vid와 Veo-3.1 같은 pixel-space baseline은 명시적인 physics hypothesis가 없어 장기 identity와 접촉에서 오류가 생기고, code 방식은 engine을 통해 더 일관된 trajectory를 만들었다고 보고합니다.
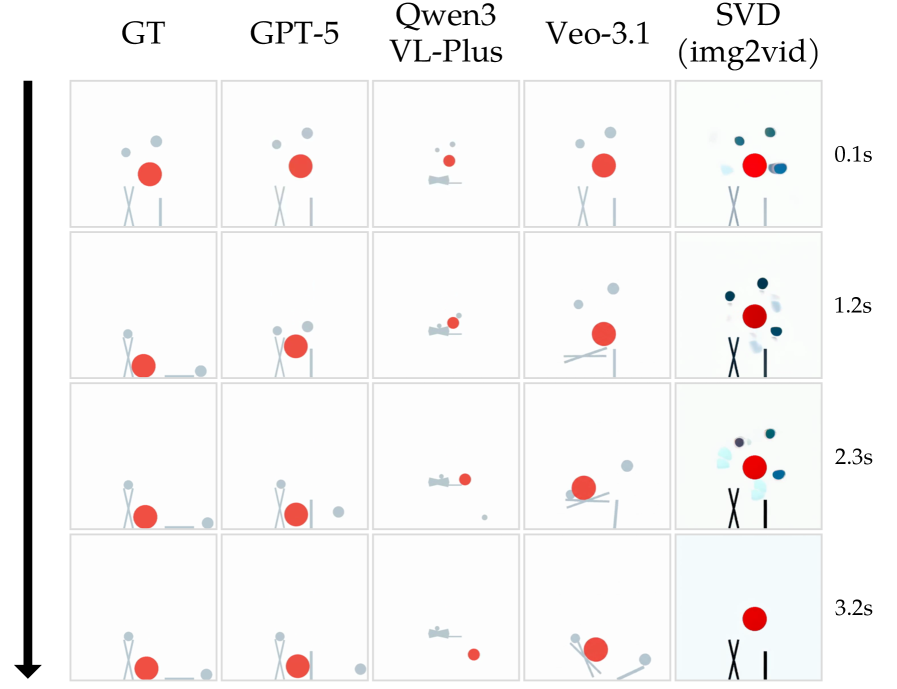 Code reconstruction과 pixel-space generation의 시간적 비교.
하지만 pixel generator와 simulator code는 출력 제약이 다릅니다. 한쪽이 사진처럼 보이는 자유도를 얻는 대신 물리 일관성을 잃고, 다른 쪽은 제한된 primitive와 engine 규칙으로 일관성을 얻습니다. 이 비교를 “code model이 video model보다 모든 면에서 낫다”로 읽을 수 없습니다.
물리 추론기로 쓰기 전에 어떤 반사실 검사를 더할까?
한 영상을 비슷하게 재현하는 parameter 조합은 여러 개일 수 있습니다. 질량과 힘을 함께 바꿔도 같은 궤적이 나오는 경우처럼 식별 불가능성이 남습니다. 단일 reconstruction score만으로 모델이 올바른 원인을 찾았는지 확인하기 어렵습니다.
평가를 강화하려면 생성 코드에서 한 parameter만 바꾸고 예상 방향으로 결과가 변하는지 확인합니다. 초기 속도, 중력, 마찰을 바꾼 반사실 rollout, 같은 법칙의 새 scene, backend를 바꿨을 때의 유지율을 기록할 수 있습니다. 코드 실행, 수정 loop의 시간과 실패율도 포함해야 합니다.
VisPhyWorld의 가치가 바로 digital twin이나 사고 원인 역산을 완성했다는 데 있는 것은 아닙니다. MLLM의 물리 가설을 실행 가능한 외부 표현으로 꺼내 반박할 수 있게 만든 데 있습니다. 실제 의사결정에는 단순 rigid-body benchmark를 넘어 parameter 식별성과 domain-specific simulator 검증이 추가되어야 합니다.
같은 장면을 여러 초기값으로 재구성해 코드와 parameter가 얼마나 안정적인지도 봐야 합니다. 결과 영상은 비슷하지만 질량, 마찰 값이 매번 크게 달라진다면 외형 재현에는 성공해도 원인 추론에는 쓰기 어렵습니다. 재현 점수와 parameter 일관성을 분리하면 가능한 사용 범위를 더 정확히 정할 수 있습니다.
생성 코드는 어떤 격리 환경에서 실행해야 할까?
VisPhyWorld는 모델이 만든 코드를 실제로 실행하므로 물리 점수와 별개로 실행 안전이 필요합니다. 허용한 simulation API만 쓸 수 있는 sandbox에서 네트워크와 파일 접근을 제한하고, CPU, GPU 시간과 메모리 상한을 둬야 합니다. 코드가 무한 반복되거나 지나치게 많은 객체를 만들어도 평가 서버 전체를 멈추지 않도록 timeout과 프로세스 격리가 필요합니다.
실행 실패도 모두 물리 추론 실패로 묶지 않는 편이 좋습니다. 문법 오류, 존재하지 않는 API, 단위 변환 오류, simulation은 실행됐지만 motion이 틀린 경우를 분리하면 모델이 장면을 잘못 읽었는지 도구 사용에 실패했는지 알 수 있습니다. 같은 장면 가설을 사람이 작성한 template에 넣었을 때 맞는 결과가 나오면 API 생성 단계가 병목이라는 근거가 됩니다.
Backend 편향은 어떤 교차 시험으로 줄일까?
한 engine에서 잘 맞은 parameter를 가능한 범위에서 다른 backend나 단순한 수치 계산으로 다시 실행해 봅니다. 결과가 크게 달라지면 모델의 가설보다 engine default와 접촉 처리에 의존했을 수 있습니다. 반대로 여러 구현에서 변화 방향이 일치하면 “마찰을 높이면 더 일찍 멈춘다” 같은 관계에 더 강한 근거가 생깁니다.
반사실 문제는 원본 장면과 한 조건만 다르게 만들어야 합니다. 초기 속도를 높였을 때 이동 거리가 늘어나는지, 반발 계수를 낮췄을 때 튀어 오르는 높이가 줄어드는지처럼 방향을 먼저 정하고 코드 결과를 검사합니다. 원본 영상과 닮은 결과 하나를 만드는 것보다 이런 변화에 일관되게 반응하는지가 물리 가설의 재사용 가능성을 더 잘 보여 줍니다.
실무에서는 Appearance, Motion, Combined 점수 옆에 코드 실행 성공률, parameter 분산, backend 간 결과 차이와 반사실 통과율을 둡니다. 외형 점수는 높지만 parameter가 매번 달라지거나 작은 조건 변화에 엉뚱하게 반응한다면 시각 재현 도구로는 쓸 수 있어도 원인 분석이나 제어에는 쓰기 어렵습니다. 어느 지표를 통과해야 다음 단계로 갈지 미리 정해야 그럴듯한 영상에 판단이 끌리지 않습니다.
함께 읽으면 이해가 이어지는 글
- 생성 영상의 배경과 움직임이 무너진다면: DreamWorld의 결합 월드 모델링 — DreamWorld가 시간, 공간, 의미 피처를 함께 맞추는 방식, CCA와 다중 소스 가이드, VBench 개선치와 물리 이해 주장 사이의 한계를 짚습니다.
- 화질 좋은 AI 영상이 물리 법칙은 틀리는 이유: RISE-Video 467개 Test — RISE-Video가 467개 human-annotated prompt로 영상 생성기의 상식, 공간 변화, 물리, 시간 인과를 평가하고, visual quality와 reasoning score가 갈리는 지점을 보여줍니다.
- Django 북마크 앱이 Admin에는 보이는데 화면에 안 뜰 때: 파일 연결 순서 — Django의 settings.py, models.py, admin.py, urls.py, views.py, templates가 어떤 순서로 연결되는지 북마크 앱으로 설명합니다. 앱 등록과 migration, URL include…
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.