포스트

RynnBrain 30B-A3B는 로봇에 충분히 가벼울까: 3B 활성 파라미터와 제어 지연

RynnBrain 30B-A3B는 token마다 약 3B parameter만 활성화해 dense 30B보다 연산을 줄이지만, 30B 전체 weight의 저장, memory 이동과 expert routing까지 3B 모델처럼 가벼워지는 것은 아닙니다. 로봇 배치 가능성은 benchmark 점수와 별도로 sensor-to-action 지연, control 주기와 안전 계층으로 확인해야 합니다.

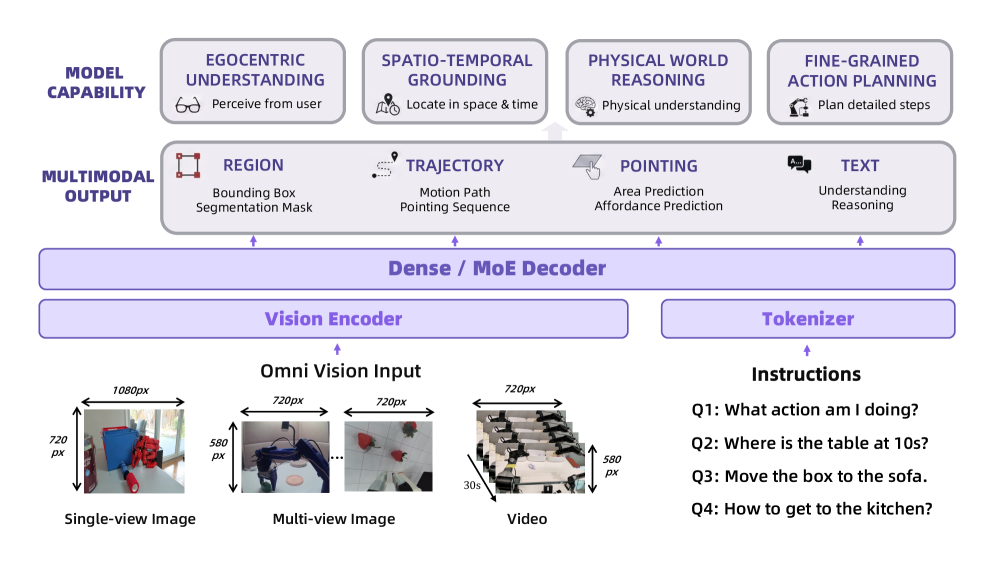
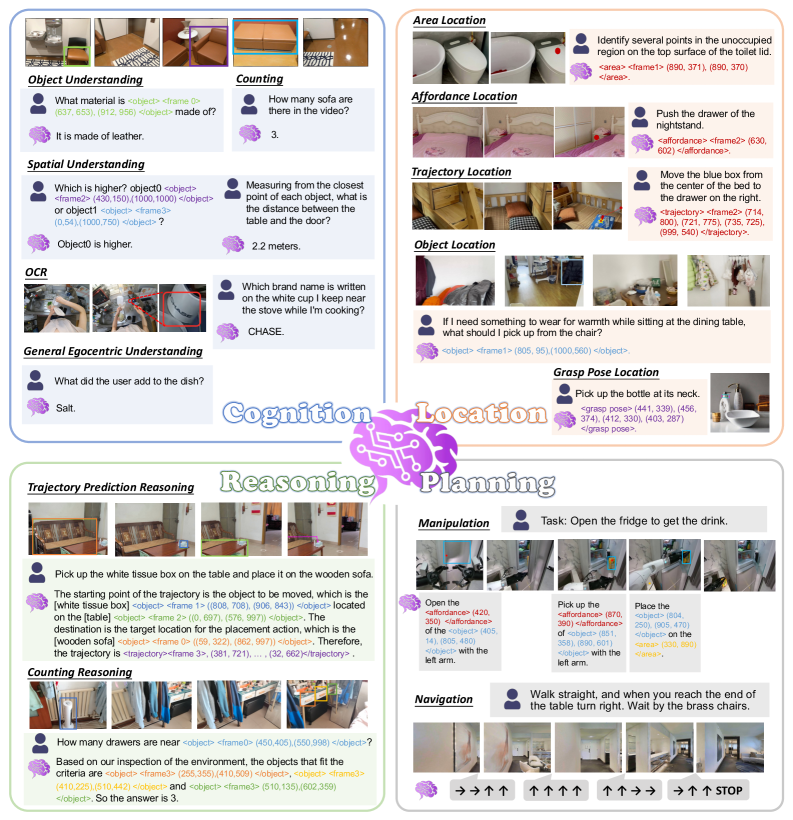
RynnBrain이 이미지, 비디오 입력에서 언어, point, box와 trajectory를 출력해 인지, 위치 추정, 물리 추론, 계획을 연결하는 구조도 RynnBrain이 묶는 egocentric cognition, localization, physical reasoning, planning.

왜 텍스트 답만으로는 로봇이 움직일 수 없을까?

Embodied model은 물체가 무엇인지 말하는 것뿐 아니라 어디에 있고, 시간에 따라 어떻게 움직이며, 어느 경로로 접근할지를 출력해야 합니다. RynnBrain은 single-view, multi-view image와 video, language instruction, spatio-temporal coordinate를 입력으로 받고 다음 grounding primitive를 text와 함께 생성합니다.

  • point와 bounding box
  • object region과 pointing signal
  • 시간에 따른 trajectory
  • 물리적 환경을 고려한 planning 결과

이 통합 출력 공간은 “오른쪽 컵을 왼쪽으로 옮겨라”라는 명령의 언어 의미와 위치, 경로를 같은 decoder에서 연결하려는 설계입니다. 좌표를 출력할 수 있다는 사실이 관절 한계와 충돌 회피를 자동 보장하지는 않습니다.

Dense 2B, 8B와 30B-A3B는 무엇이 다를까?

RynnBrain은 2B와 8B dense model, 전체 30B 중 약 3B가 활성화되는 MoE variant를 제공합니다. 원문은 embodied 목적에 맞춘 네 종류의 post-trained variant도 언급합니다.

Omni-vision 입력과 dense 또는 MoE decoder의 unified output. Omni-vision 입력과 dense 또는 MoE decoder의 unified output.

MoE는 모든 expert를 매 token마다 계산하지 않아 FLOPs를 낮춥니다. 그러나 다음 자원은 별개입니다.

항목3B active가 줄이는가
Expert 연산량주로 줄임
전체 30B weight 저장그대로 필요
GPU memory로의 weight 이동배치, routing에 따라 남음
Vision token 처리별도 encoder 비용
Expert 간 통신새 overhead가 될 수 있음
Sensor, actuator latency모델 외 시스템까지 포함해야 함

그래서 30B-A3B를 “3B처럼 edge device에서 실행”한다고 바로 결론 내릴 수 없습니다. 2B, 8B dense와도 같은 precision, hardware에서 종단 성능을 비교해야 합니다.

RynnBrain-VLA는 공간 출력을 action으로 어떻게 이을까?

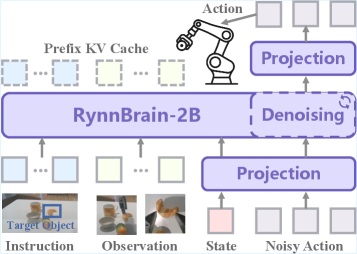
RynnBrain-VLA는 시각, 언어 표현을 robot manipulation과 navigation action에 연결하는 variant입니다.

Figure 3:RynnBrain-VLA architecture. RynnBrain-VLA의 robot arm 조작과 이동 제어 구조.

원문은 RT-2와 OpenVLA보다 강한 spatio-temporal pretraining을 바탕으로 세밀한 제어와 physics-aware planning을 수행한다고 설명합니다. 학습 데이터로 Isaac Gym, SAPIEN simulation, real robot video, text-image pair가 언급되고, 약 20개 embodied benchmark와 8개 일반 vision benchmark를 사용합니다.

하지만 “physics-aware”라는 이름과 실제 물리 안전은 다릅니다. 마찰, 무게 추정이 틀렸을 때 action을 중단하는 장치, control frequency, trajectory가 관절 명령으로 바뀌는 과정은 이 글에 구체적으로 제시되지 않습니다.

왜 21개 능력의 평균보다 위치 오차를 봐야 할까?

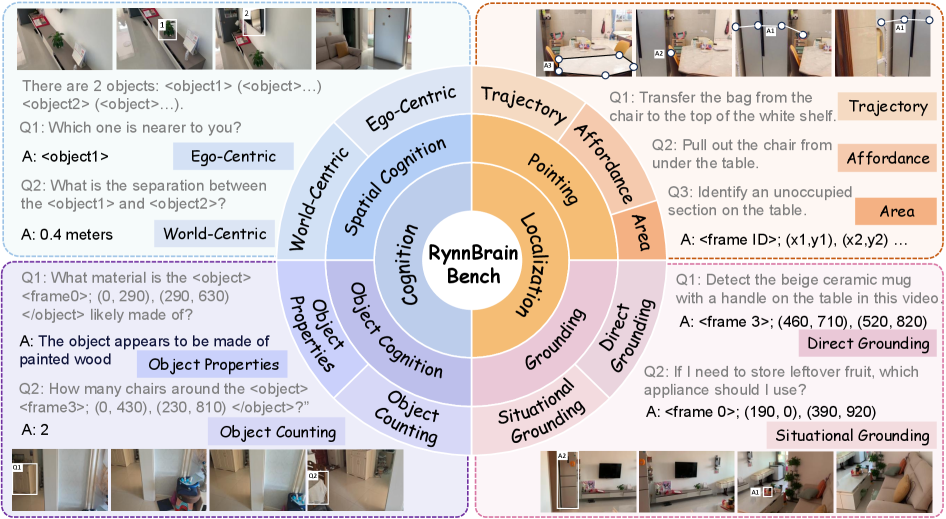
RynnBrain-Bench는 cognition과 location 아래 21개 spatio-temporal ability를 평가합니다.

인지와 위치의 21가지 세부 평가 차원. 인지와 위치의 21가지 세부 평가 차원.

원문은 기존 SOTA보다 큰 격차와 trajectory localization의 높은 precision을 설명하지만 model별 절대 수치, 좌표 단위의 오차, 긴 video 조건은 이 글에 없습니다. 다음 과제는 같은 평균으로 합치지 않는 편이 좋습니다.

  • 객체 이름과 scene reasoning
  • frame별 point, box localization
  • 미래 trajectory prediction
  • egocentric와 외부 view의 정렬
  • plan 생성과 실제 action 성공

그럴듯한 자연어 설명이 정확한 좌표를 가릴 수 있고, box가 맞아도 action trajectory가 위험할 수 있습니다. 출력 종류별 평가가 필요한 이유입니다.

로봇에 넣기 전 어떤 세 단계로 검증해야 할까?

첫 단계에서는 recorded video로 localization과 trajectory error를 측정합니다. 두 번째는 simulator에서 latency, collision, recovery와 out-of-distribution scene을 시험합니다. 마지막에만 저속, 제한된 공간의 real robot에 연결하고 independent safety controller를 둡니다.

오픈소스라는 장점도 weight만 공개됐는지, training data와 cleaning pipeline, VLA conversion code까지 재현 가능한지 구분해야 합니다. RynnBrain의 선택 포인트는 큰 model 하나로 모든 robot을 바로 제어한다는 데 있지 않습니다. text와 explicit spatial primitive를 한 framework에서 비교할 수 있고, dense와 MoE scale 중 업무에 맞는 계산, memory trade-off를 고를 수 있다는 데 있습니다.

3B 활성 모델의 실제 제어 예산은 어떻게 재야 할까?

모델 단독 토큰 생성 속도보다 카메라 입력부터 action 전송까지의 종단 지연을 측정해야 합니다. 한 주기는 영상 전처리, vision encoder, MoE routing과 decoder, 좌표를 로봇 명령으로 바꾸는 단계, 안전 검사로 구성됩니다. 어느 한 단계라도 control 주기보다 길면 3B만 활성화한다는 계산 이점이 실제 로봇 반응성으로 이어지지 않습니다.

같은 hardware와 precision에서 2B dense, 8B dense, 30B-A3B를 비교하고 평균뿐 아니라 P95 지연과 최대 memory를 남겨야 합니다. MoE는 요청마다 선택되는 expert가 달라 memory 이동과 지연 변동이 생길 수 있으므로 평균이 빠르더라도 느린 꼬리 구간이 제어 안정성을 해칠 수 있습니다. Batch throughput이 좋은 서버 결과를 한 대의 로봇에서 요청 하나씩 처리하는 지연으로 대신해서도 안 됩니다.

공간 출력이 안전한 action이 되려면 무엇이 더 필요할까?

Point, box, trajectory가 영상의 물체와 맞는지 먼저 확인하고, 그다음 로봇 좌표계로 변환했을 때의 위치 오차를 잽니다. 카메라 calibration이 조금만 틀려도 이미지의 정확한 point가 실제 공간에서는 물체 밖을 가리킬 수 있습니다. 관절 한계, 충돌, 속도 제한을 별도 controller에서 검사하고 모델 출력이 위반되면 중단해야 합니다.

시험 장면에는 물체가 가려진 경우, 학습에 없던 카메라 각도, 미끄러운 표면과 움직이는 사람을 포함합니다. 모델이 자연어로 확신 있게 계획을 설명해도 trajectory가 장애물을 통과하면 행동을 허용하지 않습니다. 센서 입력이 끊기거나 모델 응답이 control deadline을 넘었을 때 안전 자세로 전환하는 실패 정책도 성능 시험과 같은 수준으로 검증해야 합니다.

모델 선택은 평균 벤치마크가 아니라 임무 실패 비용에 맞춥니다. 단순한 물체 지시와 낮은 속도의 정리 작업에서는 2B dense가 충분할 수 있고, 복잡한 다중 장면 계획에서만 더 큰 모델이 값을 할 수 있습니다. 30B-A3B가 정확도를 높여도 전체 weight memory 때문에 배치 장비가 커지고 지연 꼬리가 늘면 edge robot에는 맞지 않을 수 있습니다. 과제별 성공률, 종단 지연, 안전 controller 개입률을 함께 비교해야 크기 선택이 가능합니다.

Original Paper Link
함께 읽으면 이해가 이어지는 글

THE END / OPSOAI

여기까지 읽었습니다

핵심 장면을 한 번 더 떠올려 보세요. 이해가 남았다면 이 책은 제 역할을 다했습니다.

다른 책 고르기
표지 1 —

←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.

CONTENTS

이 책의 목차

    8개 장 12 분읽는 시간