RD-VLA는 답을 설명하는 텍스트 토큰을 길게 생성하는 대신, 모델 내부의 액션 잠재 상태를 같은 코어로 여러 번 정제합니다. 이 구조는 파라미터를 늘리지 않고 추론 횟수를 조절할 수 있지만, 반복 횟수가 늘었다고 항상 더 안전한 행동이 나오는 것은 아닙니다. 핵심 판단점은 잠재 상태가 실제로 수렴하는지, 정지 기준이 어려운 장면을 너무 일찍 끝내지 않는지입니다.
RD-VLA는 로봇의 추론 깊이를 어떻게 조절하나: 잠재 반복과 정지 조건
RD-VLA가 해결하려는 고정 연산 문제는 무엇인가?
현대 로봇 공학의 가장 큰 화두는 Vision-Language-Action (VLA) 모델이 어떻게 실시간성(Real-time)과 복잡한 추론(Reasoning) 능력을 동시에 확보할 것인가 하는 점입니다. 기존의 VLA 모델들은 단순한 동작이나 복잡한 조작에 상관없이 동일한 계산 비용을 지불하는 고정된 구조를 가지고 있었습니다. 이는 자원이 제한된 로봇 환경에서 비효율적일 뿐만 아니라, 깊은 사고가 필요한 작업에서 성능의 한계를 드러냈습니다.
최근 공개된 Recurrent-Depth VLA (RD-VLA)는 이 문제에 잠재적 반복 추론(Latent Iterative Reasoning)을 적용합니다. 핵심은 텍스트 기반 Chain-of-Thought(CoT) 대신 잠재 공간에서 가중치를 공유하는 순환 코어로 계산 깊이를 조절하는 것입니다. 논문은 비교 설정에서 기존 CoT 기반 VLA 대비 최대 80배의 속도와 상수 수준의 메모리 점유를 보고하고, 일부 난도 높은 작업에서 반복 횟수에 따른 큰 성공률 변화를 제시합니다. 이 결과는 사용한 과제와 하드웨어, 기준선에 묶인 수치이므로 모든 로봇 환경의 일반적 배속으로 읽어서는 안 됩니다.
이 글에서는 구조를 구성 요소별로 해석하고, 보고 수치가 무엇을 비교했는지와 실제 로봇에 적용할 때 남는 실패 조건을 함께 살펴봅니다.
텍스트 CoT를 로봇 액션에 그대로 쓰기 어려운 이유는 무엇인가?
고정된 계산 비용의 딜레마
기존의 RT-2나 OpenVLA와 같은 모델들은 트랜스포머 아키텍처를 기반으로 하며, 입력 데이터가 모델을 통과할 때 정해진 수의 레이어를 거치게 됩니다. 이는 ‘팔을 1cm 이동하라’는 단순한 명령과 ‘여러 장애물을 피해 컵을 집어라’라는 복잡한 명령에 대해 똑같은 에너지를 소비한다는 뜻입니다. 인간이 쉬운 일은 직관적으로(System 1), 어려운 일은 숙고하여(System 2) 처리하는 것과는 대조적입니다.
CoT의 한계: 연속적 액션 공간의 부적합성
언어 모델에서 성능을 높이는 ‘테스트 시간 계산량 확장(Test-time Compute Scaling)’ 기술로 Chain-of-Thought(CoT)가 주목받아 왔습니다. 하지만 로보틱스 분야에서 CoT를 적용하는 데는 두 가지 치명적인 문제가 있습니다.
- 메모리 폭발: 추론 토큰이 길어질수록 KV 캐시가 선형적으로 증가하여 로봇의 온보드 메모리를 압도합니다.
- 연속적 데이터 처리의 어려움: 텍스트와 달리 로봇의 액션은 연속적인 수치(Continuous action space)로 표현되는 경우가 많아, 이를 토큰화하여 문장처럼 생성하는 방식은 비효율적이고 정밀도가 떨어집니다.
RD-VLA 연구진은 바로 이 지점에서 질문을 던졌습니다. “토큰을 생성하지 않고도 모델 내부의 잠재 상태를 반복적으로 정제(Refinement)함으로써 사고의 깊이를 더할 수는 없을까?”
잠재 반복 코어는 액션을 어떻게 정제하나?
RD-VLA의 핵심은 모델의 깊이를 물리적 레이어의 수가 아닌, ‘순환 횟수(Iterations)’로 정의한 것입니다.
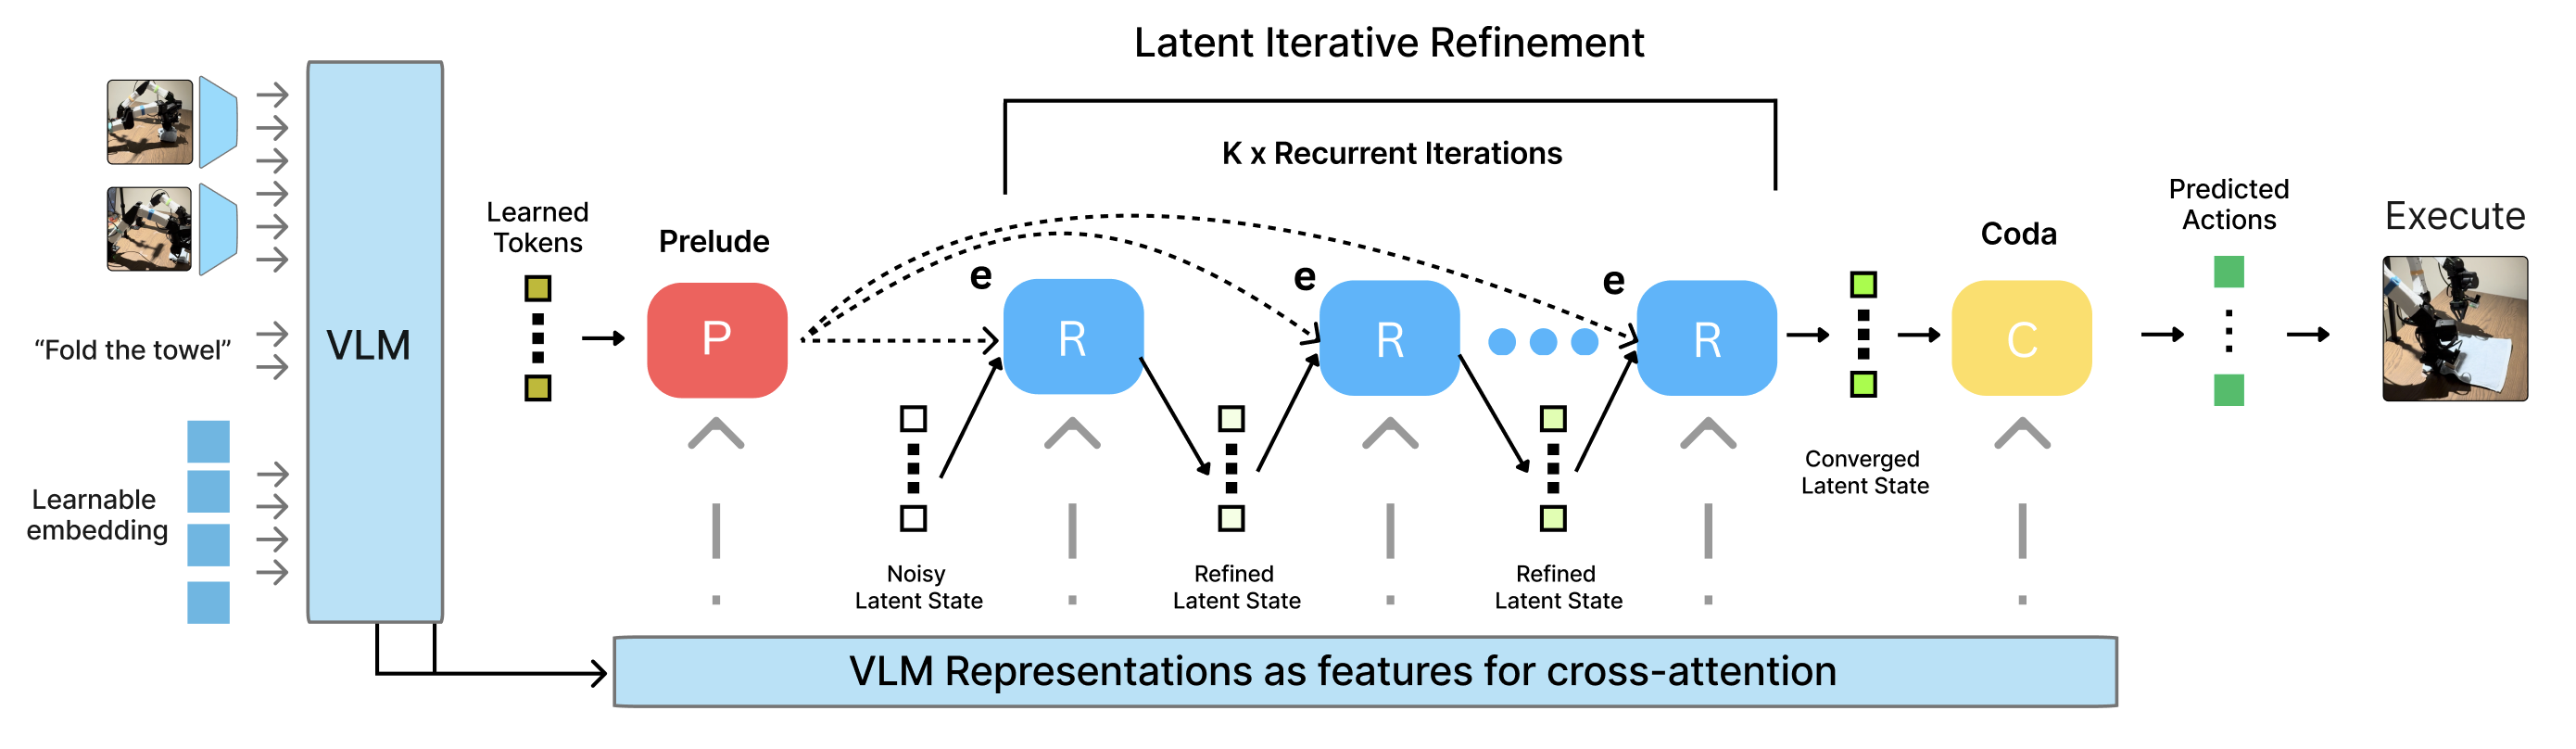 그림 1: RD-VLA의 아키텍처 구조. 서사(Prelude), 순환 코어(Recurrent Core), 종결(Coda)의 3단계로 구성된다.
1) 구조적 구성 요소
RD-VLA는 크게 세 부분으로 나뉩니다.
- Prelude (P): 학습된 쿼리(Learned Queries)를 VLM의 중간 레이어 특징(Features)에 크로스 어텐션(Cross-attention)시켜 초기 맥락을 파악합니다.
- Recurrent Core (R): 가중치가 고정된(Weight-tied) 트랜스포머 블록입니다. 여기서 ‘Noisy Latent Scratchpad’라고 불리는 잠재 상태가 반복적으로 업데이트됩니다. 매 반복마다 VLM의 최종 출력과 로봇의 현재 상태(Proprioception)를 참조하여 액션을 정교화합니다.
- Coda (C): 충분히 수렴된 잠재 상태를 최종적인 로봇 액션(Action chunk)으로 디코딩합니다.
2) 잠재적 반복 정제 (Latent Iterative Refinement)
핵심 선택은 가중치 공유(Weight-sharing)입니다. 서로 다른 레이어를 계속 쌓는 대신 같은 코어를 반복 사용하므로 파라미터 수와 반복 깊이를 분리할 수 있습니다. 다만 깊이를 “무한히” 늘릴 수 있다는 뜻은 아닙니다. 반복할수록 지연 시간은 늘고, 잠재 상태가 진동하거나 잘못된 방향으로 수렴할 가능성도 확인해야 합니다. 고정점 반복과 비슷한 직관은 주지만 수렴이 자동 보장되지는 않습니다.
3) TBPTT를 이용한 학습
반복적인 구조를 안정적으로 학습시키기 위해 연구진은 Truncated Backpropagation Through Time (TBPTT)을 사용했습니다. 이는 RNN 학습에서 주로 쓰이는 기법으로, 잠재 상태가 반복을 거듭할수록 정답 액션에 가까워지도록 유도합니다. 특히 학습 시 ‘Noisy Scratchpad’ 기법을 통해 초기값에 대한 강건성(Robustness)을 확보한 점이 인상적입니다.
4) 적응적 정지 기준 (Adaptive Stopping Criterion)
모든 작업에 풀 파워(Full iterations)를 쓸 필요는 없습니다. RD-VLA는 잠재 상태의 변화량(Cosine similarity 등)을 모니터링하여, 상태가 더 이상 변하지 않고 수렴했다고 판단되면 즉시 추론을 멈춥니다. 이는 실시간 제어가 중요한 로봇 환경에서 매우 효율적인 자원 배분을 가능하게 합니다.
실험 수치는 어떤 조건 안에서 읽어야 하나?
연구팀은 RD-VLA를 검증하기 위해 OpenVLA를 백본으로 사용하고, LIBERO 벤치마크 및 다양한 조작 작업(Manipulation tasks)에서 실험을 진행했습니다.
- 데이터셋: 로봇 조작 데이터인 LIBERO-100 및 실제 환경의 데이터.
- 비교군: 고정된 깊이의 VLA, CoT 기반 VLA, 그리고 일반적인 트랜스포머 기반 에이전트.
- 하드웨어: 로봇의 실시간성을 테스트하기 위해 NVIDIA Jetson과 같은 엣지 디바이스 환경을 고려한 벤치마킹 수행.
핵심 실험은 추론 시 반복 횟수(K)를 늘릴 때 성공률이 어떻게 변하는지 측정합니다. 이는 잠재 상태 정제가 해당 과제에서 테스트 시간 계산량을 활용할 수 있다는 근거입니다. 로봇 액션 전반에서 “생각할 시간을 주면 반드시 좋아진다”는 보편 법칙을 증명한 것은 아닙니다. 반복별 성공률과 함께 제어 주기, 지연, 에너지, 실패 유형을 같이 봐야 합니다.
80배와 90% 수치는 무엇을 비교한 결과인가?
논문이 보고한 결과는 비교 조건을 나눠 읽어야 합니다.
- 동적 성능 향상: 단일 반복(K=1)에서는 성공률이 0%에 가깝던 복잡한 작업들이 반복 횟수를 4회(K=4)로 늘리자 성공률 90%를 상회했습니다. 이는 모델이 물리적인 레이어 추가 없이 오직 ‘시간’을 더 투자함으로써 난제를 해결할 수 있음을 의미합니다.
- 효율성 (Speed vs. Memory): 기존의 토큰 기반 CoT 모델이 추론 단계에서 선형적인 메모리 증가를 보인 것과 달리, RD-VLA는 상수 메모리(Constant Memory)를 유지했습니다. 또한, 텍스트 생성을 기다릴 필요가 없어 기존 CoT-VLA 대비 최대 80배 빠른 속도를 기록했습니다.
- 적응적 추론: 쉬운 작업에서는 평균 1.2회의 반복만으로 작업을 완수하여 에너지를 절약한 반면, 어려운 작업에서는 평균 3.5회 이상의 반복을 수행하며 신중함을 보였습니다.
따라서 단일 최고 수치보다 반복 횟수별 성공률 곡선과 실제 제어 주기를 함께 보는 편이 타당합니다. 쉬운 과제에서 반복을 줄인 이점과 어려운 과제에서 추가 반복이 만든 지연을 같은 표에서 비교해야 합니다.
어떤 작업에서 시험할 가치가 있나?
RD-VLA의 반복 정제는 관측을 다시 해석하거나 미세 조정할 여지가 있는 작업에서 시험할 수 있습니다. 아래는 가능한 평가 시나리오이지 논문이 곧바로 상용 안전성을 입증한 사례는 아닙니다.
- 정밀 제조 및 조립: 부품을 끼워 맞추는 작업처럼 미세한 조정이 반복적으로 필요한 공정에서 RD-VLA는 잠재적 정제를 통해 오차를 줄일 수 있습니다.
- 물류 및 분류: 컨베이어 벨트 위의 물건이 겹쳐 있거나 복잡한 상황일 때만 ‘더 깊이 생각’하고, 평시에는 빠르게 움직이는 가변 속도 제어가 가능해집니다.
- 가정용 서비스 로봇: 냉장고에서 깨지기 쉬운 달걀을 꺼낼 때와 플라스틱 물통을 꺼낼 때의 사고 수준을 조절하여 배터리 수명을 연장하고 안전성을 높일 수 있습니다.
- 의료 로봇 연구: 미세한 변화에 따라 동작을 보정하는 연구 가설을 검토할 수 있지만, 별도의 안전 검증 없이 수술 보조에 적용할 수 있다는 뜻은 아닙니다.
반복 추론은 어디서 실패할 수 있나?
하지만 이 모델이 완벽한 것은 아닙니다. 다음과 같은 비판적 시각이 필요합니다.
- TBPTT의 학습 불안정성: 순환 구조는 본질적으로 그라디언트 소실(Vanishing)이나 폭주(Exploding) 문제에 취약합니다. 가중치를 공유하는 구조에서 복잡한 조작의 모든 케이스를 커버할 수 있을 만큼 가중치가 풍부한(Expressive)지는 여전히 의문입니다.
- 적응적 정지의 신뢰성: 모델이 스스로 ‘충분히 생각했다’고 판단하는 기준이 잘못될 경우, 위험한 환경에서 로봇이 성급하게 행동할 위험이 있습니다. 이 stopping criterion에 대한 안전성 보증(Safety guarantee) 메커니즘이 보완되어야 합니다.
- Backbone VLM 의존성: 결국 RD-VLA의 성능 상한선은 기반이 되는 VLM(OpenVLA 등)의 시각적 이해력에 갇혀 있습니다. 시각적 특징 자체가 부정확하다면 아무리 반복 추론을 해도 결과는 개선되지 않는 ‘Garbage In, Garbage Out’의 위험이 있습니다.
도입 여부는 어떤 지표로 결정하나?
RD-VLA는 더 큰 모델을 만드는 문제와 별도로 연산 자원을 과제 난도에 따라 배분하는 방법을 제시합니다. 잠재 상태 반복은 텍스트 CoT보다 액션 표현에 직접 연결되고 메모리 증가를 억제할 여지가 있다는 점에서 의미가 있습니다.
도입 실험에서는 평균 성공률만 보지 말고 K별 지연과 성공률, 조기 정지 오류, 수렴하지 않은 비율, 관측 오류가 반복으로 증폭된 사례를 기록해야 합니다. 고정 깊이 기준선보다 같은 지연 예산에서 안정적으로 나아지고, 실패 시 안전 정지 장치가 작동할 때만 실제 제어 경로에 넣을 근거가 생깁니다.
함께 읽으면 이해가 이어지는 글
- RynnBrain 30B-A3B는 로봇에 충분히 가벼울까: 3B 활성 파라미터와 제어 지연 — 30B 중 3B만 활성화하는 RynnBrain MoE의 계산 이득과 전체 가중치 메모리, 라우팅, 실시간 제어의 남은 비용을 구분합니다.
- MA-EgoQA는 로봇 6대의 영상을 함께 이해할까: 7일 기억과 EgoMAS 검색 — 여섯 에이전트의 7일치 1인칭 영상에서 질문에 답하는 MA-EgoQA와, Agent별 검색, 공유 Memory를 쓰는 EgoMAS의 정확도, 연산 한계를 정리합니다.
- 로봇은 언제 되물어야 하나: VL-LN Bench의 질문 비용과 성공률 — 모호한 물체 탐색에서 질문 행동을 추가한 IION, 4만 1천 궤적, SR, SPL과 질문 횟수를 함께 읽는 법
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.