DynamicVLA는 0.4B 경량 모델만으로 동적 조작을 해결한 것이 아니라, 로봇이 현재 행동을 실행하는 동안 다음 행동을 계산하고 오래된 action chunk를 폐기하는 실행 구조까지 함께 설계해 20Hz 이상 제어와 80% 이상 성공률을 목표로 합니다. 따라서 모델 크기만 줄여서는 같은 결과가 나오지 않으며, 추론, 실행의 시간 정렬이 핵심입니다.
DynamicVLA는 0.4B로 움직이는 물체를 80% 잡을까: 20Hz Action Streaming 검증
움직이는 물체에서는 정확한 과거도 오답이 된다
정적인 집기에서는 카메라를 보고 계획한 뒤 팔을 움직여도 대상 위치가 크게 달라지지 않습니다. 컨베이어나 다른 로봇 팔이 물체를 옮기는 상황에서는 수백 ms 전의 정확한 좌표가 현재는 틀릴 수 있습니다. 기존 stop-and-go 제어에는 세 가지 지연이 겹칩니다.
- 행동을 계산하는 동안 실행이 멈춥니다.
- 현재 chunk를 끝낸 뒤에야 새 관측을 반영합니다.
- 추론이 끝났을 때 결과가 어느 시점의 상태를 기준으로 했는지 어긋납니다.
DynamicVLA는 이 문제를 더 큰 언어 모델의 추론으로 풀기보다 작은 백본, action expert, 비동기 실행기로 나눕니다.
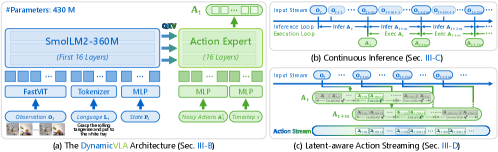 0.4B VLA, Continuous Inference, Latent-aware Action Streaming의 결합.
Continuous Inference는 지연을 없애지 않고 겹친다
0.4B 아키텍처는 원문에서 convolutional vision encoder와 action expert의 조합으로 설명됩니다. 무거운 백본보다 한 번의 추론을 짧게 만들고, action expert가 시각, 언어 특징을 연속 제어값으로 옮깁니다.
Continuous Inference는 한 단계 더 나아갑니다. 로봇이 현재 action chunk를 실행하는 동안 다음 관측에 대한 추론을 병렬로 진행합니다. 추론과 실행을 직렬로 더하지 않으므로 로봇이 계산을 기다리며 멈추는 구간을 줄입니다.
그러나 파이프라이닝은 느린 추론을 사라지게 하지 않습니다. 계산 시간이 action chunk보다 길어지면 새 결과가 제때 도착하지 않고, 너무 긴 chunk를 쓰면 물체의 궤적 변화에 늦게 반응합니다. 20Hz를 평가할 때는 평균 FPS보다 제어 마감 초과율과 최악 지연이 더 중요합니다.
Latent-aware Action Streaming이 오래된 행동을 버리는 법
동시에 여러 action chunk가 준비되면 단순히 생성 순서대로 실행할 수 없습니다. 새 관측에서 만든 chunk가 도착했는데 이전 관측의 잔여 행동을 계속 수행하면 로봇은 이미 지나간 위치로 향합니다.
Latent-aware Action Streaming은 시간적으로 낡은 행동을 무효화하고 가장 최근 chunk의 행동을 우선합니다. 이때 확인할 위험은 전환의 매끄러움입니다. chunk를 자주 교체하면 최신 상태는 반영하지만, 관절 명령이 갑자기 바뀌어 떨림이나 불안정이 생길 수 있습니다. 반대로 오래된 chunk를 너무 오래 유지하면 안정적이지만 반응성이 떨어집니다.
배치 로그에는 최소한 다음 시간이 같은 기준으로 남아야 합니다.
- 카메라 프레임 획득 시각
- 해당 프레임의 추론 시작, 완료 시각
- action chunk의 유효 구간
- 실제 관절 명령이 실행된 시각
- 오래되어 폐기된 행동의 비율
이 정보가 있어야 실패가 인식 오류인지, 추론 지연인지, chunk 선택 오류인지 구분할 수 있습니다.
20만 시뮬레이션과 2천 실물 episode의 구성
동적 조작 데이터가 부족해 연구진은 자동 수집 파이프라인과 DOM(Dynamic Object Manipulation) 벤치마크를 구축했습니다. 시뮬레이션에는 20만 개 이상의 episode, 2.8K 장면, 206종 객체가 포함되고 직선, 곡선, 불규칙 움직임을 다룹니다.
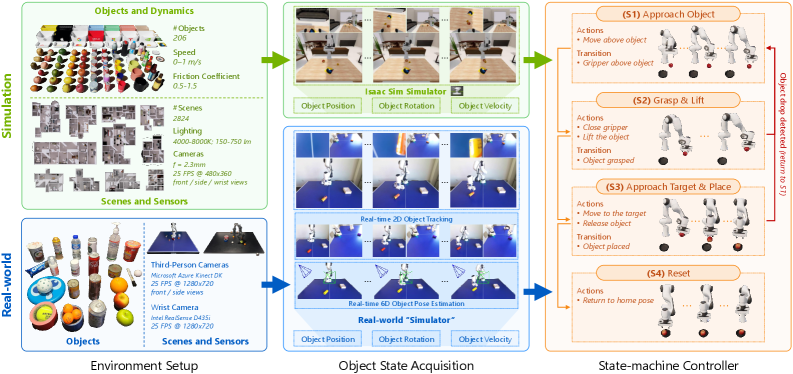 시뮬레이션과 실세계에서 approach, grasp, place, reset을 공유하는 자동 데이터 수집.
실세계에서는 synchronized multiview RGB 관측을 “실세계 simulator” 인터페이스로 바꿔 teleoperation이나 ground-truth sensor 없이 2,000개 데이터를 자동 수집했다고 설명합니다. 네 단계 state-machine controller가 접근, 집기, 놓기, 초기화를 수행합니다.
자동화는 규모를 키우지만 controller가 성공할 수 있는 궤적에 데이터가 몰릴 수 있습니다. 실제 물체의 마찰, 조명, 가림과 예상 밖 충돌은 20만 episode라는 숫자만으로 덮이지 않습니다.
80% 성공률을 읽을 때 볼 실험 조건
실물 평가는 Franka와 PiPER에서 여섯 개 동적 조작 과제를 사용합니다. 보조 로봇 팔이 물체 움직임을 만들고, 세 가지 motion-position 조합마다 20회 시험한 성공률을 평균합니다.
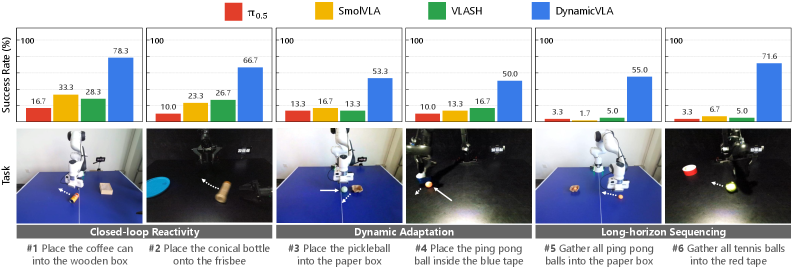 Franka와 PiPER의 여섯 동적 과제에서 진행한 실물 상호작용 평가.
원문은 기존 모델의 10~20% 성공률에 비해 DynamicVLA가 80% 이상을 기록하고, 20Hz 이상의 제어 빈도를 유지했다고 설명합니다. 이 차이는 크지만 시험의 물체 이동이 보조 팔로 생성됐다는 조건을 함께 봐야 합니다. 벽에 튀거나 불규칙하게 구르는 물체처럼 chaotic dynamics까지 같은 수준으로 일반화됐다는 뜻은 아닙니다.
PoC에서는 속도, 가속도, 가림을 단계별로 늘리고 다음을 따로 측정해야 합니다.
- 물체를 보지 못한 실패와 늦게 도착한 실패
- 새 객체와 새 궤적의 성공률
- action chunk 교체 직후의 흔들림
- 20Hz에서 마감 초과와 안전 정지
- Sim2Real 조건 변화에 따른 성능 하락
0.4B는 복잡한 언어 지시에서는 7B 이상 모델보다 용량이 부족할 수 있습니다. DynamicVLA가 보여주는 선택은 모든 추론을 작은 모델로 대체하자는 것이 아니라, 빠른 폐루프 제어가 필요한 구간에서는 최신 관측과 행동의 시간 정렬을 우선하자는 것입니다.
세 구성 요소의 기여를 어떻게 분리할까
같은 checkpoint에서 동기 실행, Continuous Inference만 적용, Action Streaming까지 적용한 세 조건을 비교하면 성공률이 model size, pipeline, chunk policy 중 어디서 오는지 알 수 있습니다. 각 조건은 같은 camera rate와 action horizon을 써야 합니다.
물체를 놓친 frame에서는 perception confidence가 낮아졌는지, inference는 끝났지만 deadline 뒤에 도착했는지, 최신 chunk가 왔는데 scheduler가 오래된 action을 실행했는지를 event log로 연결합니다. 단순 실패 video만 보면 세 원인이 모두 “팔이 늦었다”로 보일 수 있습니다.
안전한 scheduler는 새 chunk가 왔다는 이유만으로 즉시 관절 명령을 뛰어넘지 않습니다. 새 chunk와 이전 chunk의 첫 동작 차이가 크면 속도, 가속도 limit를 적용하고, action age가 상한을 넘거나 관측이 끊기면 정지합니다. 이 runtime guard를 포함한 p95 sensor-to-actuator latency와 success를 함께 보고해야 현장 20Hz의 의미가 생깁니다.
컨베이어 속도를 단계적으로 높이며 perception 시각, action 생성 시각과 실제 실행 시각을 함께 기록해야 병목을 찾을 수 있습니다. 평균 성공률만 보면 순간 정지나 가림에 취약한 구간이 숨으므로 속도, 물체 크기, 가림별 실패와 안전 중단 비율을 나눠 봅니다.
함께 읽으면 이해가 이어지는 글
- 로봇 Action을 한 Token씩 만들지 않으면 나아질까? Dream-VL, Dream-VLA — Dream-VL과 Dream-VLA가 masked diffusion language backbone으로 양방향 문맥과 action chunk 병렬 복원을 시도한 이유, benchmark 성과와 반복 denoising 비용을 함께…
- TwinBrainVLA는 지능을 보존하며 20Hz 제어할까: Frozen VLM과 Action Expert의 대가 — 범용 VLM을 동결하고 제어 전문가만 학습하는 TwinBrainVLA의 성능 이득과 실시간 제어 비용을 구분해 봅니다.
- BayesianVLA는 왜 로봇이 언어를 무시하는 문제를 줄이나: PMI 수식과 11.3%p — Vision만으로 action을 예측해 language를 무시하는 information collapse를 prior, posterior branch와 latent action query로 분리하는 방식, PMI 목적 함수와 OOD…
자주 묻는 질문
0.4B 모델만 쓰면 20Hz 동적 제어가 가능한가요?
아닙니다. 작은 model 외에도 inference와 execution을 겹치는 pipeline, 오래된 action을 폐기하는 streaming과 전체 sensor-to-actuator runtime이 함께 맞아야 합니다.
80% 성공률은 모든 움직이는 물체에 적용되나요?
아닙니다. 보조 robot arm이 만든 여섯 실물 task와 정해진 motion-position 조건의 결과이며 chaotic motion, 새 object, 가림은 별도로 평가해야 합니다.
Action chunk를 자주 바꾸면 항상 더 좋은가요?
최신 관측 반영은 빨라지지만 관절 명령이 급변해 jitter가 생길 수 있으므로 chunk age, 교체 직후 smoothness, collision과 missed deadline을 함께 봐야 합니다.
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.