ERL은 학습 중에는 첫 시도, 성찰, 수정 시도를 모두 생성하지만, 성공한 수정 경로를 기본 정책에 증류해 테스트 때 매번 성찰하지 않고도 더 나은 첫 답을 내도록 합니다. 다만 Sokoban의 81% 향상은 특정 비교 결과이며, 성찰 생성 때문에 늘어난 학습 비용과 우연한 성공을 잘못 내재화할 위험을 함께 봐야 합니다.
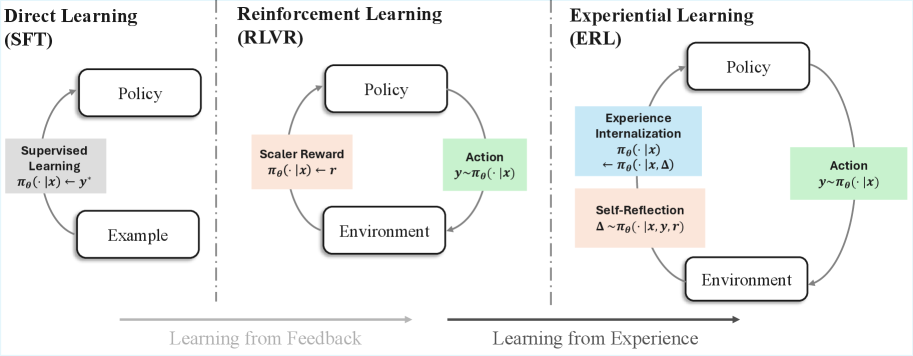 결과 점수만 받지 않고 경험을 언어로 성찰한 뒤 행동 변화로 내재화하는 ERL.
ERL은 학습 중에는 첫 시도, 성찰, 수정 시도를 모두 생성하지만, 성공한 수정 경로를 기본 정책에 증류해 테스트 때 매번 성찰하지 않고도 더 나은 첫 답을 내도록 합니다. 다만 Sokoban의 81% 향상은 특정 비교 결과이며, 성찰 생성 때문에 늘어난 학습 비용과 우연한 성공을 잘못 내재화할 위험을 함께 봐야 합니다.
결과 점수만 받지 않고 경험을 언어로 성찰한 뒤 행동 변화로 내재화하는 ERL.
FrozenLake, Sokoban, HotpotQA처럼 여러 단계를 거치는 과제에서는 마지막 실패 보상이 앞선 어느 선택 때문인지 불분명합니다. RLVR의 0 또는 1 보상만으로는 모델이 같은 실수를 표현만 바꿔 반복할 수 있습니다.
ERL은 실패한 trajectory 자체를 추가 정보로 바꿉니다. 환경의 오류 메시지와 결과를 모델에게 다시 보여주고, 무엇을 고쳐야 하는지 언어로 설명하게 합니다. 이 reflection은 사람이 정답 과정을 새로 labeling한 것이 아니라 같은 모델이 자신의 경험에서 만든 중간 학습 신호입니다.
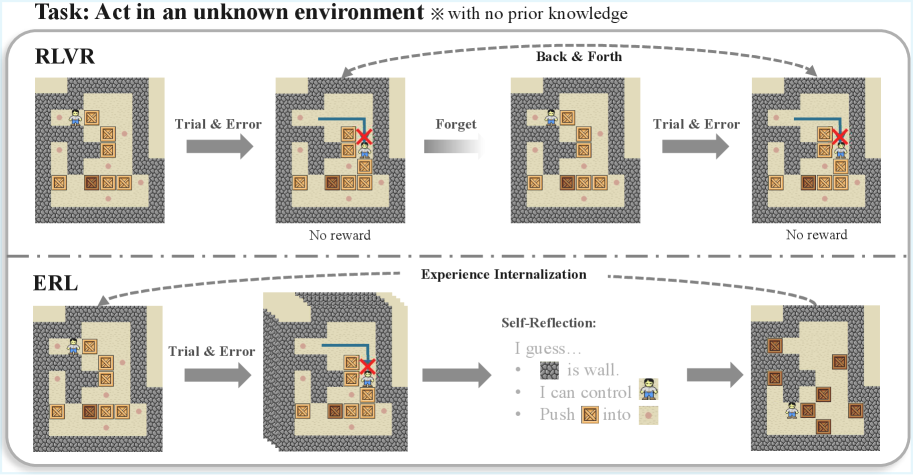 독립적인 시행착오와 경험, 성찰, 내재화가 연결된 학습의 차이.
한 과제 $x$에서의 흐름은 네 단계입니다.
첫 시도, reflection, 수정 시도는 강화학습의 대상이 되고, 성공한 $a_2$에는 Negative Log-Likelihood 기반 self-distillation loss를 더해 원래 입력 $x$만 보고도 그 행동을 재현하도록 합니다.
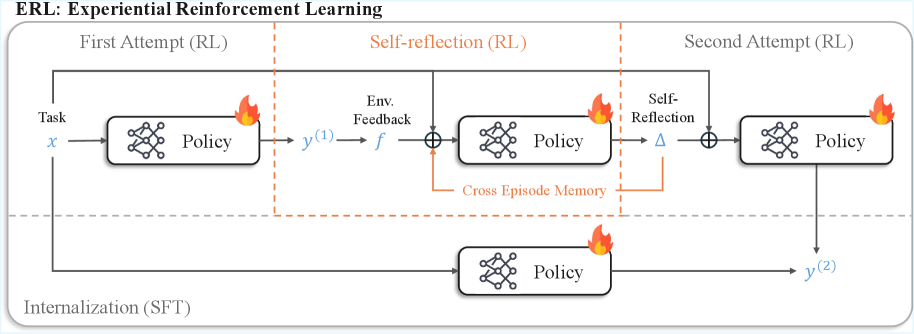 성공한 두 번째 시도를 원래 정책에 self-distillation하는 전체 루프.
이 방식은 추론 비용을 학습으로 옮기지만 공짜로 없애지는 않습니다. 한 task당 최소 세 종류의 sequence를 생성하므로 원문도 기존 RLVR보다 학습 계산량이 크게 늘 수 있다고 지적합니다.
실험 모델은 Qwen3-4B-Instruct-2507과 Olmo-3-7B-Instruct이고, 환경은 FrozenLake, Sokoban, HotpotQA입니다. 최종 답의 정오를 0 또는 1로 검증할 수 있는 과제를 사용합니다.
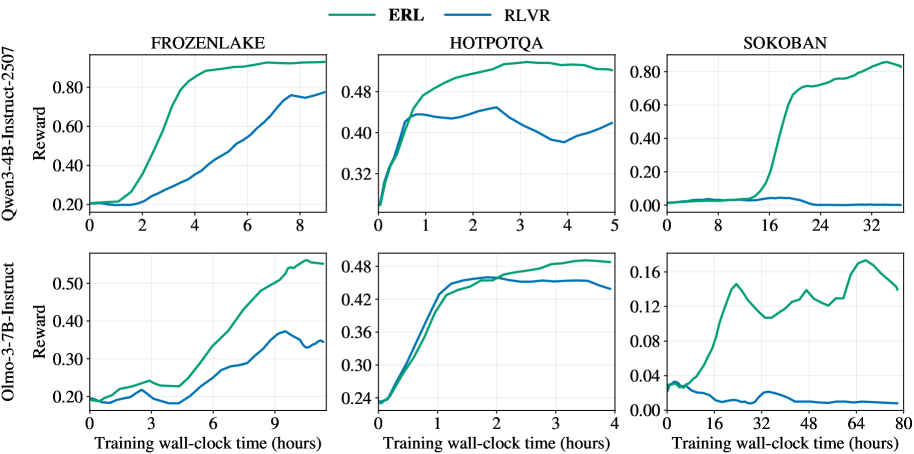 Wall-clock 시간에 따른 ERL과 RLVR의 검증 reward.
원문은 Sokoban에서 81% 성능 향상을 가장 큰 결과로 소개합니다. 그러나 이 글에는 “81% 성공률”, “81% 상대 향상”, “81%p 증가” 중 어느 의미인지 판단할 세부 표가 없습니다. 수치를 절대 성공 확률로 인용하면 안 되는 이유입니다.
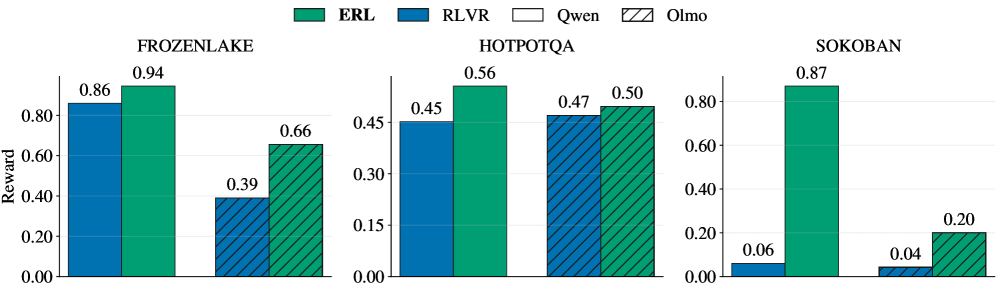 두 base model의 세 과제 최종 evaluation reward 비교.
학습 초기에 reward가 빨리 오른다는 그림도 흥미롭지만, wall-clock당 생성 token과 GPU 비용을 포함해 비교해야 “더 빠른 학습”인지 알 수 있습니다.
두 번째 시도가 성공했다고 reflection의 인과 설명까지 옳은 것은 아닙니다. 모델이 우연히 정답을 맞히고 엉뚱한 원인을 설명하면, self-distillation은 결과와 함께 잘못된 규칙을 학습할 수 있습니다. 초기 모델이 약할수록 reflection 자체가 환각일 가능성도 큽니다.
또한 복잡한 성찰을 짧은 첫 시도에 완전히 압축하는 데는 한계가 있습니다. 학습에서 본 패턴은 내재화할 수 있어도 새로운 장기 계획은 test-time reasoning이 다시 필요할 수 있습니다.
안전하게 평가하려면 다음을 분리합니다.
ERL은 compiler error, unit test, 게임 성공 여부처럼 결과를 자동 확인할 수 있는 과제에 잘 맞습니다. 의료 진단이나 법률 자문처럼 정답 verifier가 불완전한 영역에서 “전문가 사고를 내재화한다”는 원문의 응용 전망은 별도 안전 검증 없이는 성립하지 않습니다.
실무 적용의 첫 단계는 실패 원인이 관찰 가능하고, 수정 시도를 sandbox에서 재실행하며, 성공 조건을 외부에서 판정할 수 있는 작업입니다. ERL의 가치는 모델이 반성문을 잘 쓰는 데 있지 않습니다. 반성 뒤 실제로 검증된 행동만 기본 정책의 첫 시도로 옮길 수 있다는 데 있으며, 그 검증기가 틀리면 전체 루프도 같이 틀립니다.
$a_2$가 좋아졌다는 사실만으로 reflection $r$이 도움을 줬다고 결론 내릴 수 없습니다. 두 번째 시도는 단순히 한 번 더 표본을 뽑았기 때문에 우연히 성공했을 수도 있습니다. 같은 실패 사례에 원래 성찰, 다른 사례에서 섞어 온 성찰, 성찰 없는 재시도를 각각 적용하면 개선이 구체적 오류 설명에서 왔는지 추가 샘플링에서 왔는지 비교할 수 있습니다.
성찰 문장 자체도 실행 가능한 주장으로 나눠야 합니다. Sokoban이라면 “상자를 모서리에 밀어 넣어 복구할 수 없었다”처럼 보드 상태로 확인할 수 있는 원인과 “더 신중해야 한다” 같은 일반 문구를 구분합니다. 첫 종류를 제거했을 때 수정 성공률이 떨어지는지 확인하면 학습할 가치가 있는 경험 신호를 찾을 수 있습니다. 설명과 실제 행동 변화가 연결되지 않는다면 긴 reflection은 토큰 비용만 늘립니다.
성공 검증기가 목표의 일부만 본다면 정책은 그 빈틈을 학습할 수 있습니다. 코드 과제에서 공개 테스트만 통과하면 성공으로 보상할 경우 숨은 요구를 깨뜨리는 수정도 증류될 수 있습니다. 검색 과제에서 정답 문자열만 맞추면 근거 없는 추측이 우연히 맞은 사례까지 좋은 경로로 남습니다. 따라서 증류 대상으로 쓰기 전에 수정 행동이 규칙을 지켰는지, 근거와 답이 일치하는지, 다른 초기 상태에서도 같은 원리가 재현되는지를 검사해야 합니다.
한 번 성공한 경로보다 반복 성공한 경로에 더 높은 신뢰를 두는 방법도 있습니다. 초기 상태나 문제 표현을 조금 바꿔도 $a_2$가 성공하고, reflection이 지목한 원인을 바꾸면 실패한다면 인과 설명에 더 강한 근거가 생깁니다. 반대로 사소한 변형에서 무너지면 특정 문구나 상태를 외운 것이므로 기본 정책에 강하게 내재화하지 않는 편이 낫습니다.
ERL은 배포 시 성찰 단계를 줄이는 대신 학습 때 $a_1$, $r$, $a_2$를 생성합니다. 비교표에는 최종 reward뿐 아니라 성공 사례 하나를 얻는 데 생성한 토큰, GPU 시간, 환경 실행 횟수와 증류 후 첫 시도의 지연을 넣어야 합니다. 트래픽이 작거나 과제가 자주 바뀌면 비싼 학습 비용을 회수하기 전에 정책이 낡을 수 있습니다.
반대로 같은 유형의 검증 가능한 과제를 매우 많이 반복한다면 학습 비용을 한 번 지불하고 첫 시도 품질을 높이는 이점이 커집니다. 손익분기점은 “성찰을 없앴다”는 문구가 아니라, 배포 요청 수에 따른 절약 토큰과 추가 학습 비용이 만나는 지점입니다. 새 규칙이 들어올 때 성능이 급락하거나 verifier가 자주 바뀌는 환경에서는 test-time reflection을 완전히 없애기보다 어려운 사례에만 남기는 혼합 정책이 더 안전합니다.
최종 파일럿은 쉬운 문제와 긴 horizon 문제를 분리해야 합니다. 쉬운 문제의 평균 향상이 커도 장기 계획에서 첫 오류가 계속 누적된다면 ERL이 성찰 능력을 내재화했다기보다 자주 본 패턴을 외운 것일 수 있습니다. 실패 원인 분류, 내재화 전후 첫 시도, 성찰 재도입 시 회복 여부를 함께 보면 어디까지 기본 정책에 맡길지 정할 수 있습니다.
Verifier가 업데이트되면 기존에 증류한 성공 경로도 다시 표본 검사해야 합니다. 이전에는 성공이던 행동이 새 규칙에서는 실패일 수 있는데 정책 가중치에는 오래된 기준이 남아 있기 때문입니다. 규칙 버전과 학습 데이터를 연결해 두고, 바뀐 조건의 회귀 세트에서 첫 시도와 성찰 후 시도를 모두 비교합니다. 기준 변화가 잦다면 영구적인 자기증류보다 외부 메모리나 테스트 시 검증을 유지하는 편이 수정 가능성이 높습니다.
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.