Nanbeige4.1-3B는 최대 600턴의 긴 상호작용에서 tool-call 형식과 목표를 유지하도록 학습됐지만, 600번을 거치면 모든 업무를 성공한다는 뜻은 아닙니다. 이 모델의 핵심은 3B라는 크기보다 multi-hop trajectory, 턴별 supervision, 정답을 통과한 코드에만 시간 복잡도 보상을 주는 학습 설계입니다.
3B 모델이 600턴 도구 사용을 버틸까: Nanbeige4.1의 Turn-level 지도와 누적 오류
작은 모델이 긴 작업에서 먼저 잃는 것
3B급 모델은 메모리와 비용 면에서 유리하지만, 긴 context에서 세 문제가 두드러질 수 있습니다. 이전 tool result를 잊고, call format이 깨지며, 당장 그럴듯한 행동을 반복하다 최종 목표를 놓칩니다. 코드에서는 test를 통과하는 데만 집중해 더 나은 알고리즘을 고르지 못할 수 있습니다.
Nanbeige4.1-3B는 architecture를 크게 늘리기보다 reasoning, code, agent용 데이터와 reward를 별도로 설계합니다. 따라서 성능 주장을 읽을 때도 “3B면 충분하다”보다 어떤 supervision이 각 실패를 겨냥했는지 보는 편이 유용합니다.
Deep Search 데이터는 답보다 경로를 만든다
Deep Search pipeline은 complex multi-hop QA를 뽑고, 여러 정보원을 연결하는 long-horizon reasoning trajectory를 합성합니다.
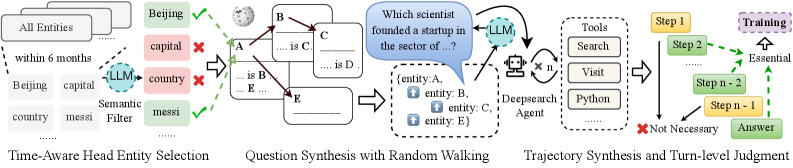 Multi-hop 질문과 장기 검색 궤적을 만드는 데이터 파이프라인.
정렬 단계에서는 두 reward를 섞습니다.
- Point-wise reward는 응답 하나의 절대 품질을 평가합니다.
- Pair-wise reward는 후보들 가운데 더 나은 응답을 고릅니다.
Point-wise만 쓰면 평가 scale의 편향이, pair-wise만 쓰면 후보 집합에 따른 상대 평가가 남습니다. 두 방식을 결합해 정확성과 선호를 함께 맞추려는 구성입니다. 다만 합성 경로가 특정 teacher의 문체와 탐색 습관에 치우치면 작은 모델도 그 패턴을 그대로 압축합니다.
시간 보상은 정답 코드를 통과한 뒤에만 열린다
일반 Code RL은 unit test 통과 여부를 보상합니다. Nanbeige4.1은 모든 test case를 통과했을 때만 time-complexity reward $R_{\text{time}}$를 활성화합니다.
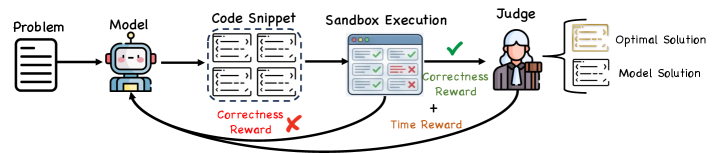 정답 gate 뒤 reference bound와 실행 복잡도를 비교하는 보상.
이 순서가 중요한 이유는 빠르지만 틀린 코드를 보상하지 않기 위해서입니다. 예를 들어 정답을 내는 $O(n^2)$ 해법과 $O(n\log n)$ 해법을 reference bound와 비교해 후자를 선호하게 만듭니다.
학습은 먼저 코드 정확도를 높이고, 두 번째 단계에서 시간 보상을 넣습니다.
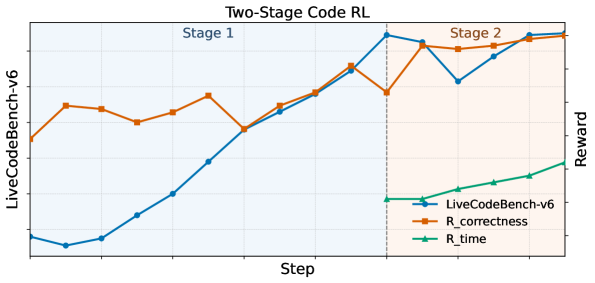 정답 중심 1단계와 시간 복잡도까지 포함한 2단계 Code RL.
이 방법은 test와 reference complexity가 있는 competitive programming에는 명확합니다. 모호한 business logic, I/O 병목, database query처럼 입력 분포와 시스템 조건이 성능을 좌우하는 실무 코드에서는 같은 reward를 바로 만들기 어렵습니다.
600턴은 지속 시간이지 성공률이 아니다
Agent 학습은 tool을 호출하는 각 turn에 supervision을 주어 장기 대화 중 형식과 방향을 교정합니다. 원문은 최대 600회의 상호작용을 완수했다고 설명합니다. 하지만 다음은 서로 다른 지표입니다.
| 지표 | 의미 |
|---|---|
| 최대 turn 길이 | context와 protocol을 얼마나 오래 유지했는가 |
| 유효 tool-call 비율 | schema와 argument가 맞았는가 |
| 중간 단계 정확도 | 각 call이 필요한 정보를 얻었는가 |
| 최종 task 성공률 | 누적 결과가 원래 목표를 달성했는가 |
| 총 비용, 지연 | 긴 trajectory가 운영 가능한가 |
오류 확률이 turn마다 작아도 600번 누적되면 최종 성공률은 크게 달라질 수 있습니다. 원문도 세밀한 success-rate 분석이 더 필요하다고 지적합니다.
Qwen3-4B, 일부 Qwen3-30B-A3B 추론 과제, LiveCodeBench와 HumanEval에서의 강한 결과가 언급되지만 이 글에는 benchmark별 절대 점수와 inference budget이 없습니다. 특정 평가의 우위를 30B 모델 전체 능력의 대체로 해석하면 안 됩니다.
배치 전에 세 종류의 시험을 분리한다
온디바이스 가능성은 3B parameter count만으로 결정되지 않습니다. quantization, context 길이, KV cache, tool runtime과 device memory가 제시되지 않았으므로 “최신 스마트폰에서 바로 실행”은 검증된 결과가 아니라 응용 전망입니다.
도입 시험은 다음처럼 나눌 수 있습니다.
- Reasoning: 같은 token budget에서 multi-hop 정답률과 근거 누락
- Code: test 통과, 실행 시간, memory, reference가 없는 과제의 품질
- Agent: 10, 100, 600턴별 schema 오류, recovery, 최종 성공과 총 비용
Nanbeige4.1-3B가 보여주는 포인트는 파라미터 수가 중요하지 않다는 선언이 아닙니다. 작은 모델도 각 turn의 피드백과 검증 가능한 효율 reward를 촘촘히 설계하면 특정 장기 작업에서 훨씬 큰 모델과 경쟁할 수 있다는 것입니다. 그 경쟁 범위는 실제 tool과 실패 복구를 포함한 end-to-end 평가로 정해야 합니다.
600턴 시험은 어떤 단계로 늘려야 할까?
처음부터 600턴 과제 하나만 주면 실패 원인을 찾기 어렵습니다. 같은 도구와 목표를 사용하되 10턴, 50턴, 100턴으로 길이를 늘려 schema 오류, 잘못된 인수, 잊힌 제약, 반복 호출이 처음 나타나는 구간을 기록합니다. 짧은 과제의 성공이 긴 과제에서 어느 정도 유지되는지 곡선으로 보는 편이 최대 턴 수 하나보다 유용합니다.
도구 결과에는 성공 응답뿐 아니라 빈 결과, 시간 초과, 형식 변경, 부분 실패를 섞어야 합니다. 모델이 같은 호출을 무한 반복하는지, 대체 경로를 찾는지, 근거가 없을 때 멈추는지 확인합니다. 복구 행동도 최종 목표를 향하는지 봐야 하며 단순히 유효한 JSON을 계속 출력하는 것을 성공으로 세면 안 됩니다.
장기 상태는 인물, 파일, 숫자 같은 서로 다른 종류로 평가할 수 있습니다. 앞에서 읽은 값이 뒤의 계산과 쓰기 작업에 정확히 쓰이는지, 새 결과가 나왔을 때 오래된 가정을 갱신하는지 확인합니다. 전체 context가 길어질 때 중요한 제약이 묻힌다면 요약이나 외부 메모리를 붙인 구성과 비교할 수 있습니다.
코드 효율 보상이 실무에서도 유효한지 어떻게 볼까?
정답 테스트를 모두 통과한 뒤에만 효율 보상을 주는 gate는 유지하되, 실행 시간 측정의 노이즈와 입력 분포를 고려해야 합니다. 작은 입력에서 빠른 구현이 큰 입력에서 느릴 수 있고, reference 복잡도가 실제 데이터베이스나 네트워크 병목을 설명하지 못할 수 있습니다. 실무 코드에서는 시간뿐 아니라 메모리, 가독성, 오류 처리도 별도 기준입니다.
테스트가 불완전하면 빠르지만 잘못된 코드가 gate를 통과할 수 있습니다. 경계값, 큰 입력, 잘못된 입력을 포함하고, 생성 코드가 test 자체를 우회하거나 결과를 하드코딩하지 않는지 봅니다. reference solution보다 다른 알고리즘을 썼더라도 실제 복잡도와 정확성이 맞으면 보상할 수 있는지도 검토해야 합니다.
배포 판단은 모델 메모리와 함께 긴 context의 KV cache, 도구 실행 프로세스, 네트워크 호출을 포함한 종단 자원으로 합니다. 3B 가중치만 기기에 들어간다고 600턴 작업이 안정적으로 구동되는 것은 아닙니다. 목표 턴 길이에서 메모리와 지연, 실패 복구를 모두 만족하는 범위가 실제 온디바이스 가능성입니다.
장기 작업에는 중간 체크포인트와 종료 조건도 필요합니다. 100턴마다 목표, 확인된 사실, 남은 제약과 부작용을 구조화해 저장하면 문맥 압축 뒤에도 중요한 상태를 검증할 수 있습니다. 같은 도구를 반복하거나 근거 없이 계획만 바꾸는 횟수가 기준을 넘으면 600턴까지 계속하지 않고 사람에게 넘겨야 합니다. 최대 지속 시간이 길다는 능력을 끝까지 실행해야 하는 의무로 해석하지 않아야 비용과 잘못된 연쇄 행동을 제한할 수 있습니다.
함께 읽으면 이해가 이어지는 글
- AI 에이전트와 챗봇은 무엇이 다른가: 도구 실행, 메모리, 권한까지 만드는 순서 — AI 에이전트의 perception-reasoning-action loop를 챗봇과 구분하고, LLM, 도구, 메모리, 검증을 연결하는 개발 순서와 기존 Python 예제가 완전한 에이전트가 아닌 이유를 설명합니다.
- 멀티모달 에이전트가 25번 도구를 써도 답을 찾을까: AgentVista — AgentVista의 25개 하위 도메인, 7개 범주와 장기 도구 사용 평가, Gemini-3-Pro 27.3% 결과를 비용, 연쇄 오류 관점에서 해석합니다.
- Smolagents CodeAgent가 JSON 파싱을 없앨까: Python 실행과 Sandbox 위험 — Smolagents가 JSON 도구 호출 대신 Python 코드로 여러 행동을 묶는 방식을 살펴보고, 줄어든 왕복 호출과 맞바꾼 임의 코드 실행, 디버깅, 격리 비용을 정리합니다.
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.