MinerU-Diffusion의 3.2배는 모든 OCR 작업의 보장값이 아니라, 병렬 디코딩 설정과 정확도 조건을 함께 봐야 하는 연구 결과입니다.
MinerU-Diffusion은 OCR을 3.2배 빠르게 할까: Threshold, VRAM의 교환
왜 문서를 왼쪽부터 한 토큰씩 읽지 않는가
자기회귀 방식은 앞 토큰을 확정한 뒤 다음 토큰을 생성하므로 길이 $N$에 따라 순차 단계가 늘고, 앞의 오류가 뒤 문맥에 영향을 줄 수 있습니다. MinerU-Diffusion은 이미 완성된 2D 문서에서 1D 표현을 복원하는 일을 “역렌더링”으로 보고, 전체 토큰 자리를 마스크한 뒤 여러 위치를 병렬로 확정합니다.
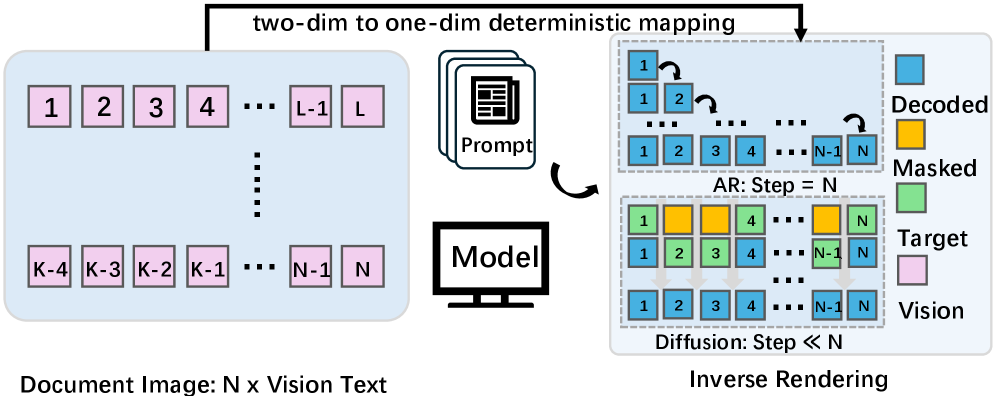
문서 이미지가 시각 조건으로 들어가고, 매 단계에서 확신도가 높은 토큰부터 마스크를 벗습니다. 블록 안에서는 양방향으로 문맥을 보고 앞 블록에는 인과적으로 주의를 주는 블록 단위 어텐션을 사용합니다. 표의 같은 행과 열, 수식의 양쪽 기호를 함께 볼 수 있다는 점이 순차 생성과 다른 핵심입니다.
복잡도를 자기회귀의 $O(N)$과 디퓨전 스텝의 $O(T)$로 단순 비교할 수 있고 논문은 $T \ll N$인 조건을 기대합니다. 다만 한 스텝이 전체 후보를 병렬 계산하므로, 이 표기만으로 총 연산량이나 지연을 단정할 수는 없습니다.
코드는 실행 예제가 아니라 추론 개념도다
원문의 핵심 조각을 줄이면 다음 흐름입니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
def diffusion_decode(image_features, seq_length, confidence_threshold=0.9):
    tokens = torch.full((1, seq_length), MASK_TOKEN_ID)
    mask_status = torch.ones((1, seq_length), dtype=torch.bool)

    for step in range(MAX_DIFFUSION_STEPS):
        if not mask_status.any():
            break

        logits = model.forward_parallel(tokens, image_features)
        probs = F.softmax(logits, dim=-1)
        max_probs, predicted_tokens = probs.max(dim=-1)

        confident_mask = (max_probs > confidence_threshold) & mask_status
        tokens[confident_mask] = predicted_tokens[confident_mask]
        mask_status[confident_mask] = False
        confidence_threshold = decay_threshold(confidence_threshold, step)

    return tokens
이 코드는 알고리즘을 설명하는 의사 코드입니다. torch와 F의 import, 모델 정의, MASK_TOKEN_ID, 최대 스텝, 임계치 감소 함수와 장치 배치가 없으므로 그대로 실행되지 않습니다. 특히 실제 구현에서는 한 단계에서 아무 토큰도 임계치를 넘지 못할 때의 진행 규칙과 최대 길이, 패딩 처리도 필요합니다.
읽을 때 볼 지점은 간단합니다. 높은 임계치는 잘못 확정할 위험을 줄이는 대신 스텝이 늘 수 있고, 낮은 임계치는 더 많은 토큰을 한꺼번에 열지만 오류 가능성을 높입니다. 한 번 확정한 토큰을 다시 수정할 수 있는지까지 구현 사양에서 확인해야 합니다.
3.2배와 VRAM을 같은 표에 놓아야 한다
논문이 보고한 최대 3.2배 디코딩 속도 향상은 관심을 끌 만합니다. 그러나 운영 지표는 평균 문서가 아니라 팀의 문서 분포에서 다시 재야 합니다. 일반 문장, 복잡한 표, 수식과 섞인 레이아웃은 최적 임계치가 다를 수 있습니다.
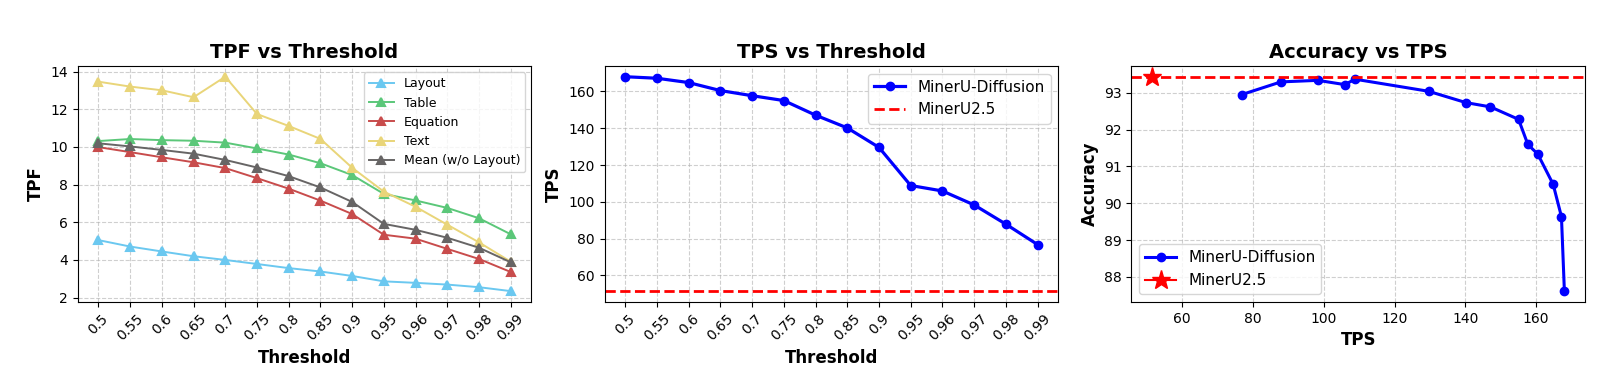
확인할 변수는 세 가지입니다.
- 신뢰도 임계치: 낮추면 처리량이 늘 수 있지만 정확도가 떨어질 수 있다.
- 디퓨전 스텝과 블록 크기: 수렴 속도와 문맥 범위가 함께 달라진다.
- 최대 메모리: 자기회귀 KV 캐시는 줄어도 병렬 어텐션 순간의 VRAM 피크가 생길 수 있다.
따라서 “한 장 처리 시간”만 재면 부족합니다. 동일 정확도 기준의 초당 페이지 수, 최악 지연, 최대 VRAM과 실패 문서 비율을 함께 기록해야 합니다.
도입 판단은 작은 문서 묶음으로 한다
먼저 실제 입력에서 텍스트 중심, 표 중심, 수식 중심 문서를 나누고 사람이 확인한 정답을 준비합니다. 각 묶음에서 임계치와 스텝을 바꾸되 정확도 하한을 먼저 고정한 뒤 처리량을 비교합니다. 가장 빠른 설정이 아니라 요구 정확도를 지키는 가장 빠른 설정을 고르는 방식입니다.
대량 PDF를 RAG용 텍스트로 변환하는 배치라면 처리량 향상이 인프라 비용으로 연결될 수 있습니다. 반대로 문서 형식이 계속 달라지거나 한 자리 숫자 오류도 허용하기 어렵다면 도메인별 튜닝과 후처리 비용이 이득을 상쇄할 수 있습니다. 사용자 경로에 바로 넣기 전에 내부 데이터 구축 작업에서 재현성과 실패 양상을 확인하는 편이 안전합니다.
병렬 확정은 어떤 오류를 되돌리기 어렵게 만들까
높은 확률의 토큰을 먼저 확정하면 뒤 단계가 그 토큰을 문맥으로 사용합니다. 초기에 표의 열 제목이나 수식 기호를 잘못 열었는데 다시 마스킹하지 않는 구현이라면 여러 위치가 같은 오류를 따라갈 수 있습니다. 자기회귀의 앞 토큰 오류와 형태는 다르지만 이 방식에도 “먼저 확정한 오류”의 전파가 있습니다.
신뢰도는 정확도와 같지 않습니다. 모델이 익숙한 글꼴에는 잘 보정돼도 흐린 숫자나 생소한 수식 기호에 높은 확률의 오답을 낼 수 있습니다. 확정 순서와 정답 여부를 기록하면 고신뢰 오답이 어느 문서 유형에서 생기는지 볼 수 있습니다. 이런 토큰은 임계치를 올리는 것만으로 잡히지 않을 수 있어 재마스킹, 후처리 검사나 사람 검토가 필요합니다.
블록 경계도 살펴야 합니다. 문장이 다음 블록으로 이어지거나 표의 행, 열 관계가 블록을 가로지르면 앞 블록을 고정한 구조가 뒤 문맥의 수정 기회를 제한할 수 있습니다. 같은 문서를 블록 크기만 바꿔 처리하고 경계 부근의 누락, 중복을 비교하면 속도와 문맥 보존의 교환을 찾을 수 있습니다.
문서 유형별로 어떤 정확도를 재야 할까
일반 문장은 문자 오류율과 단어 오류율을 볼 수 있지만 표와 수식은 같은 지표만으로 충분하지 않습니다. 표에서는 셀 값뿐 아니라 행, 열 연결과 병합 구조를, 수식에서는 기호, 첨자, 괄호의 구조를 확인해야 합니다. 레이아웃 순서가 바뀌면 글자는 모두 맞아도 RAG나 데이터 추출 결과가 틀릴 수 있습니다.
평가 묶음에는 깨끗한 디지털 PDF, 스캔, 기울어진 촬영본, 작은 글씨, 다단 문서와 복잡한 표를 포함합니다. 각 묶음에서 전체 평균과 최악 사례를 함께 보고, 숫자, 날짜, 단위처럼 업무상 비용이 큰 토큰의 오류를 별도로 셉니다. 속도가 빨라도 청구 금액이나 수식 부호를 더 자주 틀리면 자동 처리 경로에는 맞지 않습니다.
긴 문서에서는 페이지 단위 정확도와 함께 순서 보존을 확인합니다. 머리말, 꼬리말이 본문에 반복 삽입되는지, 페이지 사이 문장이 끊기는지, 표가 두 페이지에 걸릴 때 이어지는지 봅니다. OCR 모델 자체와 PDF 페이지 분할, 후처리의 오류를 분리하면 무엇을 바꿔야 하는지 알 수 있습니다.
3.2배를 우리 환경에서 어떻게 재현할까
기준선과 MinerU-Diffusion에 같은 이미지 전처리, 해상도, 출력 형식과 정확도 하한을 적용합니다. 모델 로딩을 제외한 따뜻한 상태와 처음 시작하는 차가운 상태를 나누고, 단일 페이지 지연, P95 지연, 배치 처리량, 최대 VRAM을 기록합니다. 디코딩만 잰 수치와 이미지 인코딩, 후처리, 파일 입출력을 포함한 종단 시간을 구분해야 합니다.
임계치와 최대 스텝을 바꿀 때 가장 빠른 점만 고르지 않습니다. 각 설정의 정확도와 처리량을 곡선으로 놓고 요구 정확도 이상인 점들 사이에서 비용을 비교합니다. 한 단계에서 확정되는 토큰이 없어 최대 스텝까지 가는 문서 비율도 봐야 평균 뒤에 숨은 느린 꼬리를 찾을 수 있습니다.
GPU 종류와 동시 배치가 달라지면 병렬 방식의 이점도 달라질 수 있습니다. 큰 병렬 행렬을 처리할 여유가 없는 장비에서는 VRAM 부족이나 작은 배치로 속도 이득이 줄 수 있습니다. 운영과 같은 장비, 동시 요청에서 측정하고, 메모리 부족 때 문서를 더 작은 블록으로 나누면 정확도에 어떤 영향이 있는지도 확인합니다.
임계치를 자동으로 낮출 때 무엇을 감시할까
의사 코드처럼 스텝마다 임계치를 낮추면 결국 더 많은 토큰이 열리지만, 마지막에 낮은 확률로 확정된 토큰이 어디인지 표시해야 합니다. 이런 위치는 후처리나 사람 검토의 우선 대상이 될 수 있습니다. 문서 전체의 평균 확률보다 숫자, 표 헤더, 수식 기호 같은 중요 영역의 최저 확률이 더 유용할 수 있습니다.
확률 보정은 모델이나 도메인이 바뀔 때 다시 해야 합니다. 학습과 비슷한 문서에서 0.9가 잘 맞았다고 새로운 언어, 글꼴에서도 같은 정확도를 뜻하지 않습니다. 사람이 확인한 작은 세트에서 확률 구간별 실제 정답률을 구하고, 고신뢰 오답이 많으면 임계치 기반 자동 확정을 제한합니다.
후처리 검사는 OCR 결과를 무조건 고치는 단계가 아니라 모순을 찾는 단계로 두는 편이 안전합니다. 표의 합계가 맞지 않거나 날짜 형식이 깨진 위치를 다시 마스킹하거나 원본 이미지와 함께 검토 대상으로 보낼 수 있습니다. 언어 모델로 자연스럽게 교정만 하면 실제 문서에 없는 값을 만들어 낼 위험이 있습니다.
어떤 조건에서 배포를 보류해야 할까
자기회귀 기준선보다 평균은 빠르지만 중요한 숫자 오류가 늘거나, 특정 문서에서 최대 스텝에 자주 도달하거나, VRAM 피크가 운영 장비 한도를 넘으면 설정을 다시 조정해야 합니다. 문서 유형마다 최적 임계치가 크게 다르면서 라우팅 기준이 없다면 한 설정으로 전체 입력을 처리하기 어렵습니다.
논문 결과와 같은 배수에 도달하지 못해도 요구 정확도를 지키며 실제 배치 비용이 낮아진다면 도입 가치는 있을 수 있습니다. 반대로 디코딩은 빨라졌지만 전처리, 후처리와 사람 교정이 늘어 종단 시간이 줄지 않았다면 기술적 속도 향상이 운영 이득으로 이어지지 않은 것입니다.
첫 배포는 원본을 보존하고 결과를 다시 만들 수 있는 비동기 색인 작업이 적합합니다. 오류를 되돌리기 어려운 실시간 승인이나 금액 입력에는 문서 유형별 검증과 저신뢰 토큰 검토가 충분히 쌓인 뒤 범위를 넓혀야 합니다.
논문과 자료:
함께 읽으면 이해가 이어지는 글
- Python 영상 OCR, EasyOCR과 Tesseract 중 무엇을 쓸까? 프레임 코드 비교 — 복잡한 배경, 다국어 영상에는 EasyOCR, 단순한 화면 텍스트에는 Tesseract를 먼저 비교하고, OpenCV로 모든 프레임을 읽는 두 코드의 처리 흐름과 한계를 설명합니다.
- MoAI는 왜 외부 CV 모델 4개를 붙이나: Compressor와 Mixer — MoAI가 분할, 탐지, 관계, OCR 결과를 압축하고 시각, 보조, 언어 정보를 상황별로 섞어 세밀한 장면 이해를 보완하는 구조를 설명합니다.
- 15B Phi-4 Vision은 왜 UI, 수식 추론을 노리나: 동적 해상도와 모드 토큰 — Phi-4-reasoning-vision-15B의 동적 해상도 입력, 데이터 정제, 직접 답변, 추론 모드와 로컬 도입 전 확인할 한계를 정리합니다.
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.