하나의 샘플로 두 능력을 함께 학습하면 무엇이 달라지나요?
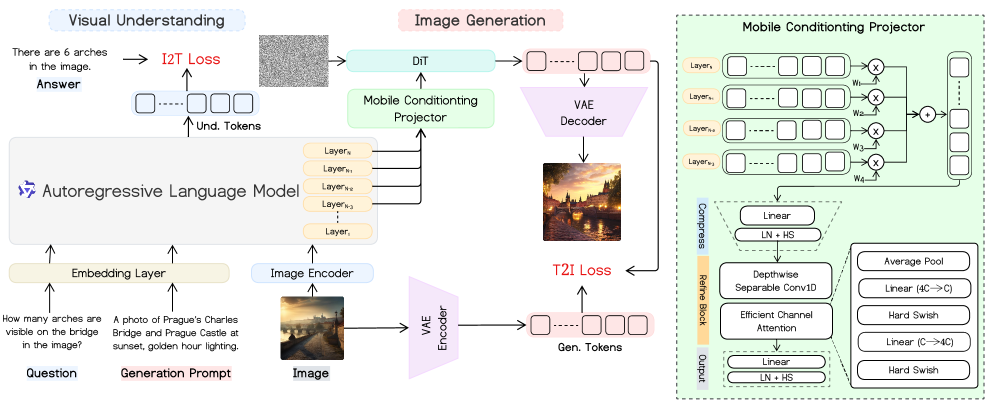
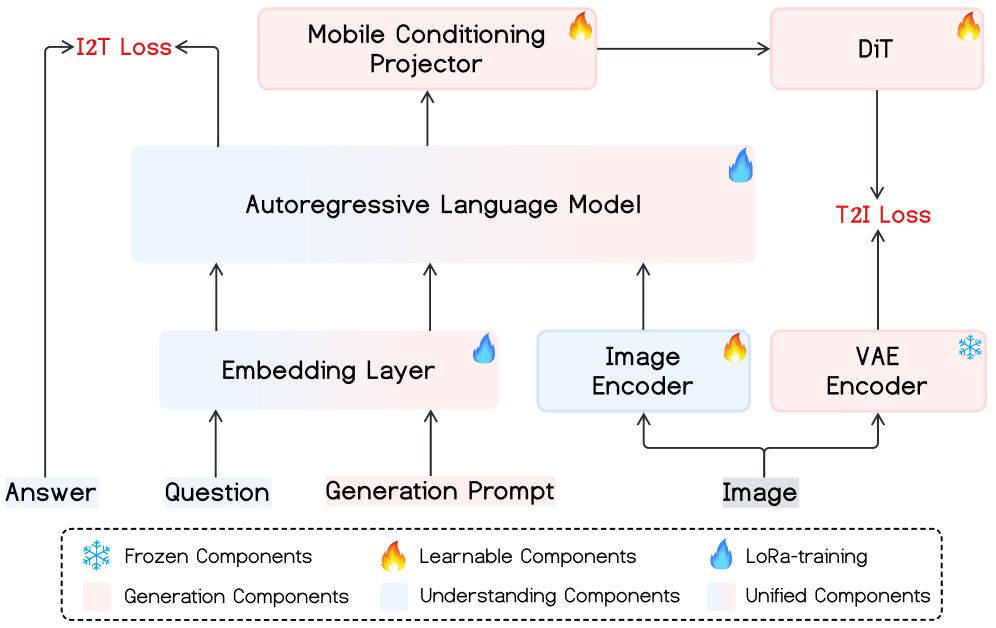
후처리 학습에는 생성 프롬프트, 이미지, 질문, 답변으로 이뤄진 quadruplet을 사용합니다. 같은 이미지에서 텍스트-이미지 생성 손실과 이미지-텍스트 이해 손실을 동시에 계산해 두 능력의 표현이 멀어지지 않도록 합니다.
원문은 수십억 개가 아닌 수백만 개 규모의 샘플로 학습했다고 설명합니다. 이미지 편집 결과는 ShareGPT4V의 46,000개 편집 샘플로 파인튜닝한 Mobile-O-0.5B에서 제시합니다.
이 데이터 효율은 매력적이지만, 좁은 편집 데이터에서 좋은 사례가 나왔다는 사실과 임의의 도메인에서 안정적으로 편집한다는 주장은 구분해야 합니다.
공동 학습에서는 한 능력을 높이는 손실이 다른 능력의 표현을 바꿀 수 있습니다. 생성 손실 비중을 키웠을 때 이미지 질문 정확도가 떨어지는지, 이해 손실을 키웠을 때 프롬프트를 따르는 생성이 약해지는지 확인해야 합니다. 총손실만 내려갔다고 두 작업이 모두 개선됐다고 말할 수는 없습니다.
quadruplet의 질문과 생성 프롬프트가 같은 이미지에서 너무 비슷한 속성을 반복하면 공유 표현의 이득이 과대평가될 수 있습니다. 질문에는 없지만 생성에 필요한 관계, 생성 프롬프트에는 없지만 이해해야 할 세부를 포함한 평가가 필요합니다. 학습에 본 이미지와 비슷한 편집뿐 아니라 새로운 대상, 구도, 문구에서 두 기능이 함께 유지되는지도 분리해 봅니다.
이미지 편집은 원본 보존과 요청 변화라는 두 목표를 동시에 봐야 합니다. 편집 결과가 선명해도 사람이나 물체의 정체성이 바뀔 수 있고, 원본을 잘 보존해도 요청한 변화가 약할 수 있습니다. 편집 샘플 수만 인용하기보다 작업 유형별 충실도와 보존 실패를 기록해야 실제 앱 범위를 정할 수 있습니다.