VTC-R1은 긴 reasoning 기록을 요약해 버리지 않고 이전 segment를 image로 렌더링해 더 적은 vision token으로 다시 읽게 함으로써 context와 KV cache 부담을 줄입니다. 효과가 있으려면 수식과 작은 글자를 VLM이 정확히 읽어야 하므로, 압축률만큼 OCR 오류도 측정해야 합니다.
긴 추론을 이미지로 저장하면 왜 빨라질까? VTC-R1의 Optical Memory
Text Trace를 반복 가능한 Image Memory로 바꾼다
긴 CoT를 모두 text token으로 유지하면 매 단계 context와 KV cache가 늘어납니다. 기존 pruning이나 token merge는 중요한 논리 연결을 지울 수 있고, 별도 summary model은 추가 학습과 오류 원인을 만듭니다. VTC-R1은 내용 요약 대신 표현 modality를 바꿉니다.
동작은 네 단계입니다. 모델이 첫 reasoning segment를 text로 생성하고, 이를 고정 너비 image로 렌더링합니다. 다음 단계에서는 원래 질문과 이전 segment image를 함께 넣어 새 text를 생성합니다. 이 과정을 답에 도달할 때까지 반복합니다. 렌더링 image가 이전 사고를 보관하는 optical memory가 됩니다.
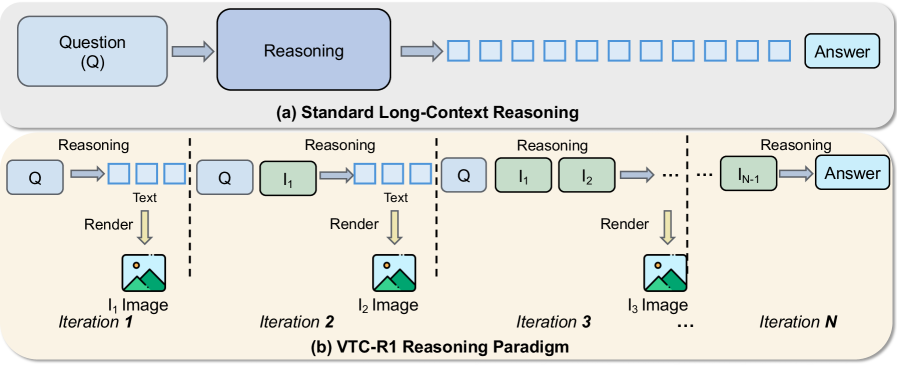
Pygame과 PIL을 사용해 text를 렌더링하고 LaTeX 스타일 수식을 보존합니다. 원문은 같은 정보를 vision token으로 표현할 때 text token보다 3~4배 적다고 설명합니다. 이는 VLM의 image patch encoding을 이용한 결과이지, image가 본질적으로 항상 text보다 정확하다는 뜻은 아닙니다.
Segment 경계를 어디에 두는지가 성능을 바꾼다
VTC-R1용 data는 OpenR1-Math-220K의 reasoning을 여러 segment로 나누고 “이전 단계 image + 질문 → 다음 단계 text” 형태로 만듭니다. Glyph-ByT5 기반 VLM과 Qwen3-VL을 사용해 image 속 수식과 논리를 이어 읽도록 SFT합니다.
너무 짧게 나누면 render와 model call 횟수가 많아지고, 너무 길게 나누면 한 image에 글자가 빽빽해져 OCR이 어려워집니다. 원문 분포에서는 대부분 이른 단계에 끝나고 일부만 네 번 넘게 반복합니다. 적절한 segment boundary를 자동 결정하는 문제는 남아 있습니다.
3.4배와 2.7배는 End-to-End 조건을 확인한다
원문은 평균 token 압축 3.4배와 end-to-end latency 2.7배 개선을 보고합니다. MATH500, AIME25, GPQA-D에서도 표준 text 방식보다 높은 결과를 제시합니다. 긴 text에서 중간 정보를 놓치는 현상을 image layout이 완화했다는 해석입니다.
하지만 효율 계산에는 text rendering 시간, vision encoder 비용, 반복 호출 수가 모두 들어가야 합니다. 짧은 문제에서는 render overhead가 절감보다 클 수 있습니다. 또한 해상도를 낮춰 vision token을 줄이면 작은 숫자, 부호, fraction bar가 뭉개질 수 있습니다. 수학 문제에서는 한 글자 오독이 뒤 reasoning 전체를 바꿉니다.
평가할 때는 정확도와 latency 외에 segment별 OCR exact match, render 시간, peak KV cache, 반복 횟수를 기록해야 합니다. 같은 token budget에서 plain text와 optical memory를 비교해야 공정합니다.
어떤 업무에 맞고 어디서 멈춰야 하는가
VTC-R1은 수식 구조가 있고 긴 reasoning history가 필요한 문제에 적합합니다. 반대로 짧은 질의나 variable name과 punctuation이 매우 중요한 code에서는 image 변환의 이득이 작거나 위험할 수 있습니다. 원문이 code 분석 가능성을 언급하지만 직접 검증된 완성 기능으로 확대해서는 안 됩니다.
실사용 전에는 font, 해상도, 한 image의 최대 줄 수를 고정하고, 압축 단계마다 원문을 되읽는 test set을 만듭니다. 오류가 일정 수준을 넘으면 text fallback을 사용해야 합니다. 이 연구의 핵심은 “사고를 그림으로 바꾸면 더 똑똑해진다”가 아니라 VLM의 vision channel을 long-context용 보조 memory로 재사용할 수 있다는 것입니다.
한 글자 오독이 reasoning에 어떻게 전파될까
수학 segment에 x < 0이 있는데 optical memory가 <를 >로 읽으면 다음 단계는 문법적으로 자연스럽지만 반대 영역에서 계산을 계속할 수 있습니다. Fraction bar, minus sign, subscript와 서로 비슷한 variable도 같은 위험이 있습니다. 최종 정답만 채점하면 어느 segment에서 정보가 바뀌었는지 찾기 어렵습니다.
그래서 반복마다 두 output을 남깁니다. 하나는 렌더링에 사용한 원문 text이고 다른 하나는 다음 호출 직전에 model 또는 독립 OCR이 다시 읽은 text입니다. 두 값을 character, math token 단위로 대조해 최초 divergence 지점을 기록합니다.
| 오류 | 다음 단계 영향 | 검증 방법 |
|---|---|---|
숫자 1과 7 혼동 | 모든 후속 계산값 변경 | 수식 token exact match |
- 또는 부등호 누락 | 해의 영역 반전 | operator별 recall |
| 줄바꿈으로 식 분리 | 전제와 결론 연결 손실 | line order, equation parse |
| Variable 이름 혼동 | 다른 값을 대입 | symbol table consistency |
오류가 검출되면 더 높은 해상도로 다시 렌더링하거나 해당 segment만 text로 유지해야 합니다. 틀린 optical memory를 다음 image에 다시 포함하면 손실이 누적되므로 자동 fallback은 첫 오독 지점에서 작동해야 합니다.
Segment 길이는 어떤 비용 곡선으로 고를까
Segment가 짧으면 글자가 크고 잘 읽히지만 render와 VLM call이 늘어납니다. 길면 call 수는 줄어도 한 image가 빽빽해지고 vision token 수와 OCR 오류가 증가합니다. 일정한 token 수만 기준으로 자르기보다 문장, 수식 block의 경계를 보존하면서 여러 최대 줄 수를 시험합니다.
1
2
3
짧은 segment: 높은 가독성 + 많은 반복 overhead
긴 segment:   적은 반복 + 작은 font, 복잡한 layout
선택 기준:    정답률을 유지하는 범위에서 end-to-end latency 최소
문제 길이별 routing도 가능합니다. 예상 reasoning이 짧으면 plain text를 유지하고 context가 임계치에 가까워질 때만 완료된 과거 segment를 image로 바꿉니다. 모든 문제를 처음부터 optical memory로 보내는 것보다 짧은 query의 overhead를 피할 수 있습니다.
2.7배 속도를 어떤 항목으로 재현할까
Latency에는 text-to-image rendering, image decode, preprocess, vision encoder, language decoding과 반복 횟수를 모두 포함합니다. GPU kernel 시간만 재면 CPU rendering과 data transfer가 빠집니다. Warm-up 뒤 batch 1에서 p50, p95를 측정하고, plain text와 같은 정답률 또는 같은 context 정보량으로 비교합니다.
Memory도 text KV cache 감소와 vision feature가 차지하는 공간을 함께 계산합니다. 3.4배 token 감소가 peak GPU memory와 동일한 비율의 감소를 보장하지는 않습니다. Vision encoder를 매 단계 다시 실행하는지 feature를 cache하는지에 따라 결과가 달라질 수 있습니다.
PoC에서는 짧은 문제, 긴 수학 CoT, punctuation이 중요한 code-like text를 나눕니다. 긴 수학에서만 속도와 정확도가 개선되고 code에서는 오독이 늘면 domain routing이 올바른 결론입니다. Optical memory는 universal replacement가 아니라 context가 길고 layout을 안정적으로 읽을 수 있는 경우에 선택할 압축 경로입니다.
특히 최종 답이 맞은 sample도 중간 optical segment를 다시 읽어, 우연한 정답이 OCR 오류율을 낮게 보이게 하지 않는지 확인해야 합니다.
함께 읽으면 이해가 이어지는 글
- olmOCR: 비전-언어 모델로 PDF 문서의 한계를 뛰어넘다 — olmOCR은 PDF 문서에서 텍스트를 추출하고 구조를 유지하는 강력한 비전-언어 모델입니다. 기존 OCR 도구의 한계를 극복하며, 연구 논문, 법률 문서, 기술 보고서 등 다양한 문서에서 깨끗한 텍스트 데이터를 생성할 수 있습니다.
- 15B Phi-4 Vision은 왜 UI, 수식 추론을 노리나: 동적 해상도와 모드 토큰 — Phi-4-reasoning-vision-15B의 동적 해상도 입력, 데이터 정제, 직접 답변, 추론 모드와 로컬 도입 전 확인할 한계를 정리합니다.
- 차트, 흐름도를 바로 읽지 말고 다시 그리면 나아질까: Thinking with Drafting — TwD가 이미지의 객체와 관계를 Logic Graphic DSL로 재구성한 뒤 검증하는 방식, VisAlg 성과와 OCR, DSL 범위 한계를 설명합니다.
자주 묻는 질문
Text를 image로 바꾸면 내용이 요약되나요?
의미를 다시 요약하기보다 같은 reasoning text를 image로 렌더링해 vision token으로 읽게 하지만 font, 해상도, tokenizer 때문에 글자 정보가 손실될 수 있습니다.
3.4배 압축이면 모든 문제에서 2.7배 빨라지나요?
아닙니다. 3.4배는 평균 token 압축이고 2.7배는 보고된 end-to-end 조건의 latency이므로 짧은 문제, render overhead, 반복 횟수에 따라 이득이 달라집니다.
Optical memory 오류는 어떻게 막나요?
Segment별 OCR exact match와 수식, 부호 검사를 하고 작은 글자나 code처럼 오독 위험이 큰 경우 원문 text를 유지하거나 오류 시 text fallback으로 전환해야 합니다.
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.