LingBot-VA는 현재 image에서 바로 action을 고르는 대신, action 뒤의 미래 visual state를 먼저 예측하고 그 변화에 맞는 action을 inverse dynamics로 복원합니다. 하지만 생성한 미래가 자연스럽게 보인다는 사실만으로 실제 물리 인과를 정확히 안다고 볼 수는 없습니다.
로봇이 미래 Frame을 맞히면 Action도 나아질까? LingBot-VA의 World Model
Video와 Action을 한 Sequence에 교차 배치한다
Behavior cloning은 관측 pixel을 action에 직접 매핑하므로 training distribution을 벗어나면 복구가 어렵고, 긴 task에서 앞선 오류가 쌓일 수 있습니다. LingBot-VA는 video world model과 policy를 따로 만들지 않고, 시간 t의 video token, action token, 다음 video token을 한 sequence에 interleave합니다.
Dual-stream Mixture-of-Transformers(MoT)는 video stream과 action stream을 구분하면서 shared context에서 연결합니다. Wan2.2-5B의 pretrained video generation weight로 visual stream을 초기화하고, 미래 latent visual state는 flow matching으로 예측합니다. action stream은 예측된 visual transition을 조건으로 대응 action을 decode합니다.
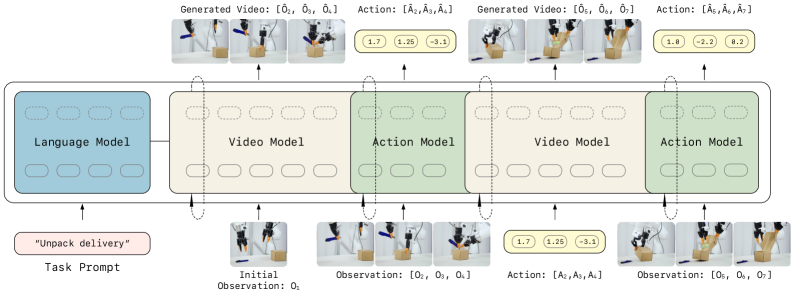
이 구조의 장점은 “이 action 뒤에 scene이 어떻게 변해야 하는가”를 policy가 명시적으로 학습한다는 점입니다. 반대로 미래 frame 예측 오류가 action으로 전달되는 새 실패 경로도 생깁니다.
Causal Mask는 미래 정보 누출을 막는다
학습 중 정답 미래 frame을 무심코 참조하면 offline score는 높아도 실제 rollout에서 작동하지 않습니다. LingBot-VA의 teacher-forcing causal attention mask는 각 token이 과거의 video와 action만 보도록 제한합니다. 원문은 이를 action과 다음 state의 인과 관계 학습으로 설명합니다.
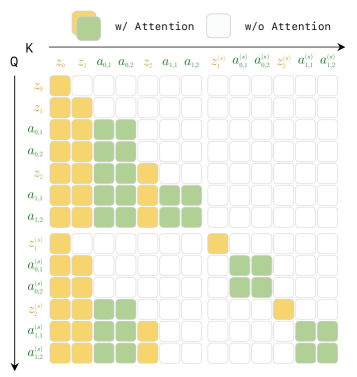
다만 causal order를 지켰다는 것과 causal mechanism을 완전히 식별했다는 것은 다릅니다. Internet video에는 action command, torque limit, 접촉력처럼 robot control에 필요한 변수가 없습니다. 화면 상관관계가 실제 motor dynamics와 어긋날 수 있으므로 robot action data를 함께 사용합니다.
비동기 추론은 지연을 숨기지만 없애지 않는다
원문 설정은 약 5B parameter, FP8 training, in-the-wild video와 robot action data의 혼합입니다. Diffusion 계열 미래 예측은 control loop에서 느릴 수 있어 action prediction과 motor execution을 병렬화하는 asynchronous pipeline을 둡니다. Closed-loop rollout에서는 실제 sensor와 예측 state를 계속 맞춰 drift를 줄입니다.
비동기화는 compute 시간을 사라지게 하지 않습니다. 이전 action을 실행하는 동안 다음 action을 계산하므로, environment가 급변하면 계산 중인 plan이 오래된 observation에 기반할 수 있습니다. 실제 검사에서는 평균 latency뿐 아니라 최악 latency, stale observation의 나이, emergency stop 반응 시간을 함께 재야 합니다.
원문은 long-horizon과 deformable-object task에서 강한 결과, 적은 post-training data로 새로운 도구에 적응한 결과, pi-0.5 계열과의 우위를 보고합니다. 이는 연구 benchmark 조건의 결과이며 실제 작업장 안전 인증을 의미하지 않습니다.
상상과 실제가 다를 때 멈출 장치가 필요하다
World model hallucination은 video artifact로 끝나지 않고 물리적 사고로 이어질 수 있습니다. predicted next state와 실제 camera state의 차이가 커지면 action을 중단하고 다시 관측하는 guardrail이 필요합니다. torque와 collision 같은 비시각 sensor도 별도 안전층에서 확인해야 합니다.
도입 순서는 future-frame 품질, inverse-dynamics action 정확도, closed-loop success를 분리해 평가하는 것입니다. 다음으로 deformable object와 out-of-distribution 배치에서 예측 오차가 action 실패와 얼마나 결속되는지 봅니다. LingBot-VA의 의미는 로봇에게 완전한 물리 simulator를 준 데 있지 않습니다. video prediction과 action policy를 한 autoregressive causal sequence로 공동 학습했다는 설계에 있습니다.
Action을 바꿨을 때 미래도 올바르게 바뀌는가
자연스러운 next frame을 맞히는 model이 action을 실제로 사용한다는 보장은 없습니다. Training video에서 가장 흔한 변화만 예측해도 visual metric이 높을 수 있습니다. 같은 현재 observation에 서로 다른 candidate action을 넣고 action 대상과 결과만 달라지는지 보는 counterfactual test가 필요합니다.
| 입력 변화 | 기대되는 예측 | 실패 신호 |
|---|---|---|
| Gripper를 열기, 닫기로 변경 | 접촉과 object 상태가 달라짐 | 두 미래가 거의 같음 |
| 이동 방향만 반대로 변경 | end-effector 경로가 반대로 바뀜 | background까지 불필요하게 변경 |
| 실행 불가능한 action | 제한, 실패 state를 표현 | 항상 성공 장면 생성 |
| Action 없이 같은 관측 반복 | 가능한 자연 변화만 발생 | 학습된 조작을 자동 재생 |
예측 video와 실제 rollout을 pixel 단위로만 비교하면 조명 변화가 큰 오차를 만들고 작은 contact 오류를 가릴 수 있습니다. Object pose, gripper state, collision, task progress처럼 control에 필요한 state를 추출해 별도 측정하는 편이 낫습니다. Deformable object는 단일 pose로 충분하지 않으므로 shape, contact와 최종 task success까지 봅니다.
오류가 어느 모듈에서 Action으로 전달됐는지 나눈다
실패는 future predictor, inverse dynamics, asynchronous runtime의 세 경로로 나눌 수 있습니다. 미래 state 자체가 틀렸지만 action이 맞는 경우, 미래는 맞았지만 action decoder가 관절 명령을 잘못 낸 경우, 둘 다 맞지만 오래된 결과가 늦게 실행된 경우를 같은 success rate로 합치면 수정 지점을 찾기 어렵습니다.
진단용으로 정답 next state를 inverse-dynamics branch에 넣는 oracle test를 둡니다. 이 조건에서도 action이 틀리면 decoder 또는 action representation이 병목입니다. 정답 action을 넣었는데 visual future가 틀리면 world model 쪽 오류입니다. 두 branch가 단독으로 맞지만 closed loop에서 무너지면 drift correction이나 scheduler를 먼저 봅니다.
Asynchronous pipeline에는 observation timestamp, predicted horizon, action generation completion과 actuator execution 시간을 연결해 기록합니다. 예측이 정확해도 실행 시점에 object가 이미 이동했다면 stale plan입니다. Action age가 상한을 넘으면 결과를 버리고, 급격한 scene 변화에서는 계산 중인 plan을 취소하는 규칙이 필요합니다.
현장 안전 기준은 visual error보다 앞선다
Predicted, observed state 차이를 하나의 평균 threshold로 두면 background 변화에 과민하거나 작은 위험 object에 둔감할 수 있습니다. Gripper 주변, 사람, obstacle처럼 safety-critical region에 더 높은 가중치를 주고 torque, force, joint limit은 video model과 독립적으로 검사합니다.
PoC의 합격 기준은 선명한 rollout video가 아닙니다. Candidate action 변화에 미래가 올바르게 반응하고, oracle ablation으로 두 branch의 오류가 허용 범위이며, drift가 생겼을 때 deadline 안에 중단, 재계획하는지를 확인해야 합니다. 이 조건을 만족할 때 world prediction이 실제 control의 유용한 중간 표현이 됩니다.
함께 읽으면 이해가 이어지는 글
- 로봇은 미래 픽셀까지 그려야 할까? FRAPPE의 다중 VFM 정렬 — FRAPPE가 다음 화면의 픽셀 대신 여러 시각 기초 모델의 미래 표현을 맞추는 이유와 장기 조작에서 얻는 이점, 계산 비용을 정리합니다.
- 로봇 비디오가 물체를 뚫고 지나간다면? Kinema4D의 URDF, Pointmap 제어 — 로봇 기구학에서 만든 3D 궤적과 pointmap을 비디오 생성에 넣는 Kinema4D의 구조, Robo4D-200K 학습 범위와 물리 한계를 살펴봅니다.
- 로봇이 목표까지의 중간 장면을 상상하면 왜 나아질까? Act2Goal의 MSTH — Act2Goal이 현재 image와 goal image 사이의 중간 상태를 visual world model로 만들고, 가까운 미래는 촘촘하게 먼 미래는 성기게 읽는 MSTH로 control에 연결하는 방식을 설명합니다.
자주 묻는 질문
미래 frame이 선명하면 robot action도 정확한가요?
아닙니다. 시각적 품질과 action-conditioned state transition의 정확도는 다르며 inverse dynamics, contact, torque와 closed-loop 성공을 따로 검증해야 합니다.
Causal mask를 쓰면 물리적 인과를 학습한 건가요?
미래 token 누출은 막지만 관측되지 않은 힘, 마찰, 명령 같은 confounder까지 식별하지는 못하므로 action intervention과 실제 rollout 비교가 필요합니다.
예측한 미래와 실제 camera가 다르면 어떻게 해야 하나요?
오차가 threshold를 넘으면 남은 action chunk를 폐기하고 새 관측으로 다시 계획하며 torque, collision sensor와 독립 safety controller가 실행을 제한해야 합니다.
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.