LoL은 12시간 video를 한 번에 기억하는 모델이 아니라 초기, 최근 frame만 남기는 streaming generation에서 attention head가 과거 sink에 동시에 쏠리는 붕괴를 RoPE jitter로 늦추는 방법입니다. 화면이 오래 이어졌다는 결과와 12시간 동안 같은 서사를 이해했다는 주장은 구분해야 합니다.
12시간 AI 영상은 정말 일관적인가? LoL의 Sink-Collapse와 RoPE Jitter
긴 Video는 Memory보다 Sink-Collapse에서 무너진다
Autoregressive video model은 frame을 순차 생성하므로 전체 sequence를 양방향 attention으로 처리하는 방식보다 streaming에 유리합니다. 하지만 KV cache를 계속 늘릴 수 없어 첫 몇 frame과 최근 window만 남기는 attention sink 방식을 사용합니다.
초기 frame은 character와 scene의 anchor가 되지만 너무 강한 attractor가 될 수 있습니다. 시간이 지나면서 여러 attention head가 같은 sink frame을 참조하면 화면이 처음 장면으로 돌아가거나 motion이 반복되는 sink-collapse가 발생합니다. LoL은 이를 단순한 model capacity 부족이 아니라 RoPE의 주기와 inter-head attention homogenization의 문제로 분석합니다.
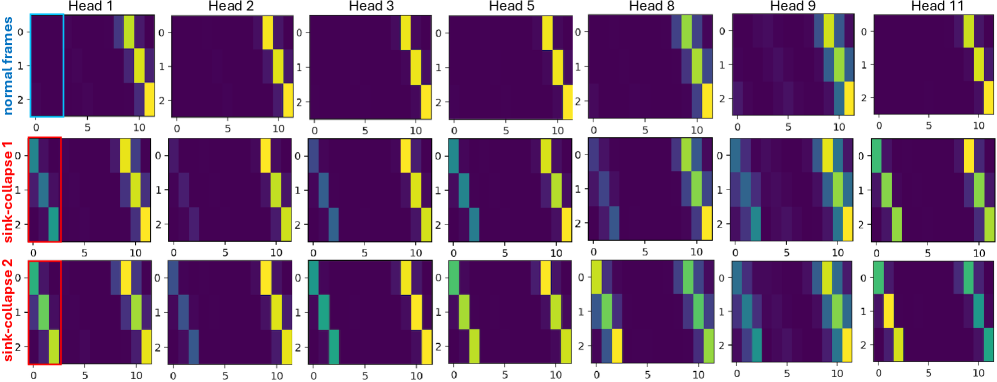
Head마다 RoPE 위상을 조금씩 다르게 만든다
Multi-head RoPE Jitter는 각 attention head의 RoPE base frequency 또는 phase에 작은 무작위 차이를 줍니다. 모든 head가 같은 위치 bias를 갖는 시점을 흩어 놓아 sink frame으로 동시에 수렴하는 것을 막습니다. 서로 다른 head가 시간 context의 다른 부분을 보게 하는 셈입니다.
원문의 구현은 Lumina-Next-T2V 계열 DiT, 고정 sliding-window KV cache, 처음 3~5 frame의 attention sink를 설명합니다. 생성한 frame은 바로 encode, 저장한 뒤 memory에서 비우는 streaming pipeline을 사용합니다. 기존 checkpoint를 다시 학습하지 않고 inference 시 jitter를 넣는 training-free 방식이라는 점이 장점입니다.
다만 “몇 줄 추가”라는 설명만으로 완전한 재현 절차가 되지는 않습니다. jitter distribution과 크기, 적용 layer, random seed가 결과에 영향을 줄 수 있으며 원문도 최적 분포의 이론을 충분히 확정하지 않습니다.
12시간 Result는 세 종류의 일관성으로 나눠 본다
원문은 12시간, 약 129만 6천 frame 이상을 생성했고 FVD가 안정적이며 temporal consistency가 약 25% 개선됐다고 보고합니다. 이 숫자는 model, prompt, frame rate, 평가 방법에 묶인 연구 결과입니다.
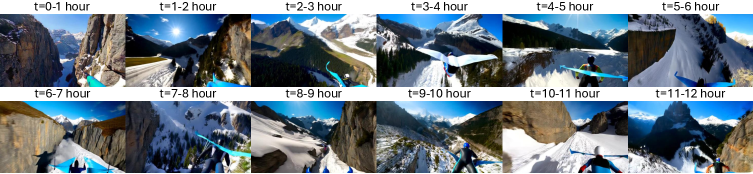
“일관성”은 최소 세 층으로 나눠야 합니다.
- local motion: 인접 frame이 부드럽게 연결되는가
- visual identity: 사람, 배경이 오래 지나도 같은가
- semantic intent: 초기 prompt의 사건과 목적이 계속 유지되는가
RoPE jitter는 sink-collapse와 시각적 반복을 다루지만 상위 story plan을 별도로 제공하지 않습니다. 화면이 무너지지 않아도 이야기가 다른 방향으로 흐르는 semantic drift는 남을 수 있습니다.
Training-free라도 12시간 GPU 비용은 사라지지 않는다
고정 KV cache는 peak memory를 제한하지만, video가 길어질수록 총 inference 시간과 저장 비용은 계속 증가합니다. 12시간 동안 GPU를 가동하는 비용도 작지 않습니다. 특정 domain에서는 jitter가 artifact를 만들 가능성도 있으므로 짧은 성공 sample만으로 production 도입을 결정하면 안 됩니다.
검증 순서는 단순합니다. 같은 prompt와 seed에서 jitter on/off의 scene reset 시점을 비교하고, head attention이 한 sink에 모이는지 확인합니다. 그다음 10분, 1시간, 12시간 구간별 identity와 prompt adherence를 따로 평가하고 총 GPU 시간과 storage를 기록합니다. LoL의 성과는 “무한 world simulator”가 아니라 장기 streaming을 막던 특정 position-encoding 붕괴에 작은 inference-time 개입을 제시한 것입니다.
Jitter가 collapse를 늦췄는지 어떤 ablation으로 볼까
단순히 LoL sample과 baseline sample 하나를 비교하면 random generation 차이를 method 효과로 오해할 수 있습니다. 같은 checkpoint, prompt, seed, sliding-window 크기에서 jitter만 on/off하고 여러 duration에 반복합니다. Jitter 크기를 0에서 점차 늘려 collapse 시간과 artifact를 함께 기록해야 합니다.
| 측정 | 좋아져야 할 방향 | 과도한 jitter의 신호 |
|---|---|---|
| Head attention similarity | head마다 보는 시간 위치가 다양해짐 | attention이 무작위로 흩어져 context 활용 저하 |
| Scene reset 시점 | 더 늦게 발생 | sudden motion, texture flicker 증가 |
| Identity consistency | 장기 유지 | 얼굴, 형태가 작은 phase 변화마다 흔들림 |
| Prompt adherence | 최소한 유지 | sink는 피하지만 내용이 빠르게 drift |
Jitter distribution과 seed별 분산을 공개해야 “특정 운 좋은 run”을 걸러낼 수 있습니다. Sliding window와 sink frame 수를 바꾸면 최적 jitter도 달라질 수 있으므로 처음 3~5 frame 설정을 모든 model의 고정 법칙처럼 사용하면 안 됩니다.
12시간 일관성은 어떤 checkpoint로 나눌까
한 사람이 같은 옷을 입고 방을 걷는 prompt를 예로 들면 매 10분마다 identity, 의상, 방 layout, motion 방향과 prompt event를 기록할 수 있습니다. Local smoothness가 높은데 2시간 뒤 다른 방으로 바뀌었다면 temporal metric 하나로는 semantic drift를 놓친 것입니다.
1
2
3
4
10분: 인접 frame motion과 artifact
1시간: 인물, object identity, scene geometry
6시간: 처음 prompt의 목적과 반복 pattern
12시간: reset, collapse 발생 여부와 누적 drift
초기 sink가 anchor 역할을 하므로 처음 frame 자체가 잘못 생성된 경우에는 오히려 오류가 오래 유지될 수 있습니다. Prompt와 anchor가 충돌하는 sample, scene transition이 필수인 prompt, 여러 character가 드나드는 prompt를 함께 시험해야 “한 장면을 오래 유지하는 능력”과 “긴 이야기를 진행하는 능력”을 구분할 수 있습니다.
운영 비용과 중단 기준은 어떻게 세울까
Peak KV memory가 고정돼도 매 frame의 DiT 연산은 계속됩니다. 목표 FPS, GPU hour, output codec와 resolution을 기준으로 10분, 1시간, 12시간의 wall-clock과 storage를 계산합니다. Generated frame을 즉시 encode하더라도 최종 video storage와 실패 run의 비용은 남습니다.
Production에서는 identity score가 임계치 아래로 떨어지거나 attention similarity가 급격히 올라가고 scene reset이 감지되면 계속 12시간을 생성하지 않고 checkpoint에서 재시작하는 편이 비용을 줄일 수 있습니다. 재시작이 narrative state를 복구하지 못하면 사람이 승인한 keyframe과 story state를 다시 주입하는 별도 설계가 필요합니다.
결국 LoL을 선택할 조건은 같은 비용에서 baseline보다 collapse까지의 시간이 길고, jitter artifact가 허용되며, 필요한 semantic continuity까지 유지되는 경우입니다. 가장 긴 성공 sample의 길이만으로는 이 세 조건을 판정할 수 없습니다.
함께 읽으면 이해가 이어지는 글
- AI 영상의 소리와 장면이 어긋난다면? JavisDiT++의 시간 정렬 — JavisDiT++가 공유 attention과 모달리티별 FFN, TA-RoPE, AV-DPO로 영상과 오디오를 함께 생성하는 원리와 100만 데이터 결과의 범위를 짚습니다.
- 대화문만으로 장편 AI 영상을 만들 수 있을까: ScripterAgent와 VSA의 현실적 한계 — 대화를 장면별 실행 대본으로 바꾸는 두 에이전트 구조와 장면 일관성, 평가, 비용의 한계를 짚습니다.
- 알리바바 Wan 3.0 공개 베타 개시, 문서 입력으로 30초 AI 비디오 원컷 생성 — 알리바바 클라우드가 차세대 비디오 생성 AI 모델인 Wan 3.0(통의완상 3.0)의 공개 베타 테스트를 시작했습니다. 기존 15초에서 2배 늘어난 최대 30초 단일 샷 비디오 생성을 지원하며, PDF와 PPT 등 오피스 문서와…
자주 묻는 질문
LoL은 12시간 영상의 모든 사건을 기억하나요?
아닙니다. 고정 KV cache에서 초기 sink와 최근 window를 쓰며 sink-collapse를 늦춘 결과이므로 장기 story memory와 과거 사건 recall은 별도 기능으로 봐야 합니다.
Training-free이면 어떤 checkpoint에도 같은 jitter를 넣으면 되나요?
재학습이 필요 없다는 뜻이지 parameter-free라는 뜻은 아닙니다. Jitter 크기, 분포, layer, seed가 artifact와 안정성에 영향을 줄 수 있어 model별 sweep이 필요합니다.
12시간 생성의 비용은 일정한가요?
고정 cache는 peak attention memory를 제한하지만 총 inference 시간, GPU 사용량과 frame 저장량은 duration에 따라 계속 증가하므로 시간당 비용을 따로 계산해야 합니다.
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.