약 100만 데이터 결과는 어디까지 말해 주나요?
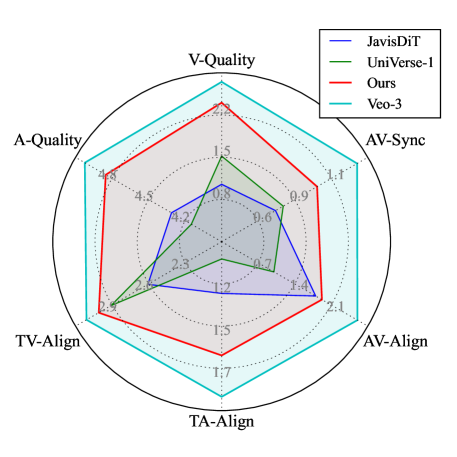
원문은 기존 오픈소스 joint audio-video generation 모델보다 강한 결과와 상용 모델과 좁아진 격차를 제시합니다. 약 100만 개 데이터로 얻은 효율은 주목할 만하지만, 데이터 수만으로 전체 학습 비용이나 재현 난도를 판단할 수는 없습니다. 해상도, 영상 길이, 학습 스텝과 GPU 구성도 함께 봐야 합니다.
실무 검증에서는 평균 선호도 외에 다음 실패 장면을 따로 모아야 합니다.
- 여러 사람이 동시에 말하거나 소리가 겹치는 장면
- 폭발음, 대사, 배경음악이 함께 있는 장면
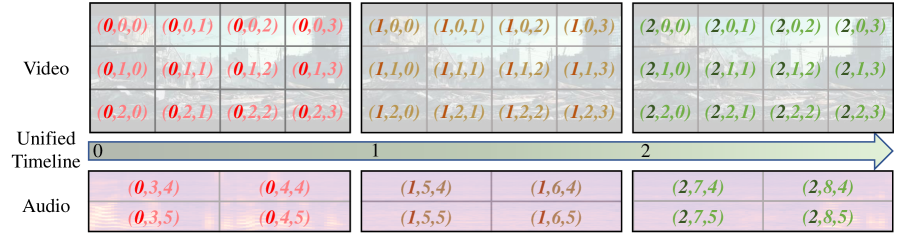
- 긴 영상에서 시간 오차가 누적되는 구간
- 작은 기반 모델이 물체 상호작용을 잘못 그리는 사례
- 프롬프트에 없는 소리나 화면 요소가 생기는 사례
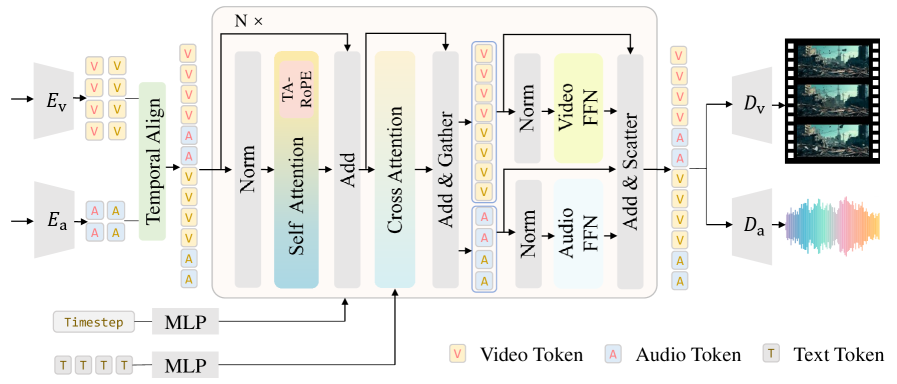
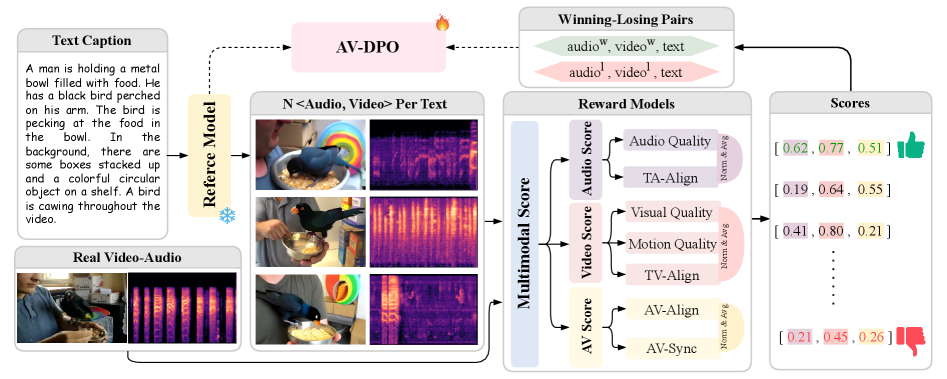
JavisDiT++는 오픈소스 공동 생성 모델의 설계 선택을 구체적으로 보여 줍니다. 결론은 “Veo3를 대체했다”가 아니라, 공유, 분리, 시간 정렬, 선호 최적화를 한 체계에 넣었을 때 데이터 효율과 A/V 일관성을 함께 개선할 수 있다는 것입니다.
데이터 수에는 영상 길이, 해상도, 오디오 품질과 중복 정도가 드러나지 않습니다. 같은 장면을 여러 클립으로 자른 샘플이 많다면 표면적인 수는 커도 사건 다양성은 제한될 수 있습니다. 학습과 평가에 같은 원본 영상의 구간이 걸치지 않는지, 오디오가 재사용되거나 자동 합성된 비율이 있는지 확인해야 일반화를 해석할 수 있습니다.
재현 비용은 샘플 수 외에 두 모달리티의 디코딩, 공동 attention의 시퀀스 길이와 학습 스텝에 달려 있습니다. 목표 하드웨어에서 생성 길이별 peak VRAM과 처리 시간, 실패한 결과를 다시 만드는 비용을 측정합니다. 분리형 파이프라인과 비교할 때는 오디오 후처리와 동기화 수정에 드는 사람 시간도 포함합니다.
사람 음성과 얼굴이 포함된 학습, 생성 데이터는 사용 권리와 동의를 확인해야 합니다. 오디오, 비디오를 함께 생성하는 모델은 한 모달리티의 허가를 다른 모달리티까지 자동으로 확장하지 않으며, 합성 결과가 실제 기록으로 오해되지 않게 표시할 운영 기준도 필요합니다.
실무에서는 대사 중심, 효과음 중심, 음악이 있는 장면처럼 목표 작업을 나눠 JavisDiT++와 분리형 기준선을 비교하는 것이 출발점입니다. 같은 품질에서 동기화 실패율과 총 생성, 검수 시간을 줄일 때 통합 구조의 이점이 확인됩니다.