단일 모델은 분리형 파이프라인의 어떤 문제를 줄이나요?
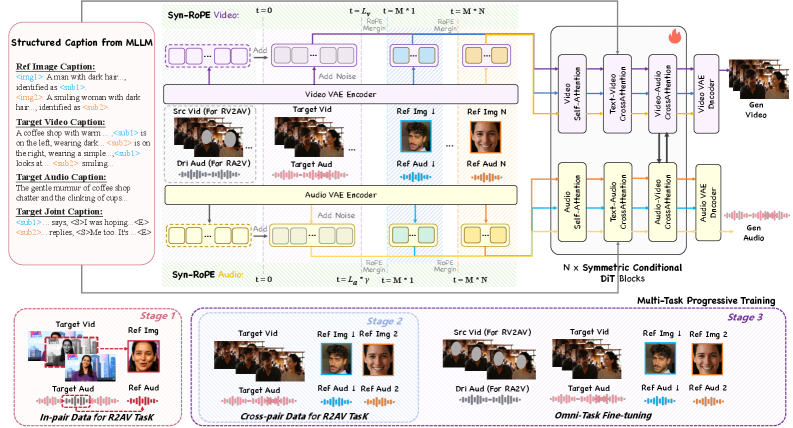
기존에는 생성, 편집, 립싱크를 서로 다른 모델이 맡기 쉬웠습니다. 단계가 나뉘면 각 모델의 얼굴 표현과 시간 기준이 달라지고, 앞 단계의 오류가 다음 단계로 넘어갑니다. DreamID-Omni의 Symmetric Conditional DiT는 시각 조건과 청각 조건을 대칭적으로 주입해 어느 한쪽만 부가 정보로 취급하지 않습니다.
통합의 의미는 모델 수를 줄이는 데만 있지 않습니다. 오디오와 비디오가 같은 생성 과정에서 서로의 시간과 인물 정보를 보게 해, 나중에 억지로 맞추는 부담을 줄이는 데 있습니다. 반면 두 모달리티를 동시에 처리하므로 학습과 추론의 메모리 요구가 가벼워진다고 단정할 수는 없습니다.
분리형 파이프라인에서는 각 단계의 입력과 출력이 명확해 한 모듈만 교체하기 쉽지만, 얼굴 특징, 프레임률, 오디오 타임라인을 단계마다 다시 맞춰야 합니다. 통합 모델은 이 중간 변환을 줄일 수 있는 대신 한 작업의 변경이 다른 두 작업에 영향을 줄 수 있습니다. 유지보수 관점에서는 모델 수뿐 아니라 재학습 범위와 오류 격리 가능성을 함께 비교해야 합니다.
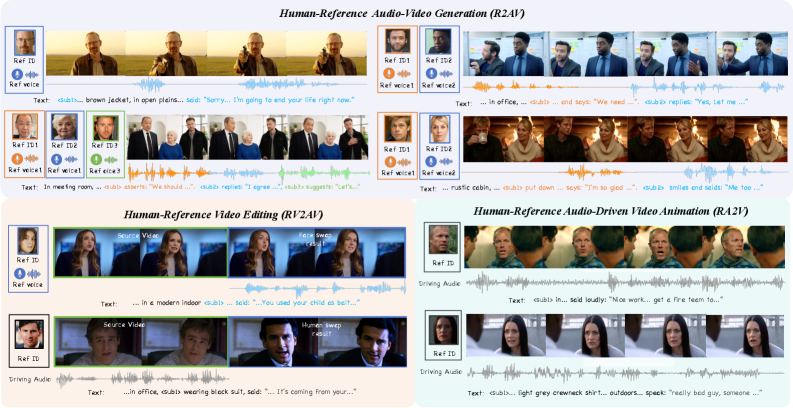
R2AV는 참조 이미지에서 움직임과 소리를 모두 만들어야 하고, RV2AV는 기존 영상의 정체성과 배경을 보존하면서 수정해야 하며, RA2V는 주어진 오디오의 시간축을 따라야 합니다. 입력 제약이 서로 다르므로 같은 모델이 세 인터페이스를 받는다는 사실만으로 같은 품질을 보장하지 않습니다. 작업별 성공 기준을 따로 두어야 통합이 어느 경로에 이득인지 알 수 있습니다.