포스트

긴 대화 RAG에서 관련 문서를 다시 골라야 할까? QRRanker의 4B 해법

다시 골라야 합니다. 검색기가 뽑은 문서가 모두 비슷해 보여도 긴 대화의 현재 질문에 답하는 근거는 다를 수 있으며, QRRanker는 4B 모델의 특정 attention head를 이용해 후보들의 순서를 함께 조정합니다.

논문은 컨텍스트 창을 늘리는 것만으로 중간 정보 소실과 계산 비용이 해결되지 않는다고 봅니다. 먼저 빠른 retriever가 후보를 좁히고, 그다음 query-focused reranker가 질문과 각 문서의 관계를 정밀하게 비교하는 두 단계 구조입니다.

Pointwise 점수와 Listwise 순위는 무엇이 다른가요?

Pointwise 방식은 문서를 하나씩 독립적으로 보고 관련 점수를 냅니다. 구현은 단순하지만 후보끼리 내용이 겹치거나 서로 보완하는 관계를 직접 비교하기 어렵습니다. Listwise 방식은 여러 후보를 같은 문맥에서 보며 상대 순서를 정합니다.

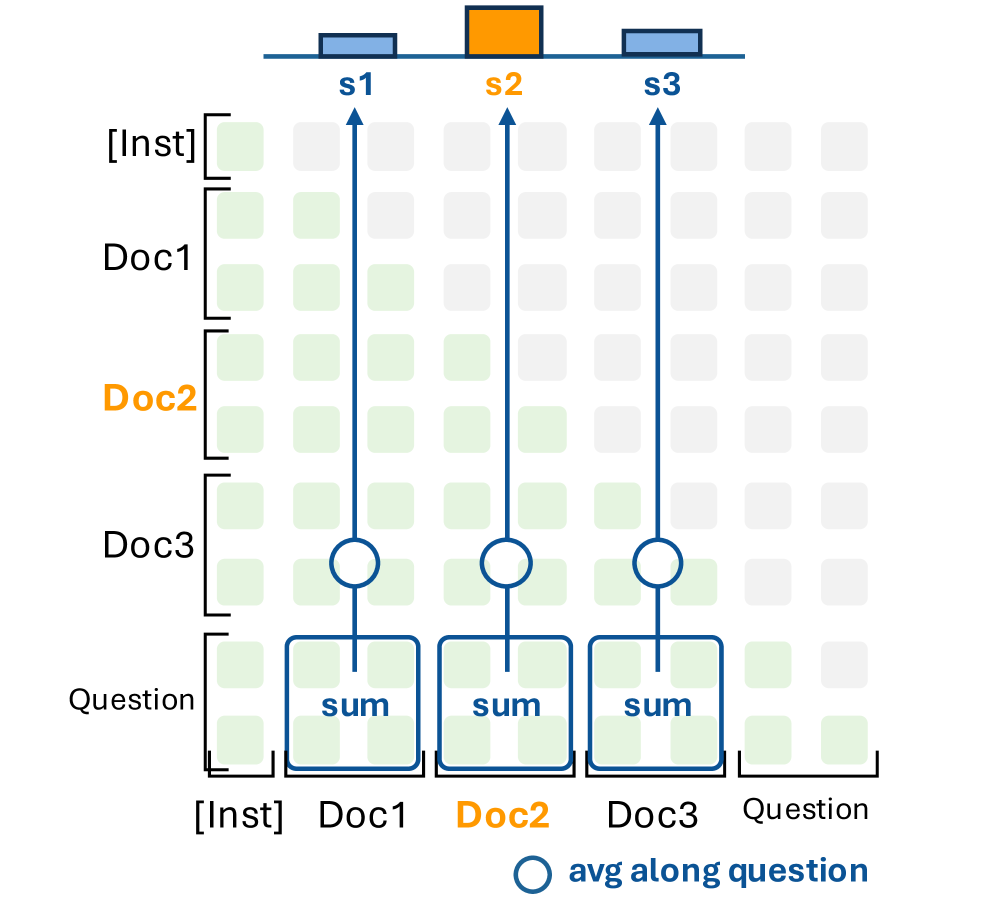
QRRanker는 질문 토큰이 문서 토큰을 볼 때 특정 attention head가 보이는 패턴에 주목합니다. 정답 문서에 강하게 반응하도록 학습한 query-focused retrieval head의 attention을 QR score로 사용합니다.

QR score가 정답 문서를 찾는 방식

별도의 거대한 점수 모델을 붙이기보다 트랜스포머 안에 있는 검색 신호를 재사용한다는 것이 핵심입니다. 다만 아무 head나 같은 품질의 검색 신호를 내는 것은 아니므로, 어떤 레이어와 head를 선택하고 학습할지가 성능을 좌우합니다.

Pointwise 점수는 각 문서를 독립적으로 처리해 병렬화하기 쉽지만 후보 집합 안의 중복을 직접 보지 못합니다. 같은 근거를 표현만 바꾼 문서가 여럿 있으면 모두 높은 점수를 받고, 서로 다른 두 문서가 함께 있어야 답할 수 있는 질문은 각각 낮게 평가될 수 있습니다. Listwise 입력은 이 상대 관계를 볼 수 있는 대신 후보 수와 전체 토큰이 늘 때 비용이 빠르게 커집니다.

후보 순서가 모델 출력에 영향을 주는지도 확인해야 합니다. 같은 문서 집합을 여러 순서로 넣었을 때 상위 결과가 크게 바뀐다면 내용 관련도뿐 아니라 위치 편향을 학습했을 수 있습니다. 정답 문서를 처음, 중간, 끝에 놓는 대조로 query-focused head가 실제 질문 근거를 찾는지 시험할 수 있습니다.

Query-focused attention head는 어떻게 검증하나요?

특정 head의 attention이 정답 문서에 집중한다는 관찰은 유용하지만 attention 값 자체가 완전한 설명은 아닙니다. 높은 attention을 받은 토큰을 가리거나 후보 문서를 바꿨을 때 순위와 답변이 예상대로 변하는지 확인해야 합니다. head 선택을 학습한 데이터에서만 평가하면 그 위치가 일반적인 검색 신호처럼 보일 수 있으므로 보지 못한 질의 유형과 도메인을 따로 둡니다.

문서 길이가 다르면 긴 문서가 attention 질량을 더 많이 받거나 짧은 핵심 문장이 희석될 수 있습니다. QR score가 토큰 수에 어떻게 정규화되는지, 표와 코드처럼 토큰화가 긴 구간에서 편향이 생기는지 봅니다. 같은 근거를 짧은 문단과 긴 문서 안에 넣은 조건을 비교하면 길이 효과를 분리할 수 있습니다.

모델을 양자화하거나 다른 attention 구현으로 배포할 때 head 점수의 상대 순서가 유지되는지도 확인합니다. 최종 답변 품질만 보면 작은 순위 변화가 특정 고위험 문서에서 발생한 사실을 놓칠 수 있으므로 기준 질의의 상위 $k$ 목록을 회귀 데이터로 남기는 편이 좋습니다.

Memory-aware는 무엇을 더 저장한다는 뜻인가요?

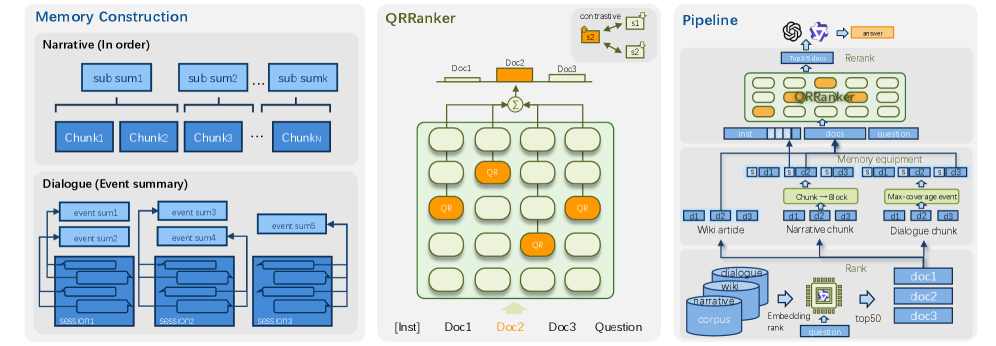
긴 대화나 서사 질문은 현재 문장만으로 검색 의도가 드러나지 않을 수 있습니다. QRRanker는 과거 대화나 이야기에서 핵심 정보를 memory로 구성하고, 현재 질문과 후보 문서를 평가할 때 함께 사용합니다.

QRRanker의 memory-aware rank-rerank 구조

예를 들어 현재 질문이 “그때 약속한 장소”를 묻는다면, “그때”가 가리키는 사건을 대화 메모리에서 보충해야 문서 순위를 제대로 정할 수 있습니다. 원문은 긴 대화 이해를 평가하는 LoCoMo에서 강한 결과를 보고합니다.

메모리를 많이 넣는 것이 항상 유리하지는 않습니다. 오래되거나 잘못 요약된 기억이 들어가면 관련 없는 문서가 위로 올라올 수 있고, 메모리 생성과 갱신 비용도 추가됩니다.

메모리는 현재 질문의 생략된 대상을 복원하는 데 필요한 최소 사실을 담아야 합니다. 대화 전체를 다시 넣으면 장문 처리 문제를 reranker 앞단으로 옮길 뿐이고, 너무 짧게 압축하면 “그때”가 가리키는 인물, 장소와 시점을 잃을 수 있습니다. 결정된 사실, 사용자의 현재 목표와 출처가 있는 사건을 분리해 저장하는 것이 좋습니다.

요약 메모리에 추측이 들어가면 순위 오류가 반복됩니다. “사용자가 서울에서 만나기로 했다”는 확정 발화와 “아마 서울을 선호한다”는 모델 추론을 같은 신뢰도로 넣지 말고, 원문 턴과 생성 시점을 연결합니다. 사용자가 정정했을 때 과거 요약과 검색 캐시가 함께 갱신되는지도 시험합니다.
기억이 검색 순위를 왜곡하는지는 어떻게 찾나요?

현재 질문만 넣은 조건, 정확한 메모리를 넣은 조건, 오래되거나 모순된 메모리를 넣은 조건을 같은 후보 집합에서 비교합니다. 정확한 메모리로 정답 순위가 오르면서 잘못된 메모리에서는 보수적으로 떨어지거나 충돌을 표시해야 운영에 쓰기 쉽습니다. 어떤 메모리든 넣기만 하면 한 문서가 과도하게 올라오는 구조라면 오염에 취약합니다.

메모리 제거 대조도 중요합니다. 특정 문서가 상위에 오른 이유를 설명할 때 현재 질문의 단어와 메모리의 보충 사실을 구분해 보여 줄 수 있어야 합니다. 사용자가 과거 대화를 삭제했다면 그 메모리를 제외한 재순위 결과가 즉시 반영되는지 확인합니다.

4B라는 규모를 운영 비용으로 바로 바꾸면 왜 안 되나요?

논문은 4B 규모 모델로 기존의 더 큰 pointwise, listwise reranker와 경쟁하는 성능을 제시합니다. 작은 파라미터 수는 배포 가능성을 높이지만, 인프라 비용이 일정 비율로 자동 절감된다는 뜻은 아닙니다.

실제 지연은 후보 수, 문서 길이, batching, attention 구현, GPU 종류에 따라 달라집니다. 특히 listwise 입력이 길어지면 한 번의 호출이 무거워질 수 있습니다. 70B 모델과 4B 모델의 크기만 비교하기보다 같은 후보 수와 recall 목표에서 처리량과 꼬리 지연을 재야 합니다.

listwise 입력은 후보를 한 번에 비교하므로 후보 수를 두 배로 늘릴 때 메모리와 지연이 단순히 두 배가 되지 않을 수 있습니다. 최대 입력 길이를 넘으면 문서를 자르거나 후보를 여러 묶음으로 나눠야 하고, 묶음별 순위를 다시 합치는 과정에서 전역 비교 이점이 줄 수 있습니다. 목표 하드웨어에서 후보 수, 문서 길이별 한계를 먼저 측정합니다.

4B 모델을 낮은 정밀도로 배포하면 메모리는 줄 수 있지만 미세한 순위 차이가 흔들릴 수 있습니다. 원본과 양자화 모델의 상위 결과 일치율, 정답 근거의 순위 변화와 p95 지연을 같이 봅니다. 파라미터 수가 작아도 요청마다 긴 문서를 읽으면 임베딩 기반 1차 검색보다 비용이 큰 구간이 남습니다.

후보 수는 어느 지점에서 멈춰야 하나요?

reranker는 첫 retriever가 놓친 문서를 새로 만들어낼 수 없습니다. 후보 수를 줄이면 listwise 비용은 낮아지지만 정답 recall 상한도 함께 낮아집니다. 먼저 retriever의 후보 수별 recall을 구하고, 정답이 들어온 구간에서 QRRanker가 상위 $k$로 올리는 이득을 따로 측정해야 합니다.

후보를 늘렸는데 상위 문서가 거의 바뀌지 않고 지연만 커지는 지점은 실용적인 중단점입니다. 반대로 서로 다른 문서 두 개를 결합해야 하는 질문에서는 한 정답 문서 기준 recall만으로 충분하지 않으므로 필요한 근거 집합이 모두 포함되는지를 봅니다. 질문 유형별 후보 예산을 다르게 두는 방법도 검토할 수 있습니다.

기존 RAG에 붙일 때 무엇을 같은 조건으로 비교해야 하나요?

기존 파이프라인을 전부 바꾸기 전에 retriever가 뽑은 상위 후보에만 QRRanker를 적용하는 실험이 적절합니다. 다음 네 지표를 함께 보면 순위 개선이 최종 답변으로 이어지는지 알 수 있습니다.

  1. 정답 근거가 상위 $k$개 안에 들어오는 비율
  2. reranking 전후의 답변 정확도
  3. 후보 수에 따른 p95 지연과 메모리 사용량
  4. 오래된 memory를 넣었을 때의 성능 하락

도메인 문서로 특정 attention head를 조정할 수 있지만, 원문은 모든 도메인에서 같은 head 위치가 최적이라고 보장하지 않습니다. 법률, 의료처럼 오류 비용이 큰 분야에서는 순위 점수만으로 근거를 확정하지 말고 원문 인용과 사람 검토를 유지해야 합니다.

QRRanker의 가치는 긴 문맥을 무조건 모델에 더 넣는 대신, 현재 질문에 필요한 부분을 먼저 고르는 데 있습니다. 성능 판단도 모델 크기보다 “같은 지연 예산에서 올바른 근거를 더 앞에 놓는가”로 해야 합니다.

최종 답변 평가에서는 상위 문서가 바뀌었는데 생성 모델이 실제로 그 근거를 사용했는지도 확인합니다. 재순위 점수는 좋아졌지만 답변이 그대로라면 프롬프트의 문서 배치나 인용 방식이 병목일 수 있습니다. 반대로 답변이 좋아졌어도 원문에 없는 내용을 만들었다면 reranker 성능으로 설명해서는 안 됩니다.

운영 로그에는 원래 후보 순위, QR score, 사용한 메모리와 최종 인용을 연결하되 민감한 대화 원문을 불필요하게 복제하지 않습니다. 모델이나 head를 바꿀 때 대표 질의의 순위 회귀를 다시 실행하면 긴 문맥 성능이 평균 뒤에서 조용히 나빠지는 일을 줄일 수 있습니다.

함께 읽으면 이해가 이어지는 글

THE END / OPSOAI

여기까지 읽었습니다

핵심 장면을 한 번 더 떠올려 보세요. 이해가 남았다면 이 책은 제 역할을 다했습니다.

다른 책 고르기
표지 1 —

←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.

CONTENTS

이 책의 목차

    8개 장 18 분읽는 시간