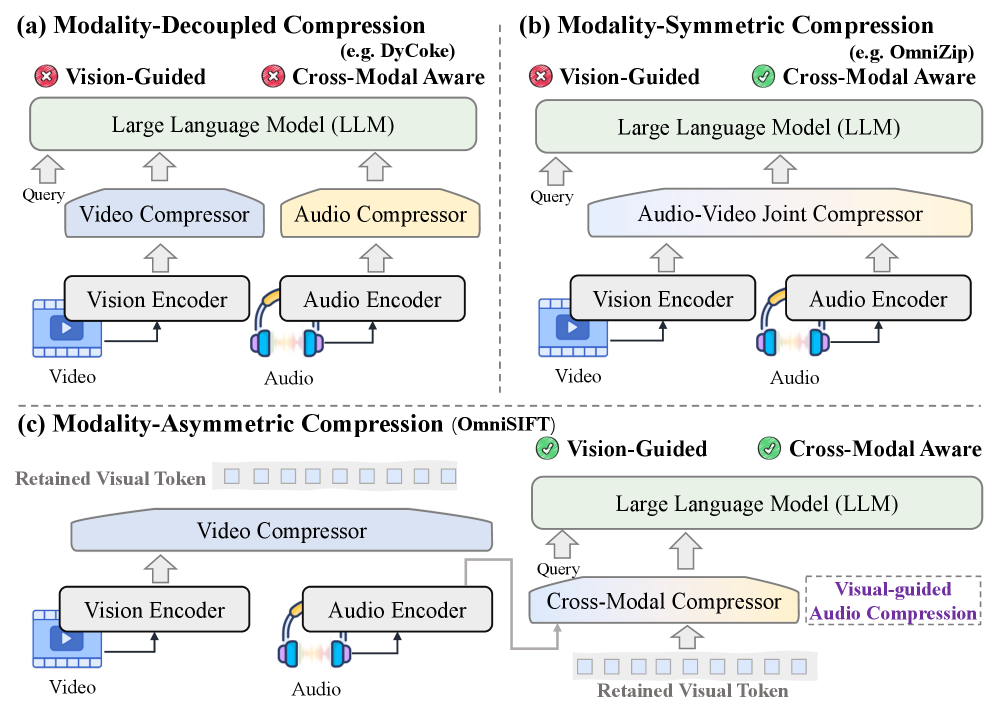
Video와 audio token을 같은 비율로 줄이면 두 modality의 정보 밀도와 사건 시점이 다른데도 동일하게 취급해 중요한 소리나 장면을 버릴 수 있습니다. OmniSIFT는 video를 먼저 압축하고 남은 visual anchor를 이용해 관련 audio를 고르는 비대칭 구조입니다.
영상, 음성 Token을 똑같이 줄이면 왜 안 될까? OmniSIFT의 비대칭 압축
먼저 Video의 공간, 시간 중복을 제거한다
Omni-modal LLM은 frame patch와 audio segment를 모두 token으로 바꾸므로 짧은 clip도 context가 빠르게 커집니다. 기존 decoupled 방식은 video와 audio를 각각 줄여 둘의 관계를 놓치고, symmetric 방식은 두 modality에 같은 중요도 규칙을 적용합니다.
OmniSIFT의 첫 단계인 STVP는 한 frame 안의 정적인 background처럼 정보량이 낮은 spatial token과, 인접 frame 사이에서 거의 변하지 않는 temporal token을 줄입니다. 남은 token은 scene의 주요 변화와 사건을 대표하는 visual anchor가 됩니다.
압축이 곧 정보 정제라는 보장은 없습니다. 작은 물체나 느린 변화는 중복처럼 보여도 질문의 답일 수 있으므로 spatial, temporal pruning ratio를 task별로 확인해야 합니다.
Visual Anchor가 Audio 선택을 안내한다
두 번째 단계 VGAS는 video anchor를 query, audio token을 key와 value로 두는 cross-modal attention으로 관련 소리를 선택합니다. Goal 장면과 crowd cheer처럼 화면 사건과 소리가 맞물리는 경우에 유용합니다. Audio amplitude만 보고 자르는 것보다 의미 있는 시점을 찾을 수 있습니다.
Token을 유지하거나 버리는 hard decision은 미분하기 어려워 Straight-Through Estimator(STE)를 사용합니다. Forward에서는 threshold로 token을 고르고 backward에서는 gradient가 흐르게 근사해 압축 module을 end-to-end로 학습합니다. 추가 parameter는 4.85M으로 보고되며 7B backbone에 비해 작습니다.
STE에는 forward decision과 backward gradient가 다른 mismatch가 있습니다. 학습이 불안정하거나 threshold 주변 token이 자주 뒤집힐 수 있으므로 seed별 선택 일관성도 확인할 필요가 있습니다.
75% 제거 결과는 Audio 중심 상황과 함께 본다
Qwen2.5-Omni-7B를 backbone으로 WorldSense, Video-MME, EgoSchema 등 다섯 benchmark에서 평가합니다. 원문은 token 75%를 제거한 retention 25% 조건에서도 full-token model과 대등하거나 일부 점수가 높았다고 보고합니다. Noise token을 덜어 attention을 중요한 사건에 집중시킨다는 해석입니다.
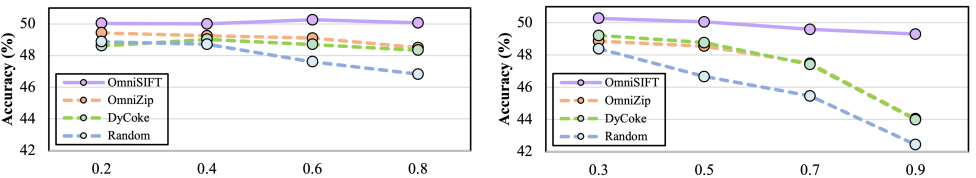
하지만 화면 밖 화자의 말, 어두운 장면의 소리, siren처럼 audio가 먼저 알려 주는 사건에서는 visual dominance가 약점이 됩니다. 원문 ablation에서도 audio를 지나치게 압축하면 성능이 내려갑니다. 짧은 clip benchmark의 결과가 수십 분짜리 long-form content에서도 유지되는지도 별도 문제입니다.
평균 점수보다 놓친 사건의 종류를 기록한다
검증 data를 visual-led, audio-led, synchronized, conflicting 네 종류로 나누는 것이 좋습니다. 각 유형에서 보존 token 수, answer accuracy, latency, 누락된 사건을 기록합니다. Full-token, video-only pruning, independent audio pruning, OmniSIFT를 같은 budget으로 비교해야 비대칭 설계의 효과를 볼 수 있습니다.
Edge device에서는 module parameter보다 실제 peak memory와 end-to-end battery, latency가 중요합니다. 압축 계산 자체가 만든 overhead도 포함합니다. OmniSIFT의 핵심은 “video가 audio보다 항상 중요하다”가 아니라 video 사건이 충분한 anchor가 되는 입력에서 modality 관계를 이용해 audio 선택을 더 정교하게 한다는 조건부 전략입니다.
Audio가 먼저인 장면을 어떻게 따로 시험할까
Visual-led sample만 많으면 VGAS가 유리해 보일 수 있습니다. 같은 clip에서 video, audio 중 어느 modality만으로 답을 알 수 있는지 label하고 네 유형을 균형 있게 구성합니다.
| 유형 | 예시 조건 | 압축 실패 신호 |
|---|---|---|
| Visual-led | 화면 동작이 핵심이고 소리는 보조 | 작은 object, 느린 변화 pruning |
| Audio-led | 화면 밖 말, alarm이 핵심 | visual anchor가 없어 음성 삭제 |
| Synchronized | 충돌 순간과 소리가 일치 | 시간 alignment가 어긋남 |
| Conflicting | 화면과 narration이 다른 정보 | 한 modality만 과신 |
화면 밖에서 “왼쪽 출구로 가라”는 말이 들리지만 입 모양이나 speaker가 보이지 않는 장면을 생각할 수 있습니다. VGAS가 visual relevance만 기준으로 audio를 줄이면 instruction을 잃을 수 있습니다. 이 경우 audio saliency로 최소 token을 보존하거나 visual evidence가 약한 구간에서는 압축률을 낮추는 fallback이 필요합니다.
STVP와 VGAS의 기여를 어떻게 분리할까
Full token, STVP만, independent audio pruning, STVP+VGAS를 같은 최종 token budget으로 비교합니다. STVP+VGAS가 더 많은 token을 쓴다면 cross-modal design과 budget 효과가 섞입니다. Visual, audio별 retained token 수와 task accuracy를 함께 보고, anchor가 잘못 선택된 sample을 추적합니다.
STE threshold 주변 token은 작은 입력 변화에도 keep, drop이 뒤집힐 수 있습니다. 같은 clip에 brightness, audio gain, frame timing을 조금 바꾼 뒤 선택 mask의 overlap과 답 안정성을 봅니다. Seed별 mask가 크게 다르지만 평균 점수만 같다면 production latency와 failure를 예측하기 어렵습니다.
Compression ratio도 전체 token 하나로만 표시하지 않습니다.
1
2
3
video retention = 남은 visual token / 원래 visual token
audio retention = 남은 audio token / 원래 audio token
전체 retention  = 두 modality token을 합친 비율
전체 25%가 같아도 audio를 거의 모두 버린 설정과 두 modality를 균형 있게 남긴 설정은 위험이 다릅니다. Task type별 retention distribution을 공개해야 75% 제거의 의미를 알 수 있습니다.
Edge 배포 이득은 어떤 조건에서 생길까
압축 module은 원본 token을 한 번 보고 중요도를 계산한 뒤 줄입니다. 따라서 vision, audio encoding 초기 비용까지 모두 사라지는 것은 아닙니다. 압축 전후 LLM attention 비용, STVP, VGAS overhead, data transfer와 peak memory를 분리해 측정합니다.
짧은 clip에서는 압축 overhead가 절감보다 클 수 있고 긴 clip에서는 attention 감소가 커질 수 있습니다. Duration별 break-even point를 찾고, device thermal throttling 뒤의 p95 latency와 battery도 봅니다. Accuracy가 유지되면서 실제 memory, latency가 목표를 만족하고 audio-led recall이 허용 범위일 때 비대칭 압축을 선택할 근거가 생깁니다.
함께 읽으면 이해가 이어지는 글
- AI가 화면의 버튼을 직접 짚어주면 안전할까? Clicky의 좌표, 프라이버시 — macOS 화면과 음성 질문을 Vision 모델에 보내 가상 커서로 위치를 알려 주는 Clicky의 구조, 다중 모니터 좌표 오차와 화면 유출 위험을 점검합니다.
- LTX-2는 영상과 소리를 어떻게 맞추나: 14B, 5B 듀얼 스트림 — 비디오 14B와 오디오 5B 스트림을 교차 연결해 함께 노이즈를 제거하는 구조, 동기화 평가와 실행 비용
- GPT-5.6 Sol Ultrafast 프리뷰: 초당 750토큰과 실제 지연 시간 판단법 — OpenAI와 Cerebras가 Cerebras 웨이퍼 스케일 엔진 기반으로 표준 대비 최대 14배 빠른 GPT-5.6 Sol Ultrafast mode API를 공개했습니다. 초당 최대 750토큰을 생성하여 실시간 음성 에이전트…
자주 묻는 질문
Token 75%를 제거해도 항상 성능이 유지되나요?
아닙니다. 보고값은 특정 backbone, benchmark의 retention 25% 조건이며 long-form video와 audio-led 사건에서는 압축률별 정확도, 누락을 다시 측정해야 합니다.
Visual anchor가 있으면 중요한 audio를 모두 찾나요?
화면 밖 화자, siren, 어두운 장면처럼 소리가 먼저 의미를 주는 사건은 visual query가 약해 놓칠 수 있으므로 audio-only saliency나 fallback이 필요합니다.
추가 parameter가 4.85M이면 edge 비용도 작나요?
Parameter 수만으로는 알 수 없습니다. STVP, cross-modal attention, token selection overhead를 포함한 peak memory, batch 1 latency와 battery를 실제 device에서 측정해야 합니다.
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.