정면 driving video의 동작을 측면 camera로 옮기려면 2D keypoint를 그대로 복사하지 말고 시점에 덜 종속된 motion token으로 변환해야 합니다. 3DiMo는 SMPL을 끝까지 강제하지 않고 초반 3D 보조 신호로만 쓰면서 pretrained video generator의 spatial prior를 활용합니다.
정면 춤 영상을 측면으로 바꾸면 Pose가 무너지는 이유: 3DiMo의 Motion Token
2D Pose와 SMPL은 서로 다른 곳에서 틀린다
2D pose는 image plane의 관절 위치를 잘 전달하지만 depth와 camera viewpoint를 담지 못합니다. 정면에서 겹쳐 보인 팔이 측면에서는 몸 앞인지 뒤인지 알아야 하는데, 같은 keypoint만으로는 결정하기 어렵습니다. Driving view와 target view가 달라질수록 motion이 찌그러질 수 있습니다.
SMPL 같은 explicit 3D model은 회전 가능한 body geometry를 주지만 실제 video에서 parameter를 추정하는 HMR 단계가 틀릴 수 있습니다. Hand twist, foot sliding, depth distortion이 guide에 들어가면 generator가 잘못된 3D constraint를 충실히 따라 결과 품질을 해칠 수 있습니다.
3DiMo의 가설은 대규모 video diffusion model에 body와 공간 관계에 대한 prior가 이미 있으므로, 불완전한 mesh를 끝까지 강제하기보다 motion의 핵심만 implicit representation으로 제공하자는 것입니다.
Body와 Hand를 분리해 Motion Token을 만든다
3DiMo는 body와 hand에 별도 motion encoder를 둡니다. Hand는 body보다 작은 영역에서 복잡한 자유도를 가지므로 같은 encoder와 해상도로 압축하면 세부 동작이 사라질 수 있습니다. 두 encoder가 driving frame을 view-agnostic motion token으로 바꾸고, DiT block의 cross-attention을 통해 generation에 넣습니다.
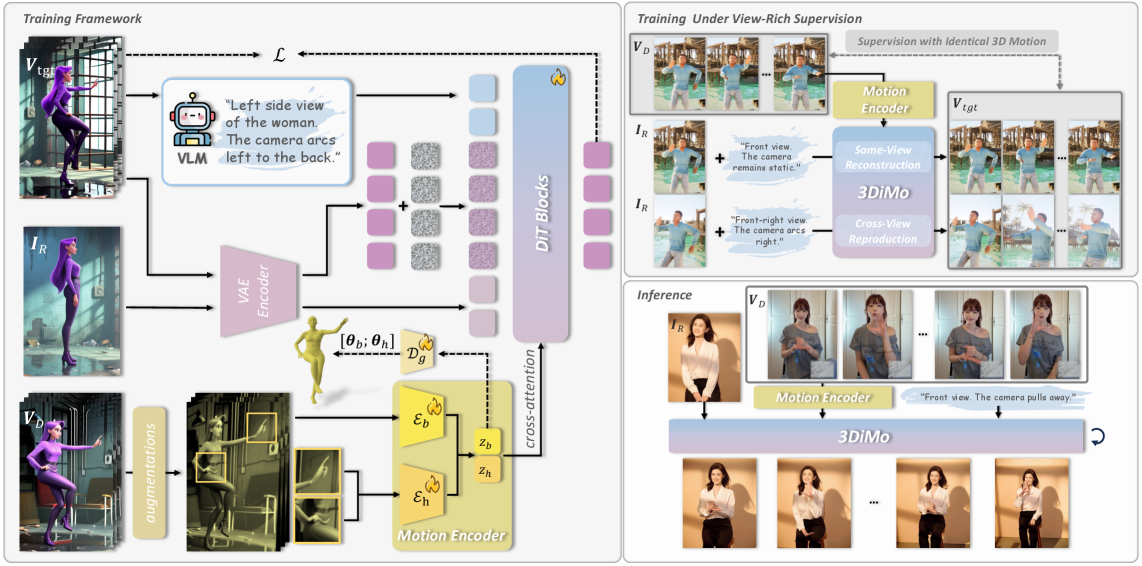
ControlNet식 pixel-level hard constraint보다 semantic guidance에 가깝기 때문에 generator가 texture와 identity prior를 사용할 여지가 큽니다. 대신 “view-agnostic”은 모든 camera 각도에서 동일 성능이라는 뜻이 아닙니다. 학습에서 보지 못한 top view나 심한 occlusion에서는 representation이 흔들릴 수 있습니다.
Perspective Augmentation과 SMPL Annealing의 역할
Training 중 driving frame에 perspective distortion을 인위적으로 가해 encoder가 특정 camera에 매달리지 않도록 합니다. Data는 internet single-view video, Unreal Engine rendering, 자체 multi-view capture를 결합합니다. 다양한 motion과 정확한 cross-view 대응을 함께 확보하려는 구성입니다.
SMPL은 완전히 버리지 않습니다. 초반에는 body geometry를 배우도록 supervision을 주고, 학습이 진행되면 weight를 0으로 annealing합니다. 초기 convergence에는 explicit geometry를 쓰되 후반에는 SMPL estimation error보다 real video와 generator prior를 더 따르게 합니다. Annealing schedule이 너무 빠르거나 느리면 각각 geometry 학습 부족과 error 고착이 생길 수 있습니다.
결과를 볼 때 Motion과 View를 따로 평가한다
원문은 motion fidelity가 기존 대비 15% 넘게 개선되고 multi-view consistency에서 강한 결과를 보고합니다. Qualitative comparison에서는 depth ambiguity와 inaccurate pose가 줄어든 사례를 제시합니다. 이는 논문의 view-rich data와 baseline 조건에 한정됩니다.
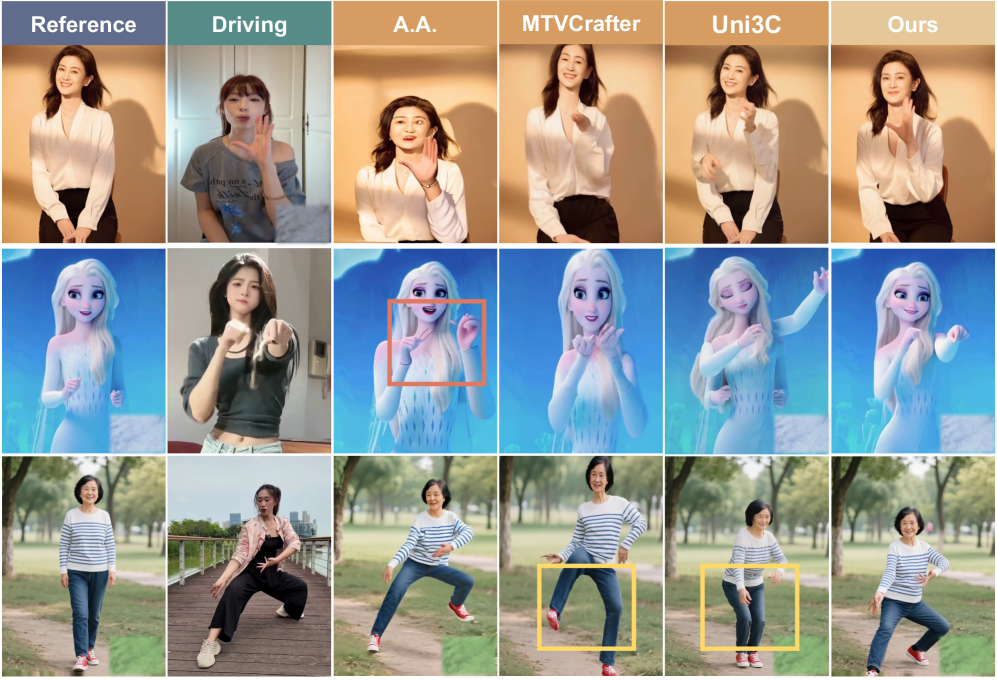
도입 검증에서는 같은 view reenactment와 새로운 view adaptation을 분리합니다. Body pose, hand detail, foot sliding, identity 유지, frame flicker를 각각 보고, 극단 camera와 복잡한 clothing을 failure set에 넣습니다. Cross-attention 추가에 따른 inference cost도 측정해야 합니다. 3DiMo의 핵심은 explicit 3D가 불필요하다는 선언이 아니라 초기 geometry guide를 점차 걷어 내며 implicit motion representation으로 중심을 옮긴 절충입니다.
SMPL Annealing이 실제로 오류를 줄였는지 어떻게 볼까
No-SMPL, 끝까지 고정 weight를 쓰는 SMPL, annealed supervision을 같은 data, generator에서 비교합니다. No-SMPL이 depth 관계를 자주 틀리면 초기 geometry signal의 이득이고, fixed-SMPL만 hand twist와 foot sliding이 많다면 reconstruction error가 후반까지 고착된 증거입니다.
Annealing schedule은 시작 weight와 0에 도달하는 시점을 함께 바꿔 봐야 합니다. 너무 빠르게 줄이면 motion encoder가 view geometry를 배우기 전에 signal이 사라지고, 너무 늦게 줄이면 inaccurate mesh를 그대로 따릅니다. Training loss 하나보다 target-view pose, visual quality와 SMPL estimator confidence 구간별 결과를 나눠 봅니다.
| 조건 | 기대 효과 | 대표 failure |
|---|---|---|
| SMPL 없음 | generator prior를 자유롭게 활용 | depth, limb ordering 불안정 |
| SMPL 고정 | 명시적 geometry 유지 | 잘못 추정한 twist, body shape 고착 |
| SMPL annealing | 초기 구조와 후반 유연성 절충 | schedule이 맞지 않으면 양쪽 단점 |
Camera 변화는 어떤 시험 세트로 나눌까
Driving과 target camera의 각도 차이를 small, medium, extreme으로 나누고 yaw뿐 아니라 elevation과 focal length 변화도 봅니다. 동일 view에서 잘 되는 model이 90도 side view나 top view에서도 같은 motion token을 유지한다고 가정하면 안 됩니다.
예를 들어 정면에서 두 손이 겹치는 동작, 한 팔이 torso 뒤로 가는 동작, 회전 중 발이 교차하는 동작을 넣습니다. Target view별로 2D keypoint error만 보면 depth ordering이 맞는지 알기 어려우므로 limb 앞뒤 관계, occlusion boundary와 foot contact를 사람이 확인할 수 있는 항목으로 둡니다.
Perspective augmentation의 기여는 augmentation을 끈 조건과 비교합니다. 너무 강한 distortion이 real camera 분포를 벗어나면 identity와 body proportion을 해칠 수 있으므로 augmentation 강도별 same-view quality와 cross-view gain을 함께 그립니다. Cross-view만 좋아지고 원래 view의 fidelity가 크게 떨어지면 product용 절충점을 다시 골라야 합니다.
Body와 Hand 분리가 필요한 장면은 무엇인가
걷기처럼 큰 limb motion은 body token이 주도하지만 finger gesture, object grasp는 작은 hand crop의 detail이 중요합니다. Hand encoder를 제거하거나 body와 weight를 공유한 ablation에서 finger motion과 global pose를 나눠 측정하면 두 encoder 비용이 정당한지 알 수 있습니다.
손이 얼굴이나 object에 가려질 때는 input evidence 자체가 부족합니다. Generator가 그럴듯한 손가락을 만들더라도 driving motion을 복원했다고 단정할 수 없으므로 occluded frame을 따로 표시하고 confidence가 낮은 구간의 fidelity를 보고합니다. 긴 소매, 헐렁한 옷은 SMPL body surface와 visible contour가 달라지는 failure set입니다.
배포에서는 target view 범위, 허용 camera movement와 clothing domain을 명시합니다. 그 범위를 벗어나면 같은-view 생성이나 원본 motion을 유지하는 fallback을 제공하는 편이 안전합니다. 모든 camera에서 자유롭게 재연한다는 표현보다 검증한 view envelope를 공개하는 것이 실제 사용에 더 유용합니다.
함께 읽으면 이해가 이어지는 글
- 손은 움직였는데 AI 영상 속 물체가 안 따라오면? Generated Reality의 2D, 3D 제어 — Generated Reality가 손의 2D 골격과 3D 관절, 머리 움직임을 함께 조건으로 써 상호작용 영상을 제어하는 방법과 실시간 적용의 한계를 살펴봅니다.
- MotionFollower는 GPU 메모리를 얼마나 줄였나: 42.6GB→9.8GB와 품질 지표 해석 — MotionFollower의 pose, reference controller, reconstruction, editing branch와 score guidance를 설명하고, MotionEditor 대비 메모리 감소율과 PSNR…
- DreamVideo-Omni는 두 캐릭터 얼굴 융합을 막을까: Latent Identity RL의 범위 — 여러 Subject, BBox 궤적, Camera Motion을 분리하고 VAE Decode 없이 Latent Identity Reward를 주는 DreamVideo-Omni의 장점과 데이터, 평가 한계를 정리합니다.
자주 묻는 질문
2D pose를 target view에 그대로 옮기면 왜 틀리나요?
2D keypoint에는 depth와 camera 정보가 없어 정면에서 겹친 팔, 다리의 앞뒤 관계를 새 시점에서 결정하기 어렵기 때문입니다.
3DiMo는 SMPL을 사용하지 않나요?
사용합니다. Training 초반에는 3D geometry supervision으로 쓰고 weight를 점차 0으로 줄여 후반에는 reconstruction 오류를 강제하지 않는 절충입니다.
View adaptation 품질은 어떤 지표로 봐야 하나요?
Body pose, hand detail, foot sliding, camera별 motion fidelity, identity, clothing 유지, temporal flicker와 cross-attention latency를 함께 측정해야 합니다.
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.