Green-VLA의 핵심은 하나의 VLA를 한 번에 학습하지 않고, vision-language grounding에서 multi-embodiment pretraining, 특정 robot adaptation과 RL policy alignment까지 다섯 단계로 나눈 것입니다. 이 curriculum은 오류 지점을 분리하는 장점이 있지만, 15~20% 향상 주장만으로 모든 robot의 범용성, 실시간성, 안전이 입증되지는 않습니다.
Green-VLA의 5단계 Curriculum은 무엇을 더하나? R2 RL과 OOD 검증
Green-VLA가 제안한 핵심은 무엇인가
Green-VLA는 휴머노이드와 서로 다른 robot 형태를 함께 다루기 위한 staged framework입니다. 이 글에 제시된 핵심 구성은 세 가지입니다.
- 5단계 커리큘럼 학습 (L0~R2): 기초 VLM(Vision-Language Model)에서 시작하여 시각적 접지(Multimodal Grounding), 다중 로봇 사전 학습, 특정 로봇 적응, 그리고 최종적인 RL 정책 정렬에 이르는 체계적인 파이프라인을 구축했습니다.
- 데이터 스케일링 및 품질 관리: 3,000시간 이상의 로봇 조작 데이터를 포함한 대규모 데이터셋을 활용하며, 시간적 정렬(Temporal Alignment)과 품질 필터링을 통해 학습 효율을 극대화했습니다.
- 보조 실행 신호: 추론 단계에서 episode 진행도 예측, OOD 감지, Joint-Prediction 기반 guidance를 사용합니다. 각 신호가 실제 안전을 얼마나 높이는지는 별도 지표가 필요합니다.
왜 학습 단계를 나눴을까
기존 VLA는 서로 다른 hardware 사이의 transfer, 미세 조작과 불확실성 대응을 동시에 학습해야 합니다. Green-VLA가 문제로 둔 항목은 다음과 같습니다.
- 데이터 효율성 문제: 수만 개의 에피소드가 필요함에도 불구하고, 서로 다른 구조를 가진 로봇들(예: 7자유도 로봇 팔 vs. 20자유도 이상의 휴머노이드) 사이의 지식 전이가 매끄럽지 않았습니다.
- 정교함의 부족: 언어 지시는 이해하지만, 좁은 공간에서의 미세한 조작이나 동적인 장애물 회피에서 성능이 급격히 저하되는 현상이 발생했습니다.
- 안전성 결여: 모델이 자신의 한계를 인지하지 못하고(Uncertainty estimation 부재) 잘못된 동작을 수행할 때 발생하는 하드웨어 파손 위험이 컸습니다.
이를 한 loss에 섞기보다 시각 grounding, 공통 robot 행동, 특정 hardware 적응, RL alignment로 순서를 나눕니다. 다만 단계가 많아질수록 data version과 checkpoint 사이의 회귀를 추적해야 하는 운영 부담도 커집니다.
5단계 Curriculum은 무엇을 학습하나
L0에서 R2까지의 역할
학습 과정은 다음 다섯 단계로 설명됩니다.
- L0 (Foundational VLMs): 이미 검증된 거대 시각-언어 모델을 기초 모델로 채택합니다. 이는 기본적으로 이미지와 텍스트 사이의 상관관계를 이해하는 수준입니다.
- L1 (Multimodal Grounding): 로봇이 시각적 세계와 자신의 행동 공간을 연결하는 단계입니다. 시각적 질문 답변(VQA), 공간 추론, 특정 좌표 지칭(Pointing) 등을 학습합니다.
- R0 (Multi-embodiment Pretraining): 다양한 robot data를 통합해 hardware 사이에 공유되는 visual-action pattern을 학습합니다. 새로운 embodiment에 그대로 전이되는지는 별도 시험이 필요합니다.
- R1 (Embodiment-specific Adaptation): 특정 로봇(예: Green 휴머노이드)의 고유한 하드웨어 특성에 맞춰 모델을 미세 조정(Fine-tuning)합니다.
- R2 (RL Policy Alignment): imitation policy에 reward를 적용해 task objective에 맞춥니다. 속도, 정확도, 안전이 모두 좋아지는지는 reward 항목과 evaluation을 나눠 봐야 합니다.
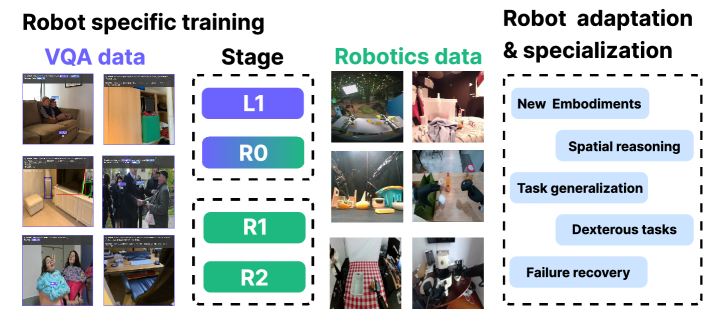 그림 2: Green-VLA의 로봇별 학습 단계는 VQA 및 로봇 데이터를 사용하여 새로운 하드웨어에 대한 적응, 공간 추론, 태스크 일반화 및 고난도 조작 능력을 배양합니다.
Task Planner와 Flow-Matching은 어떻게 연결되나
Green-VLA의 내부 구조는 크게 High-level Task Planner와 Low-level Action Expert로 나뉩니다.
- Task Planner: 복잡한 사용자의 명령(예: “부엌을 청소해줘”)을 하위 작업(Sub-tasks)으로 분해합니다.
- Flow-Matching Action Expert: 연속 action trajectory를 생성합니다. Flow matching이라는 선택만으로 정밀도와 real-time latency가 보장되지는 않으며 sampling, action chunk 조건을 확인해야 합니다.
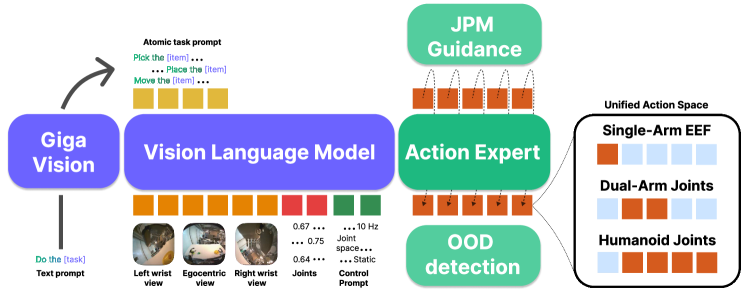 그림 1: Green-VLA 아키텍처 개요. 멀티모달 VLM이 지시사항과 카메라 뷰를 인코딩하고, 고수준 플래너와 Flow-matching 전문가가 협력하여 정밀한 제어를 수행합니다.
Joint-Prediction Based Guidance는 무엇을 확인하나
JPM(Joint Prediction Model)은 현재 action과 future state의 일관성을 guidance에 사용합니다. Target point가 불확실한 조작에서 보조 신호가 될 수 있지만, 소형 부품이나 특정 현장에서의 성능은 task별 수치와 failure case로 확인해야 합니다.
Data와 구현 조건은 무엇인가
L1 data mixture에는 무엇이 들어가나
Green-VLA는 web 기반 일반 data와 robot data를 혼합합니다.
- L1 단계의 데이터 혼합: 시각적 추론을 위해 대량의 VQA 데이터셋과 로봇 관련 질문 답변 데이터를 섞었습니다. 단순히 이미지를 보는 것이 아니라, “이 물체를 잡으려면 어디를 향해야 하는가?”와 같은 의사결정 중심의 질문을 포함했습니다.
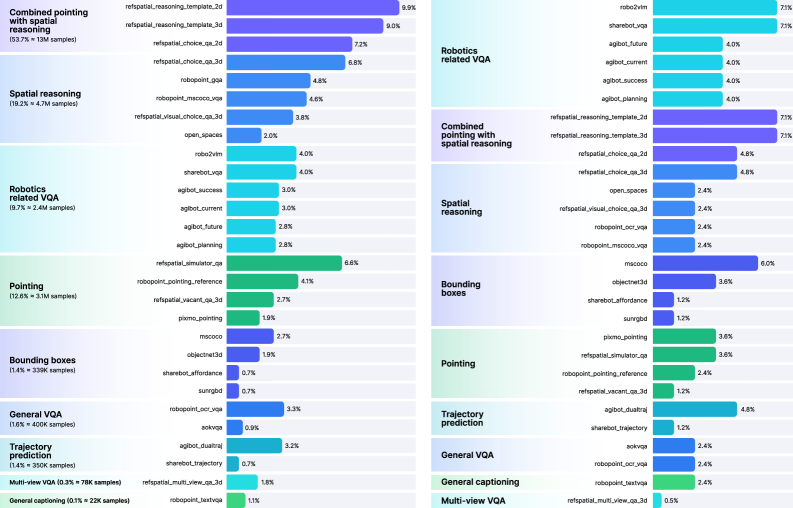 그림 3: L1 학습 단계에서 사용된 데이터셋 구성. 공간 추론, 포인팅, 로봇 관련 VQA 등 다양한 소스가 통합되어 있습니다.
3,000시간과 200만 episode를 어떻게 읽을까
3,000시간 분량의 데이터는 약 200만 개의 에피소드에 해당합니다. 이를 처리하기 위해 연구팀은 분산 학습 프레임워크를 사용했으며, 특히 로봇의 고유 센서 정보(Proprioception)와 다중 시점 카메라(Multi-view) 입력을 효율적으로 토큰화(Tokenization)하는 데 집중했습니다.
15~20% 향상은 무엇을 증명하나
Green-VLA는 Simpler BRIDGE(WidowX)와 CALVIN과 같은 표준 벤치마크는 물론, 실제 휴머노이드 로봇 환경에서도 테스트되었습니다.
- Success result: 원문은 OpenVLA 대비 약 15~20% 향상을 설명하고 long-horizon task에서 R2가 유리한 결과를 제시합니다. 이 글에는 task별 절대 성공률과 percent, percentage point 구분이 모두 없으므로 범위를 확대하지 않습니다.
- OOD signal: 새로운 object나 environment에서 불확실성을 감지하고 중단, 도움을 요청하는 기능을 설명합니다. 실제 배포에는 OOD 종류별 recall, 정상 장면을 잘못 막는 false positive와 중단 뒤 recovery가 필요합니다.
단계별 기여를 어떻게 검증할까
다섯 checkpoint의 최종 점수만 나열하면 data 양과 curriculum 순서가 섞입니다. L0→L1에서 spatial grounding, R0에서 cross-embodiment transfer, R1에서 특정 robot 적응, R2에서 task success와 recovery가 얼마나 변했는지 같은 test set으로 추적해야 합니다.
| 단계 | 우선 지표 | 함께 볼 회귀 |
|---|---|---|
| L1 | pointing, spatial VQA | 일반 VQA, language instruction |
| R0 | seen, unseen robot transfer | 특정 robot의 action precision |
| R1 | target hardware success | 다른 embodiment 성능 |
| R2 | closed-loop success, recovery | collision, latency, reward shortcut |
R2가 성공률을 올려도 action이 과도하게 느려지거나 safety filter가 더 자주 개입하면 안정성이 개선됐다고 말하기 어렵습니다. R1 data가 많은 robot에서만 성능이 오르면 R0의 일반화보다 adaptation 효과일 수 있습니다. Stage를 하나씩 생략한 ablation과 data budget을 맞춘 end-to-end baseline이 필요한 이유입니다.
실제 배포에서 무엇이 실패할 수 있나
- RL 비용과 gap: R2는 simulation reward를 잘 따르면서 실제 friction, sensor noise에서 실패할 수 있습니다. Hardware wear와 unsafe exploration도 training budget에 포함해야 합니다.
- Inference latency: VLM, planner와 flow action expert의 sensor-to-action 지연이 target control cycle 안에 들어오는지 이 글의 수치만으로 확인할 수 없습니다.
- Data bias: Web grounding이 robot joint, workspace 제약을 포함하지 않으면 불가능한 target을 계획할 수 있습니다. Low-level controller가 joint limit와 collision을 별도로 막아야 합니다.
- OOD calibration: 낯선 위험을 정상으로 보는 false negative는 사고로 이어지고, 정상 input을 계속 OOD로 보는 false positive는 task completion을 막습니다.
어떤 조건에서 도입할 수 있나
여러 robot을 운영하고 신규 embodiment마다 처음부터 학습하는 비용이 큰 팀이라면 staged training의 checkpoint와 data 재사용 가능성을 검토할 가치가 있습니다. 단일 반복 공정에서는 다섯 단계와 대형 VLM 운영비가 더 작은 specialized policy보다 클 수 있습니다.
PoC는 같은 data로 end-to-end fine-tuning과 staged training을 비교하고, unseen object, camera, robot을 분리합니다. 최종 표에는 task success, new robot에 필요한 episode, sensor-to-action p95, peak memory, collision, safety stop, OOD recall과 false positive를 함께 둡니다. 15~20% 결과가 이 지표의 허용 범위 안에서 재현될 때 curriculum의 운영 가치를 판단할 수 있습니다.
Green-VLA가 제시한 것은 범용 robot의 완성이 아니라 vision-language 지식과 hardware-specific action, RL objective를 어느 순서로 연결할지에 대한 학습 설계입니다. 각 단계가 이전 능력을 잃지 않으면서 실제 robot의 data, 통합 비용을 줄이는지는 stage별 회귀와 closed-loop 평가로 확인해야 합니다.
함께 읽으면 이해가 이어지는 글
- 로봇 진행률을 말로 묻지 않고 잴 수 있을까? TOPReward의 토큰 확률 — TOPReward가 비디오 VLM의 생성 문장 대신 내부 토큰 확률로 작업 진행률을 추정하는 이유와 VOC 지표가 놓치는 실패를 살펴봅니다.
- VLANeXt의 12가지 VLA 설계 레시피는 어떻게 검증해야 할까 — VLANeXt가 VLA 설계 요소를 같은 틀에서 비교해 2.5B 모델을 구성하는 과정과 LIBERO 결과, 실제 로봇 이전에 확인할 조건을 정리합니다.
- VLM은 텍스트 모델부터 학습해야 할까? Transfusion 공동 사전학습의 대안 — 텍스트 next-token loss와 이미지 diffusion loss를 처음부터 한 Transformer에서 학습하는 Transfusion 구조, RAE와 MoE의 역할 및 데이터 비용을 설명합니다.
자주 묻는 질문
5단계를 모두 거쳐야 Green-VLA의 효과를 얻나요?
단계별 기여는 L1, R0, R1, R2를 하나씩 뺀 ablation으로 확인해야 하며 data, hardware가 다른 환경에서 다섯 단계가 항상 최적이라고 단정할 수 없습니다.
R2 RL alignment가 robot 안전을 보장하나요?
아닙니다. Reward 설계와 simulation gap에 따라 unsafe shortcut이 생길 수 있어 collision, joint limit, safety stop과 실제 hardware rollout을 독립적으로 검증해야 합니다.
OOD 감지가 동작하면 새 환경에 배포해도 되나요?
OOD score의 calibration, false negative, false positive와 중단 뒤 recovery가 확인돼야 하며 낮은 confidence일 때 실행을 차단하는 별도 safety controller가 필요합니다.
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.