온라인 제어에 넣기 전에 무엇을 확인해야 하나요?
첫째, VLM의 추론 속도가 제어 주기를 따라가야 합니다. 대형 비디오 모델을 10~100Hz 루프에 그대로 넣기는 어려울 수 있어, 보상 계산 주기와 정책 제어 주기를 분리할지 결정해야 합니다.
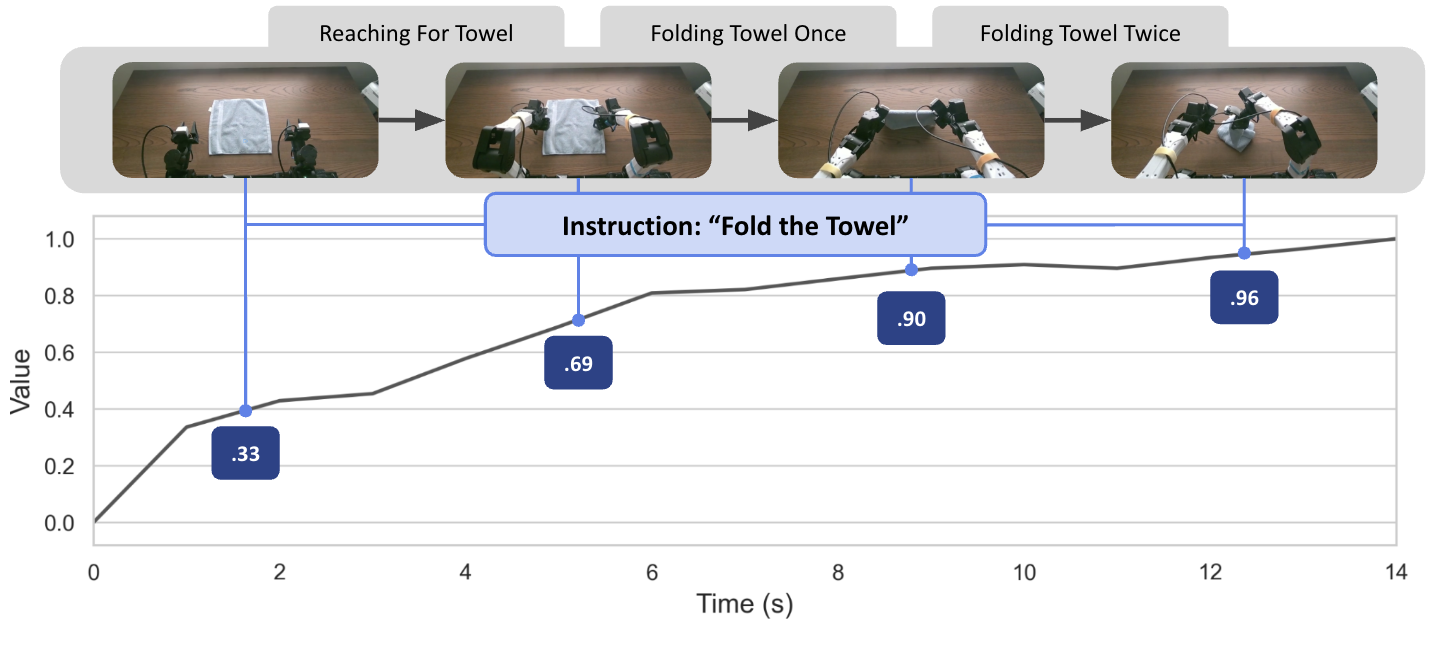
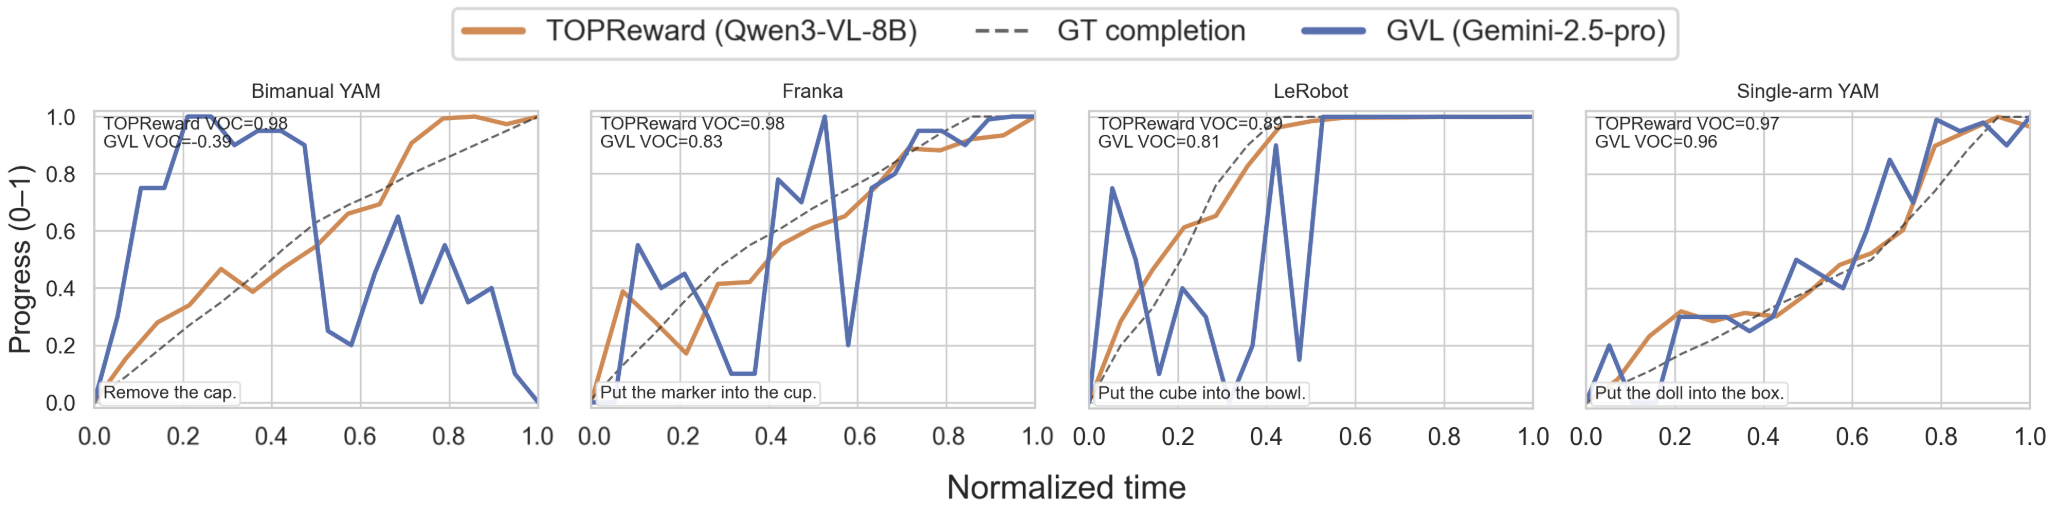
둘째, 확률 곡선의 잡음과 역행을 확인해야 합니다. 후처리로 곡선을 매끄럽게 만들면 안정성은 높아질 수 있지만 실제 실패 신호까지 지울 수 있으므로 원본 값과 함께 평가해야 합니다.
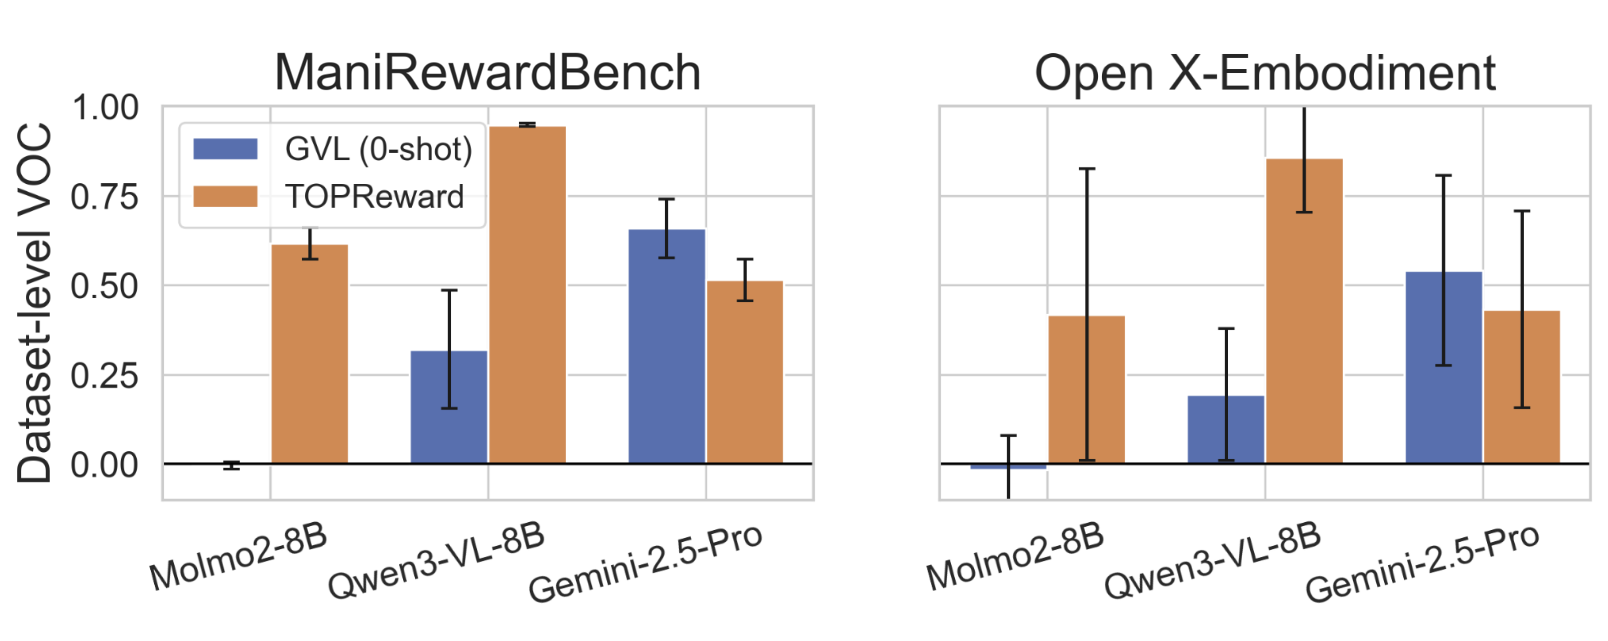
셋째, 작업 지시 문구가 바뀌거나 학습에서 적은 장면에서도 완료 토큰이 같은 의미를 갖는지 봐야 합니다. 제로샷이라는 말은 작업별 파인튜닝이 없다는 뜻이지, 모든 환경에서 보정 없이 정확하다는 뜻이 아닙니다.
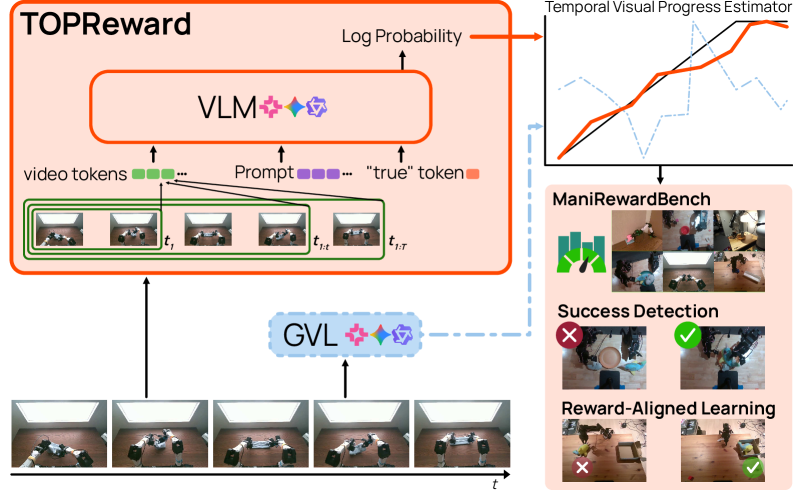
TOPReward의 실용적 기여는 VLM의 최종 문장만 사용하던 관점을 바꾼 데 있습니다. 내부 확률은 더 촘촘한 보상 후보가 될 수 있지만, 물리 센서와 절대 완료 판정을 대체하는 단일 진실값은 아닙니다.
VLM 보상을 느린 주기로 계산한다면 그 사이의 여러 제어 행동에 값을 어떻게 배분할지도 정해야 합니다. 마지막 프레임의 상승을 직전 모든 행동의 공으로 돌리면 실제 원인과 무관한 동작이 강화될 수 있습니다. 보상 계산 시각, 관측 지연과 정책 행동의 타임스탬프를 맞추고 추론 지연으로 오래된 값이 들어왔을 때는 사용하지 않아야 합니다.
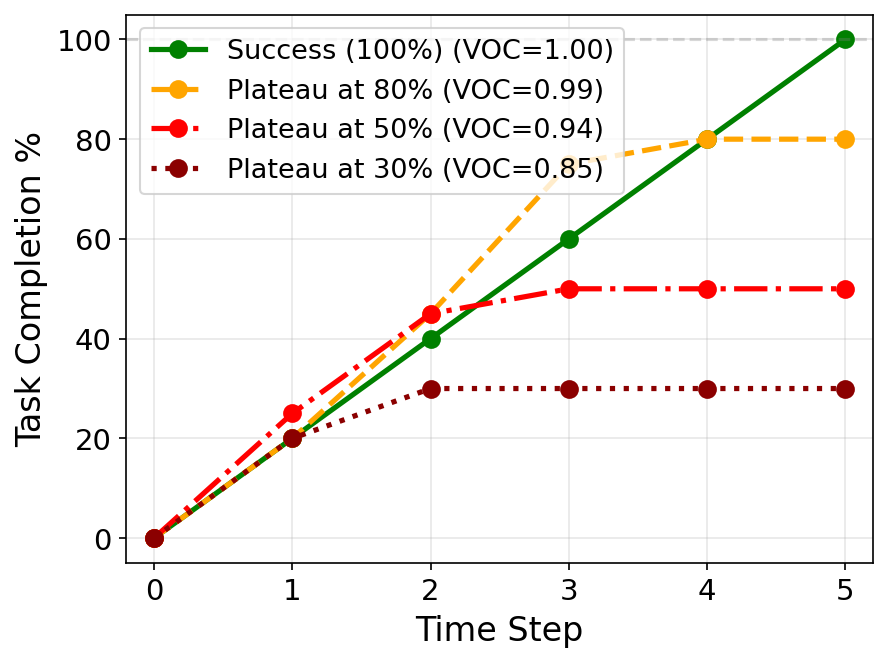
배포 기준에는 VOC뿐 아니라 완료, 실패 구분, 역행 감지, 보상 계산의 p95 지연, 보상 해킹 사례와 독립 센서 불일치를 포함합니다. 이 기준에서 어느 작업군이 안정적인지 확인한 뒤 범위를 넓혀야 제로샷 보상의 편의가 실제 제어 안전성과 함께 갈 수 있습니다.
토큰 확률에 접근할 수 없는 API나 모델이 바뀌는 환경에서는 같은 보상 정의를 유지하기 어렵습니다. 모델 버전, 프롬프트와 후보 토큰 집합을 함께 기록하고 업데이트 전후에 동일 에피소드의 확률 곡선을 다시 계산해야 합니다. 곡선의 절대값이 크게 이동하면 기존 임계값을 그대로 쓰지 말고 소량의 완료, 실패 영상으로 재보정합니다. 이 재현성이 확보되지 않으면 TOPReward는 정책의 핵심 보상보다 관측용 보조 지표로 제한하는 편이 안전합니다.