포스트

비디오 배경이 카메라와 함께 휘어진다면? VGGRPO의 잠재 4D 보상

카메라가 움직일 때 배경 구조가 무너지는 비디오 모델은 기하학 보상으로 개선할 수 있으며, VGGRPO는 그 보상을 RGB가 아닌 latent에서 계산해 학습 부담을 줄입니다. 다만 Latent Geometry Model이 잘못 본 깊이와 궤적도 그대로 보상이 될 수 있어 선행 모델의 품질이 핵심입니다.

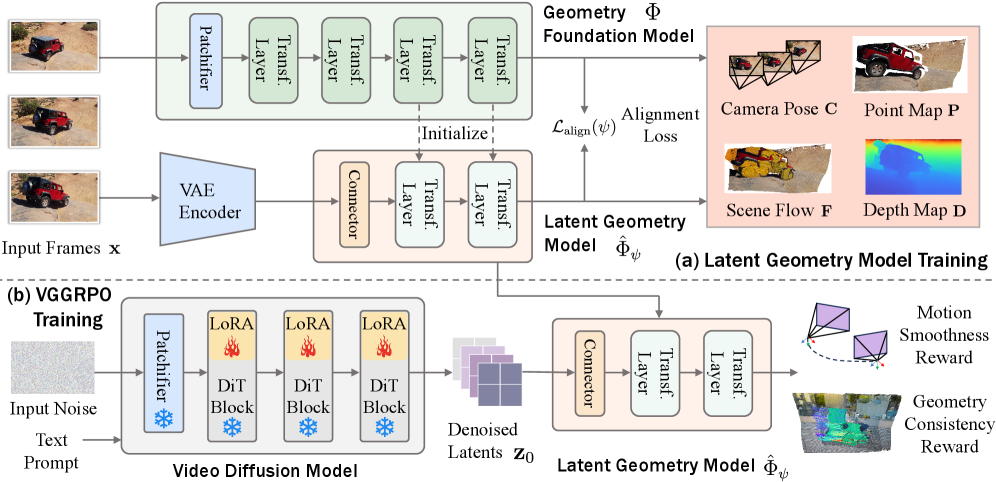
VGGRPO 논문은 생성된 비디오의 카메라 흔들림과 뷰 간 구조 불일치를 RL로 조정합니다. 보상을 계산할 때마다 VAE로 전체 영상을 복원하지 않고, diffusion latent를 가벼운 connector를 통해 geometry foundation model에 연결합니다.
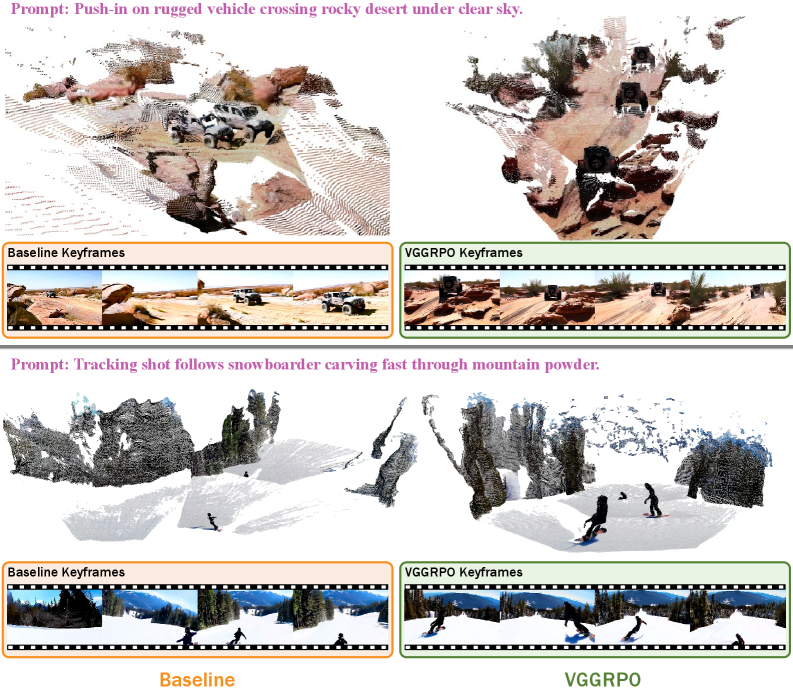
기존 모델과 VGGRPO의 공간 일관성 비교

LGM이 픽셀 복원 전에 4D 장면을 읽는다

LGM(Latent Geometry Model)은 생성 모델의 잠재 표현에서 깊이와 카메라 궤적 같은 기하 정보를 추정합니다. RGB 디코딩을 건너뛰면 비디오의 모든 프레임을 매 RL step마다 이미지로 만드는 메모리와 계산을 줄일 수 있습니다. 이 구조는 생성 분포의 latent에서 직접 학습돼 RGB 기반 모델의 분포 차이를 줄이려는 목적도 있습니다.

latent와 기하 파운데이션 모델을 잇는 전체 방법

LGM을 만드는 선행 비용은 남습니다. 고품질 4D 모델로 pseudo-label을 만들고 connector를 학습해야 하며, base video model이 바뀌면 latent 분포도 달라질 수 있습니다. “VAE decode 0회”와 “기하 모델 비용 0”은 다른 말입니다.

motion과 reprojection은 다른 실패를 잡는다

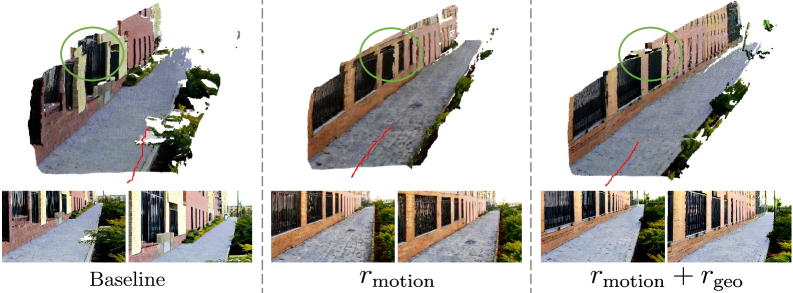
motion reward는 카메라 궤적의 갑작스러운 떨림을 줄입니다. reprojection reward는 다른 뷰에서 같은 3D 구조가 맞아야 한다는 조건을 평가합니다. 하나만 쓰면 부드럽지만 구조가 틀리거나, 구조는 맞아도 움직임이 불안정할 수 있어 두 축을 함께 둡니다.

모션, 재투영 보상 구성 요소 제거 실험

GRPO는 샘플 그룹 안의 상대 보상으로 정책을 업데이트해 별도 critic을 두지 않습니다. PPO보다 구성 요소를 줄일 수 있지만 여러 영상을 동시에 샘플링해야 하므로 그룹 크기와 해상도에 따라 VRAM은 여전히 커질 수 있습니다.

빠르다는 수치는 같은 학습 조건에서 비교한다

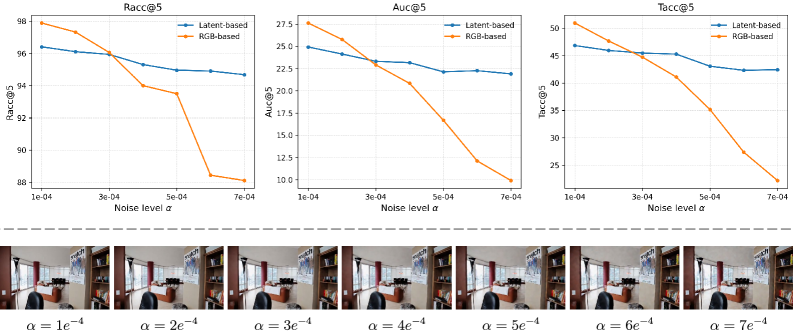
원문은 RGB 기반 보상보다 3~5배 빠른 학습과 낮은 메모리를 설명합니다. 이 배수는 사용한 VAE, LGM, 프레임 수와 하드웨어에 묶여 있습니다. A100 한 장에서 가능하다는 주장도 모델 크기와 배치 조건 없이 일반화할 수 없습니다.

latent geometry model의 노이즈 강건성 분석

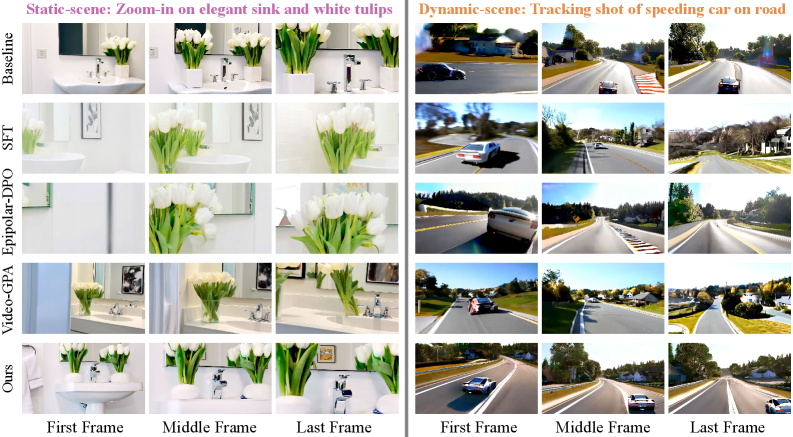
정적, 동적 장면 비교에서는 배경과 움직이는 객체의 구조가 더 안정된 사례를 보여 줍니다. 시각적 일관성이 곧 정확한 물리 깊이와 odometry를 뜻하지는 않습니다. 자율주행 합성 데이터에 쓰려면 실제 센서 기준으로 다시 평가해야 합니다.

정적, 동적 장면의 방법별 비교

보상 해킹은 기하 모델의 오류에서 시작될 수 있다

LGM이 특정 아티팩트를 높은 일관성으로 오인하면 생성 모델은 사람이 보기 좋은 영상보다 그 평가기의 허점을 학습할 수 있습니다. 다양한 카메라 속도, 가림, 반사, 투명 물체로 독립 검증 세트를 만들고 reward 상승과 사람 평가가 함께 움직이는지 봐야 합니다.

원문의 파이썬 함수는 legacy 방식과 latent 방식의 차이를 보여 주는 의사 코드입니다. 실제 reward 식, 학습 루프와 모델 API가 빠져 있어 실행법이 아닙니다. 논문 자료를 바탕으로 작은 장면에서 비용과 오류를 확인한 뒤, base model 전체를 바꾸지 않는 post-training 실험으로 범위를 제한하는 편이 안전합니다.

4D 일관성은 어떤 실패를 의미하나

비디오가 선명해도 카메라가 이동할 때 벽의 모서리가 휘거나 가려졌던 물체의 위치가 달라지면 같은 세계를 유지했다고 보기 어렵습니다. 반대로 기하 구조가 안정적이어도 사람의 움직임이 뻣뻣하고 prompt와 다른 장면이 나오면 좋은 생성은 아닙니다. VGGRPO가 겨냥하는 기하 축을 전체 영상 품질과 분리해 읽어야 합니다.

평가 항목은 카메라 궤적의 부드러움, 여러 view의 재투영 오차, 객체 정체성, 동적 객체의 운동과 텍스트 준수로 나눌 수 있습니다. 평균 한 점수로 합치기 전에 각 축의 실패율을 보면 보상이 특정 오류만 줄이고 다른 품질을 희생했는지 드러납니다. 사람이 보기에는 자연스럽지만 깊이 추정기가 어려워하는 장면도 별도로 모아야 합니다.

LGM 자체는 어떻게 검증해야 하나

LGM의 출력은 최종 생성 모델을 훈련시키는 신호이므로 먼저 고정된 real, generated video에서 검증해야 합니다. 카메라 pose와 depth 정답이 있는 합성 데이터, 실제 센서 궤적이 있는 데이터, 정답이 없지만 사람이 구조 붕괴를 판단할 수 있는 영상으로 나눕니다. RGB 기반 geometry model과 비교해 latent 입력에서 어떤 장면이 더 약한지 찾습니다.

노이즈 수준별 성능도 중요합니다. diffusion 초기 latent는 완성 영상과 분포가 다르므로 같은 LGM이 모든 timestep에서 안정적이라고 가정하면 안 됩니다. 반사, 투명 물체, texture가 적은 벽, 빠르게 움직이는 사람과 큰 가림을 넣어 오차 분포를 확인합니다. 이 구간에서 confidence가 낮으면 reward를 약하게 주거나 학습 대상에서 제외하는 장치가 필요합니다.

reward를 독립적으로 감시하는 기준은 무엇인가

학습에 쓰는 LGM과 같은 모델로 최종 평가하면 reward hacking을 발견하기 어렵습니다. 다른 구조의 depth, pose model, optical flow, 사람 pairwise 평가와 가능하면 실제 camera metadata를 사용합니다. training reward가 상승해도 독립 지표가 정체되거나 떨어지면 정책이 평가기의 특징만 맞추고 있을 수 있습니다.

reward component별 curve도 남깁니다. motion 점수만 오르고 reprojection이 떨어지는지, 둘 다 오르지만 text alignment가 낮아지는지 봅니다. 그룹 안 상대 점수를 쓰는 GRPO에서는 모든 sample이 나쁜데도 그중 덜 나쁜 하나가 양의 신호를 받을 수 있으므로 절대 품질 기준과 최소 threshold를 함께 확인해야 합니다.

GRPO 학습은 어떤 단계로 좁혀 가나

처음에는 낮은 해상도, 짧은 frame의 작은 scene subset으로 connector와 reward pipeline이 작동하는지 확인합니다. 다음 단계에서 base model을 고정하거나 업데이트 범위를 제한해 reward의 영향을 분리합니다. 그 뒤에만 frame 수와 장면 다양성을 늘립니다. 처음부터 긴 고해상도 video를 여러 개 sampling하면 오류 원인과 비용을 동시에 통제하기 어렵습니다.

checkpoint마다 동일 prompt, seed 세트를 생성하고 원래 모델과 나란히 보관합니다. 기하 개선과 동시에 색감, 동작 다양성과 prompt 준수가 무너지지 않는지 회귀 검사합니다. 학습 중 peak VRAM, sample당 시간, decode를 생략해 절약한 시간과 LGM에 추가된 시간을 따로 기록해야 “3~5배” 같은 상대 이득을 자사 환경에서 판단할 수 있습니다.

base model이 바뀌면 무엇을 다시 해야 하나

LGM connector는 특정 latent 표현에 맞춰 학습되므로 VAE, channel 수, scaling이나 noise schedule이 바뀌면 그대로 쓸 수 있다고 단정할 수 없습니다. shape가 맞더라도 feature 의미가 달라 reward가 왜곡될 수 있습니다. 새 base model의 latent에서 LGM 검증을 다시 하고 필요하면 connector를 재학습해야 합니다.

해상도와 aspect ratio 변경도 재투영 조건에 영향을 줍니다. 학습 때 없던 극단적인 camera motion이나 animation style에 전이할 경우 geometry prior가 창의적인 변형을 오류로 볼 수 있습니다. 제품의 영상 종류마다 별도 validation split을 두고, 보상이 의도한 스타일을 과도하게 평탄화하지 않는지 확인합니다.

어떤 사용 사례에 가치가 크고 작은가

카메라가 공간을 이동하며 배경 구조를 유지해야 하는 부동산 preview, 게임 장면과 로봇 시뮬레이션에서는 기하 보상의 가치가 큽니다. 정면 인물의 짧은 talking-head처럼 camera motion이 거의 없는 업무에서는 추가 학습 비용 대비 개선이 작을 수 있습니다. 추상 animation이나 의도적으로 공간을 왜곡하는 영상은 일관성 reward가 창작 목표와 충돌할 수 있습니다.

자율주행, 로봇 학습 데이터는 가장 엄격하게 봐야 합니다. 일관된 것처럼 보이는 생성 영상이 실제 meter 단위 depth나 충돌 가능성을 정확히 표현한다는 보장은 없습니다. 센서 기반 정답과 downstream policy 성능을 확인하기 전에는 시각화와 데이터 증강 후보로만 제한하는 것이 안전합니다.

함께 읽으면 이해가 이어지는 글

자주 묻는 질문

RGB로 decode하지 않으면 사람이 보는 품질도 바로 평가되나요?

아닙니다. latent에서 계산하는 것은 기하 관련 reward이며 최종 시각 품질과 prompt 준수는 복원 영상에서 별도로 평가해야 합니다.

LGM이 틀리면 GRPO가 알아서 보정하나요?

정책은 주어진 reward를 높이도록 학습하므로 오히려 LGM의 오류를 강화할 수 있습니다. 독립 평가기와 사람 검토, 낮은 confidence 구간의 제한이 필요합니다.

어떤 video model에도 connector만 붙이면 되나요?

latent 구조와 분포가 달라질 수 있어 자동 호환되지 않습니다. base model별 LGM 검증과 connector 재학습 여부를 확인해야 합니다.

THE END / OPSOAI

여기까지 읽었습니다

핵심 장면을 한 번 더 떠올려 보세요. 이해가 남았다면 이 책은 제 역할을 다했습니다.

다른 책 고르기
표지 1 —

←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.

CONTENTS

이 책의 목차

    12개 장 16 분읽는 시간