VLANeXt의 핵심은 “더 큰 VLA가 항상 낫다”는 주장보다, 서로 다른 구현에서 뒤섞였던 설계 선택을 같은 프레임워크 안에서 비교해 12가지 관찰을 정리한 데 있습니다. 논문은 그 선택을 조합한 약 2.5B 규모 모델이 LIBERO와 LIBERO-plus의 비교 조건에서 더 큰 OpenVLA 기준선보다 나은 결과를 보고합니다. 다만 벤치마크 성능을 실제 로봇의 비용 절감이나 안전성으로 바로 바꾸지 말고, 데이터, 제어 주기, 하드웨어가 같은 조건에서 각 레시피의 기여를 다시 확인해야 합니다.
VLANeXt의 12가지 VLA 설계 레시피는 어떻게 검증해야 할까
VLANeXt는 어떤 질문을 같은 틀에서 비교했나요?
- 통합 비교 틀: RT-2와 OpenVLA 계열의 구성 요소를 바탕으로 VLA 설계 공간을 분석하고 12가지 관찰을 정리합니다.
- 모델 구성: 관찰된 선택을 조합해 약 2.5B 규모의 VLANeXt를 구성합니다.
- 평가 범위: LIBERO와 LIBERO-plus에서 더 큰 OpenVLA 기준선과 비교한 결과를 보고합니다.
- 해석 조건: 파라미터 수가 작다는 사실은 메모리와 지연의 가능성을 보여 주지만 실제 인프라 비용 절감률을 보장하지 않습니다.
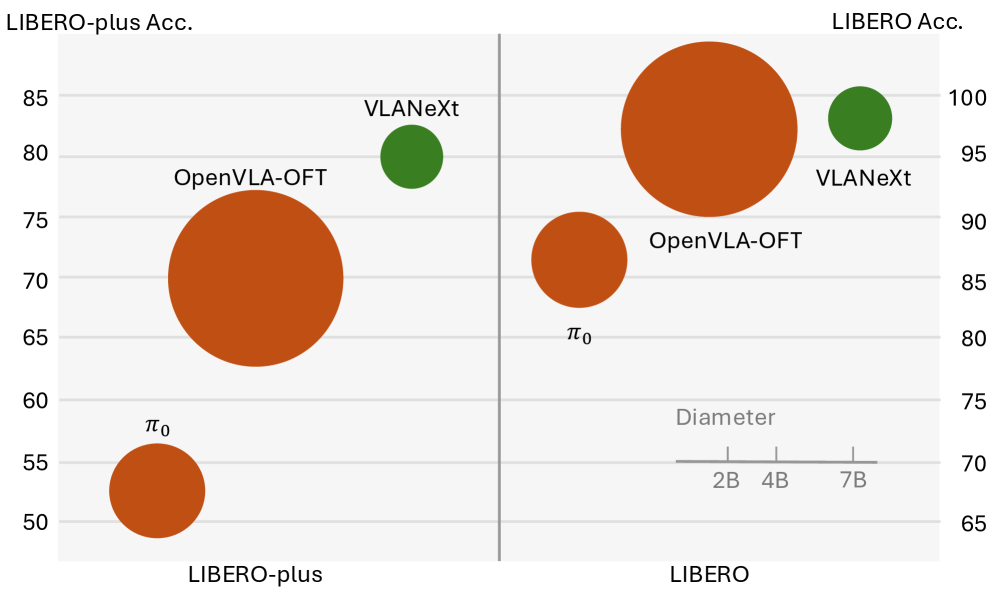 Figure 1: 논문이 제시한 LIBERO 계열 비교 결과입니다. 데이터와 평가 조건 안에서 해석해야 합니다.
왜 모델 크기만 비교해서는 설계 원인을 알기 어렵나요?
기존 VLA 모델은 데이터셋, 토크나이저, 시각 백본, 행동 표현과 학습 방식이 서로 달라 점수 차이가 어느 선택에서 왔는지 분리하기 어렵습니다. 7B 모델과 2.5B 모델의 결과만 놓고 보면 파라미터 규모 외에 데이터 정제, 입력 해상도와 정책 모듈이 함께 바뀌었을 수 있습니다. VLANeXt의 비교 틀이 의미 있는 이유는 이러한 선택을 가능한 한 통제된 조건에서 하나씩 검토하려는 데 있습니다.
그렇다고 12가지 관찰이 모든 로봇과 작업에 그대로 적용되는 보편 법칙은 아닙니다. LIBERO 계열의 물체, 카메라와 행동 공간에서 유리한 연결 방식이 다른 센서, 그리퍼, 제어 빈도에서는 달라질 수 있습니다. 레시피라는 이름은 구현 후보의 우선순위를 뜻할 뿐, 현장 검증을 건너뛰는 처방전이 아닙니다.
세 가지 설계 축은 행동 출력에 어떻게 연결되나요?
연구진은 VLA 설계를 크게 세 가지 차원(기초 구성 요소, 지각 요소, 행동 모델링)에서 분석했습니다.
정책 모듈은 무엇을 결정하나요?
VLA 모델의 핵심은 시각 입력과 언어 명령을 로봇 행동으로 바꾸는 것입니다. 정책 모듈의 구조는 행동 예측이 VLM 표현을 얼마나 직접 사용하는지, 여러 시점의 상태를 어떻게 묶는지와 실행 지연에 영향을 줍니다. 논문은 한 구조를 당연한 정답으로 두지 않고 여러 연결 선택을 비교합니다.
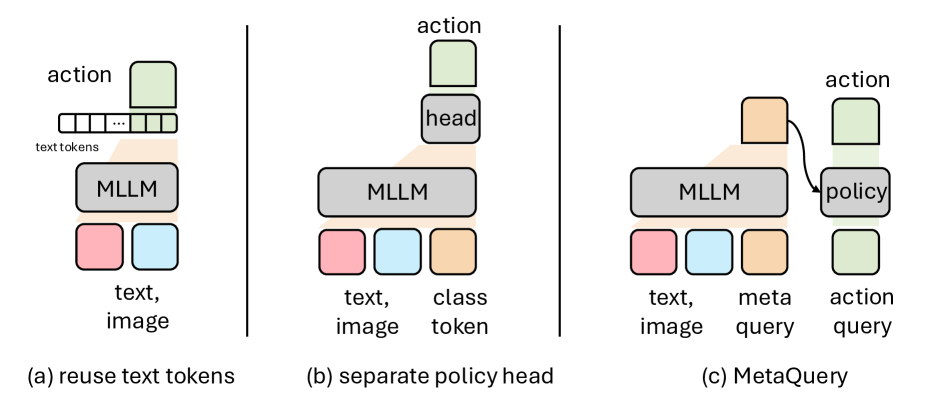 Figure 3: 정책 모듈의 아키텍처 선택을 비교한 구성입니다.
VLM과 정책 모듈은 어디에서 연결되나요?
시각 인코더와 언어 모델에서 나온 표현을 정책 모듈에 어느 깊이와 형식으로 전달하는지는 정보량과 계산량을 함께 바꿉니다. 너무 압축하면 물체 위치나 작은 접촉 단서가 사라질 수 있고, 많은 중간 특징을 모두 넘기면 메모리와 지연이 늘 수 있습니다. 이 선택은 데이터 보안과 직접 같은 개념이 아니며, 보안은 별도의 입력, 권한, 배포 경계로 검증해야 합니다.
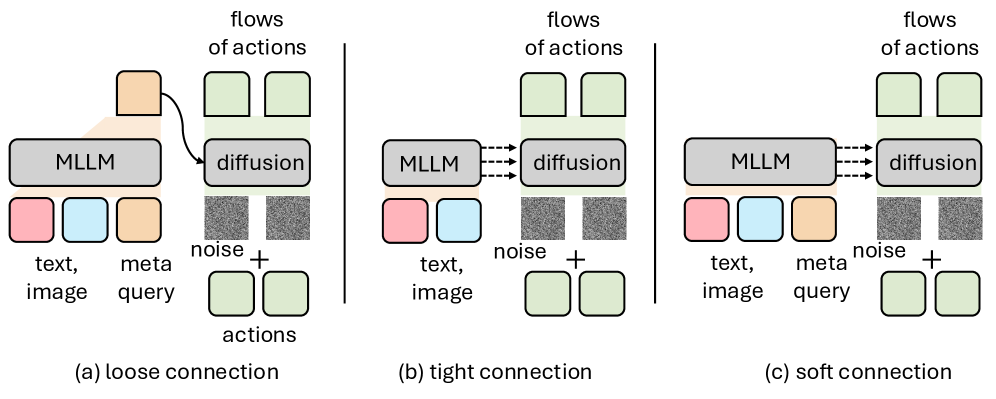 Figure 4: VLM 표현과 정책 모듈의 여러 연결 선택을 보여 줍니다.
고유 수용 감각은 왜 영상과 따로 봐야 하나요?
관절 위치나 그리퍼 상태 같은 고유 수용 감각은 화면만으로 확정하기 어려운 현재 로봇 상태를 제공합니다. 이를 어느 시점에 어떤 표현으로 조건화하는지에 따라 같은 장면에서도 다른 행동을 고를 수 있습니다. 다만 센서 지연이나 좌표계가 영상과 어긋나면 정보를 추가한 것이 오히려 정책을 혼란스럽게 할 수 있습니다.
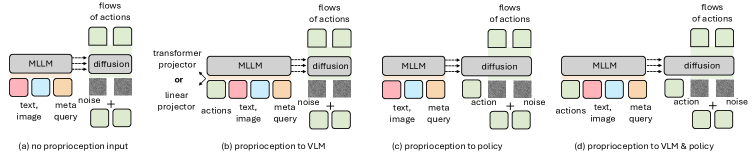 Figure 5: 고유 수용 감각을 주입하는 설계 선택입니다.
세 축은 독립적으로 보이지만 실제로는 상호작용합니다. VLM 연결에서 미세 위치 정보가 줄었다면 정책 모듈이 고유 수용 감각에 더 의존할 수 있고, 행동 표현이 바뀌면 같은 시각 특징의 가치도 달라집니다. 따라서 각 요소의 단독 절제 실험과 최종 조합의 결과를 모두 보아야 “좋은 레시피를 더했다”는 설명이 성립합니다.
12가지 레시피는 어떤 순서로 재현해야 하나요?
처음부터 모든 선택을 최종 구성으로 바꾸면 어느 요소가 자체 데이터에 맞았는지 알 수 없습니다. 공개 기준선 하나를 같은 데이터와 평가 코드로 재현한 뒤, 정책 모듈, 연결 구조, 고유 수용 감각처럼 큰 축을 하나씩 바꿉니다. 각 단계의 성공률, 학습 시간, peak memory와 추론 지연을 남기면 성능 향상과 비용 증가를 함께 볼 수 있습니다.
논문에서 좋은 선택 둘을 합쳤을 때도 이득이 더해진다고 보장할 수 없습니다. 두 구성 요소가 같은 정보를 개선하면 효과가 중복될 수 있고, 한 요소에 맞춘 학습률과 손실 비중이 다른 요소에는 불리할 수 있습니다. 최종 조합이 각 단독 조건보다 실제로 나은지 확인하고, 그렇지 않다면 단순한 구성을 유지하는 것이 재현과 운영에 유리합니다.
재현 결과가 다르면 먼저 데이터 분할, 관측 프레임 수, 행동 정규화, 평가 seed와 성공 판정을 대조합니다. 모델 크기나 GPU만 바꾸기 전에 실험 계약이 같은지 확인해야 설계 선택의 차이로 해석할 수 있습니다.
2.5B 모델은 실제 인프라에서 얼마나 가벼운가요?
파라미터 수가 줄면 가중치 메모리가 줄 가능성은 있지만 전체 추론 비용은 시각 인코더, 입력 프레임 수, 정책 모듈과 실행 정밀도에도 달려 있습니다. 7B와 2.5B라는 숫자만으로 GPU 비용이 특정 비율로 줄거나 엣지 장치에서 바로 실행된다고 단정할 수 없습니다. 같은 해상도, 배치, 행동 출력 길이에서 peak VRAM, 평균과 p95 지연, 전력 사용을 직접 재야 합니다.
로봇 제어에서는 처리량보다 행동이 나오는 종단 지연과 주기 안정성이 중요합니다. 카메라 캡처, 전처리, VLM, 정책 출력과 로봇 통신을 나눠 측정하고 어느 구간이 병목인지 확인합니다. 평균 속도가 목표 주기를 만족해도 긴 꼬리 지연이 생기면 이전 관측에 대한 행동이 늦게 실행될 수 있습니다.
로컬 배포 가능성은 개인정보 보호의 선택지를 넓히지만 모델 크기만으로 보안이 완성되지는 않습니다. 카메라 영상 저장, 원격 로그, 모델 업데이트와 로봇 제어 권한이 어디로 연결되는지 별도로 그려야 합니다. 클라우드와 로컬 중 어느 쪽이 적합한지는 비용뿐 아니라 장애 복구, 접근 제어와 현장 유지보수 능력으로 판단합니다.
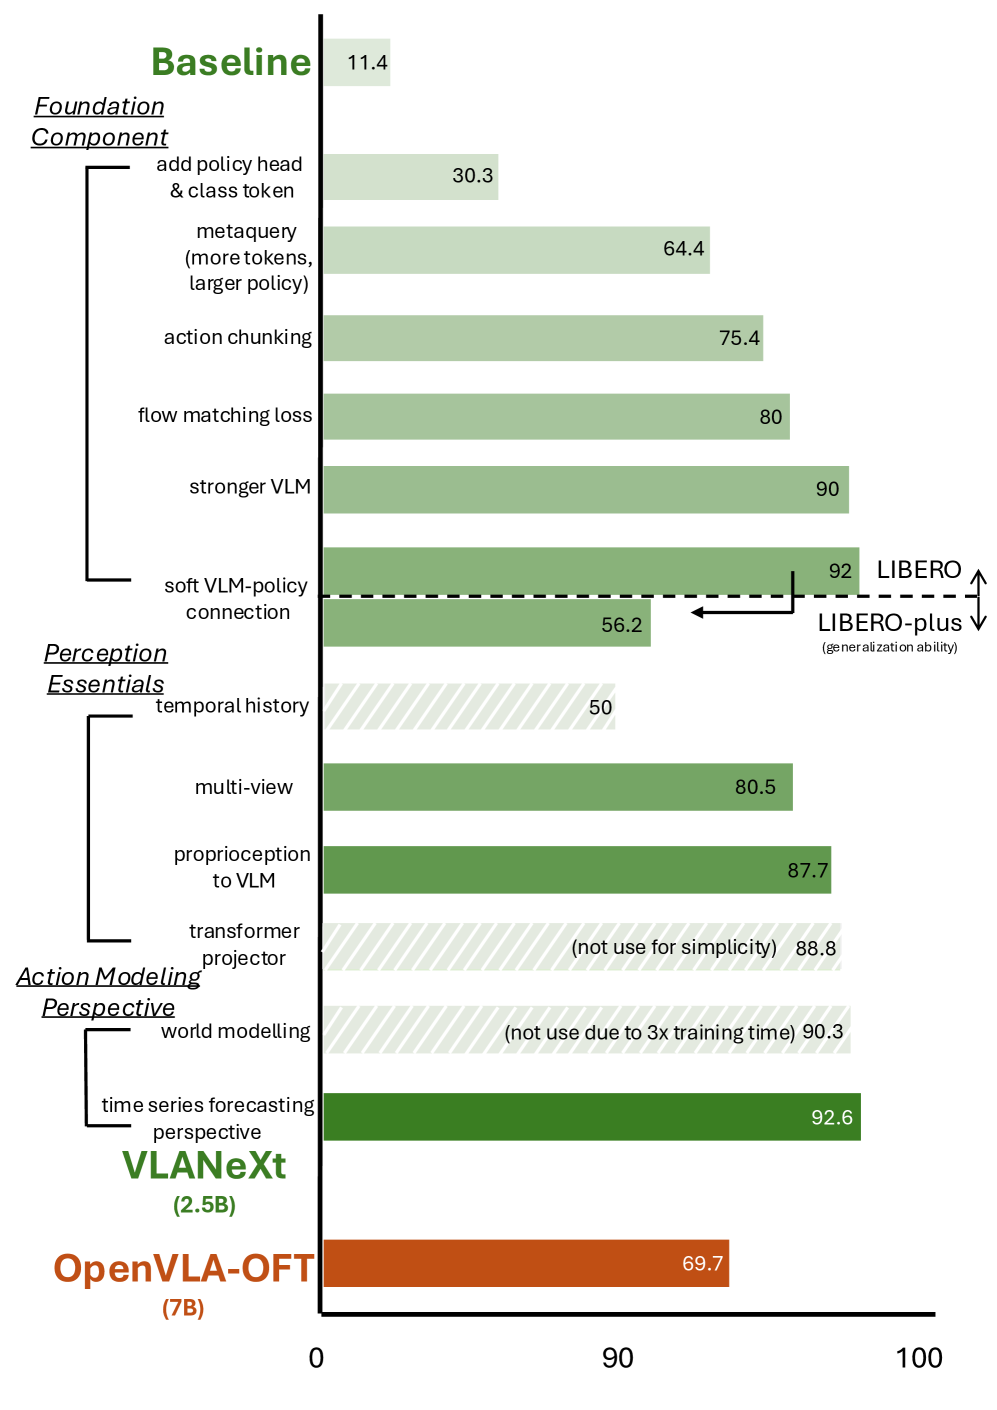 Figure 2: 기준선에서 여러 설계 선택을 더한 성능 변화입니다. 각 단계의 조건을 함께 확인해야 합니다.
LIBERO 결과는 실제 로봇에 어떻게 옮겨 검증하나요?
LIBERO와 LIBERO-plus는 같은 설정에서 모델을 비교하기 좋은 기준이지만 현장의 카메라 위치, 조명, 물체 마찰과 로봇 오차를 모두 포함하지는 않습니다. 벤치마크 개선은 후보 구조를 고르는 근거로 쓰고, 실제 로봇에서는 실패 비용이 낮은 짧은 작업부터 시험해야 합니다. 시뮬레이션과 현실의 차이를 모델 성능 하나로 묶지 않습니다.
평가 과제는 익숙한 물체, 익숙한 배경, 새 물체, 익숙한 배경, 익숙한 물체, 새 배경, 둘 다 새로운 조건으로 나눌 수 있습니다. 성공률과 함께 잘못 집은 물체, 접촉 실패, 시간 초과, 안전 영역 이탈을 유형별로 기록합니다. 평균이 같아도 한 모델이 위험한 충돌을 더 자주 만든다면 배포 판단은 달라집니다.
고유 수용 감각을 사용하는 조건에서는 센서 잡음과 시간 정렬을 일부러 흔들어 봅니다. 카메라 한 대가 가려지거나 관절값이 늦게 도착할 때 정책이 불안정한 행동을 내는지, 입력 이상을 감지하고 멈출 수 있는지 확인합니다. 실제 로봇의 안전 정지와 작업 공간 제한은 VLA 출력과 독립된 계층으로 유지해야 합니다.
어떤 팀에 VLANeXt의 레시피 접근이 맞나요?
VLANeXt가 제공하는 가장 직접적인 가치는 완성 모델 이름보다 VLA 구성 요소를 통제된 실험으로 비교하는 순서입니다. 자체 로봇 데이터와 평가 환경이 있고 모델 구조를 바꿔 재학습할 수 있는 팀이라면 12가지 관찰을 절제 실험의 후보로 쓸 수 있습니다. 반대로 데이터와 안전 평가 없이 파라미터 수만 보고 즉시 현장에 배포하려는 경우에는 논문 결과가 필요한 검증을 대신하지 못합니다.
도입 판단표에는 기준 모델 대비 작업 성공, 위험 실패, 추론 지연, 메모리, 학습 계산량과 유지보수 복잡도를 함께 둡니다. 점수가 조금 높은 구성이 변환과 배포가 훨씬 어렵다면 더 단순한 기준선이 운영에는 나을 수 있습니다. 한 번 정한 레시피도 로봇, 카메라, 데이터 분포가 바뀌면 다시 검증해야 합니다.
결론적으로 VLANeXt는 모델 크기 경쟁보다 설계 선택의 증거를 쌓는 접근을 보여 줍니다. 2.5B 결과의 의미는 자동적인 비용 절감률이 아니라, 더 작은 구성에서도 데이터와 아키텍처 선택에 따라 강한 기준선을 만들 수 있다는 연구 결과입니다. 실제 가치는 같은 실험 규칙으로 자체 작업에서 이 관찰을 재현할 때 확인됩니다.
함께 읽으면 이해가 이어지는 글
- Green-VLA의 5단계 Curriculum은 무엇을 더하나? R2 RL과 OOD 검증 — Green-VLA가 L0, L1, R0, R1, R2 단계로 vision-language grounding, multi-embodiment pretraining, robot adaptation과 RL alignment를 나누는 구조를…
- 로봇 진행률을 말로 묻지 않고 잴 수 있을까? TOPReward의 토큰 확률 — TOPReward가 비디오 VLM의 생성 문장 대신 내부 토큰 확률로 작업 진행률을 추정하는 이유와 VOC 지표가 놓치는 실패를 살펴봅니다.
- BayesianVLA는 왜 로봇이 언어를 무시하는 문제를 줄이나: PMI 수식과 11.3%p — Vision만으로 action을 예측해 language를 무시하는 information collapse를 prior, posterior branch와 latent action query로 분리하는 방식, PMI 목적 함수와 OOD…
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.