코드를 image로 읽히면 전체 구조를 비교하는 clone detection에서는 token을 크게 줄일 수 있지만, 변수 한 글자와 연산자 하나가 중요한 completion에는 압축을 높일수록 위험합니다. CodeOCR은 “text 대신 image가 더 낫다”가 아니라 task마다 visual compression 내성이 다른지 묻는 실험입니다.
코드를 이미지로 읽으면 Token은 줄지만 정확할까? CodeOCR의 8배 압축
Source Code를 Screenshot처럼 렌더링한다
Text code model은 source를 1차원 token sequence로 처리합니다. 프로젝트가 커지면 context와 KV cache가 늘고, 중간 부분을 놓칠 수 있습니다. 개발자는 indentation, block 배치, syntax color로 구조를 빠르게 파악한다는 점에서 CodeOCR은 code를 image로 렌더링해 MLLM에 넣습니다.
Pipeline은 font, 크기, light/dark theme, syntax highlighting을 정해 rendering하고, resolution을 조절해 visual patch 수를 통제한 뒤 vision encoder와 LLM이 처리하는 방식입니다. Text token 1,000개짜리 code를 visual patch 125개로 표현하면 8배 token reduction ratio가 됩니다.
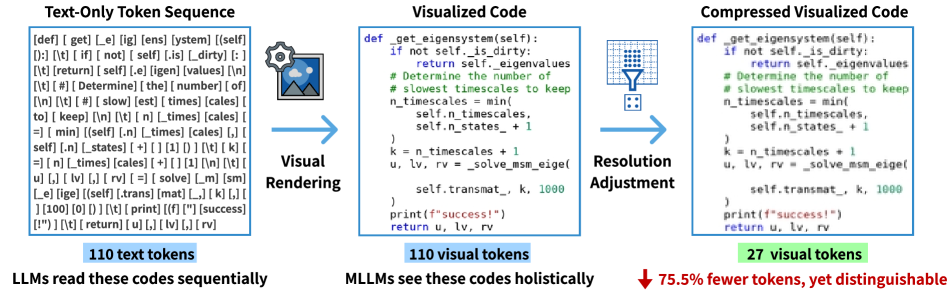
압축률은 정보량과 같지 않습니다. 작은 font가 뭉개지면 token 수는 줄어도 model이 읽을 수 있는 code가 줄어듭니다. 따라서 visual token 개수와 OCR exactness를 같이 측정해야 합니다.
Syntax Highlighting은 저해상도에서 단서를 준다
색상은 keyword, function name, string을 분리해 낮은 resolution에서도 block 경계를 찾게 합니다. 원문은 monochrome보다 syntax-highlighted image가 특히 code completion에서 15~20% 넘게 개선된 결과를 보고합니다. 이는 color가 semantics를 직접 증명한다기보다 중요한 token category를 구분하는 inductive bias로 작동한 결과로 해석됩니다.
다만 theme가 바뀌거나 color가 압축 과정에서 섞이면 이 이득이 유지되는지 별도 검증해야 합니다. 특정 language의 syntax highlighter에 과적합할 가능성도 있습니다. 실제 repository에는 여러 language와 generated file이 섞이므로 하나의 theme benchmark만으로 충분하지 않습니다.
Clone Detection과 Completion은 같은 압축률을 쓰면 안 된다
평가는 HumanEval, MBPP 기반 completion, code summarization, BigCloneBench 기반 clone detection을 포함합니다. GPT-4o와 Claude 3.5 Sonnet뿐 아니라 LLaVA, InternVL 계열도 사용해 modality 효과를 비교합니다.
원문에서는 최대 8배 압축에서도 많은 model이 text baseline과 경쟁했고, 전체 flow 유사성을 보는 clone detection이 압축에 특히 잘 버텼습니다. 반면 completion은 variable name, bracket, operator를 정확히 읽어야 합니다. 작은 §i§와 §l§, §+§와 §++§를 혼동하면 실행 의미가 달라집니다.
따라서 repository overview나 duplicate 탐색에는 높은 압축을 시험할 수 있지만, patch 생성, security review, compiler 수준 확인에는 원문 text를 함께 제공하는 hybrid가 안전합니다. “긴 code를 screenshot 한 장으로 보내면 된다”는 완전 실행법이 아닙니다.
Rendering 비용과 실패를 포함해 비교한다
Code image 생성에는 CPU/GPU rendering 시간이 들고, 긴 file을 여러 page로 나누면 model call 수도 늘어납니다. 실무 비교에는 text token 비용, visual token 비용, render latency, peak memory, task accuracy를 모두 포함해야 합니다. 고정 patch size를 쓰는 MLLM에서는 file 길이에 따른 dynamic resolution도 쉽지 않습니다.
검증용 sample에는 비슷한 변수명, 한 글자 operator 차이, 깊은 indentation, 긴 주석, 여러 programming language를 넣습니다. Model이 구조 질문에는 맞지만 line-level 질문에 실패하는 경계를 찾아야 합니다. CodeOCR의 실용적 결론은 구조적 pattern은 image로 압축하고, 실행 의미를 결정하는 세부 code는 text로 보존하는 혼합 전략입니다.
Token reduction과 정보 보존은 어떻게 따로 측정할까
1,000 text token을 125 visual token으로 바꾸면 계산상 8배 reduction이지만 125 token이 모든 문자를 복원한다는 뜻은 아닙니다. Compression ratio 옆에 rendering image를 다시 읽은 character, symbol exact match를 둡니다. 특히 identifier와 operator에는 일반 문장보다 높은 가중치를 줘야 합니다.
| Test snippet | 확인할 오독 | 실행상 영향 |
|---|---|---|
count와 counter | identifier suffix 누락 | 다른 variable 참조 |
<, <=, != | 작은 operator 차이 | branch 조건 변경 |
i, l, 1 | 비슷한 glyph | index, constant 혼동 |
| Python indentation | 공백, block 경계 | control flow 변경 |
| Comment와 string | syntax color 의존 | code와 data 혼동 |
Model에게 screenshot 내용을 그대로 transcription하게 한 뒤 compiler, parser로 확인하면 perception 상한을 볼 수 있습니다. Transcription부터 틀리는 resolution에서는 completion 점수를 더 시험하기 전에 압축률을 낮춰야 합니다. 반대로 정확한 transcription이 가능한데 reasoning이 틀리면 language reasoning 쪽 문제입니다.
Task별로 어떤 입력을 routing할까
Repository 전체에서 duplicate 후보를 찾거나 module 구조를 요약하는 query는 여러 file을 축소 image로 보여주는 실험 가치가 있습니다. 후보 file이 정해진 뒤 실제 patch를 만들거나 vulnerability line을 판단할 때는 해당 span을 text로 다시 제공합니다. Wide view와 exact view를 나누는 방식입니다.
1
2
3
구조 탐색: code image로 넓은 file, block pattern 확인
후보 선택: 관련 function, line 범위 식별
정밀 작업: 원문 text + line number + compiler 결과 사용
이 hybrid는 image가 정확한 source of truth가 되는 것을 막습니다. Model이 screenshot에서 본 line을 인용할 때 원문 text와 일치하는지 검사하고, 한 글자라도 다른 patch는 적용하지 않습니다. Code execution이나 security 결정에는 parser, test와 사람이 확인할 수 있는 text diff가 남아야 합니다.
Theme와 layout에 과적합했는지 어떻게 알까
Training과 같은 font, dark theme에서만 정확하면 실제 IDE나 generated screenshot에 옮기기 어렵습니다. Font family, size, light/dark, line spacing, wrap, tab width와 syntax highlighter를 바꾼 robustness set을 둡니다. Color를 grayscale로 바꾼 결과와 비교하면 geometry와 syntax color 중 어느 단서를 썼는지 알 수 있습니다.
긴 line이 잘리거나 여러 page 사이에서 function이 분리되는 조건도 중요합니다. Page overlap을 주면 context 중복으로 token 이득이 줄고, overlap이 없으면 boundary의 variable definition을 잃을 수 있습니다. File length별 page 수와 call 수를 포함해 end-to-end latency를 계산합니다.
PoC 합격은 단순 8배가 아닙니다. 목표 task의 정확도가 text baseline 허용 범위 안에 있고, render, vision encoder를 포함한 비용이 줄며, exact symbol이 필요한 순간에는 text로 안전하게 전환돼야 합니다.
함께 읽으면 이해가 이어지는 글
- 비디오 검색 에이전트가 더 자율적이면 왜 더 틀릴까: VideoDR — 영상 단서와 공개 웹을 함께 써야 푸는 벤치마크에서 Workflow와 Agentic 구조가 갈린 이유와 Goal Drift 방지법
- Youtu-VL은 객체 검출 헤드를 없앨 수 있을까: Vision-as-Target과 NTP-M 구조 — 시각을 예측 대상으로 삼는 VLUAS와 별도 디코더 없이 dense prediction을 수행하는 NTP-M의 이득과 비용을 분석합니다.
- OV-Encoder는 비디오 토큰을 80% 줄여도 더 정확할까: 3.1~25% Residual 선택의 맹점 — 코덱 잔차 영역만 토큰화하는 OV-Encoder의 +4.1% 성능과 최대 80% 토큰 절감이 성립하는 조건을 분석합니다.
자주 묻는 질문
Code를 image로 바꾸면 최대 8배의 정보를 그대로 보존하나요?
아닙니다. Visual token 수는 줄어도 작은 variable, operator, indentation이 뭉개질 수 있으므로 압축률과 symbol-level OCR exactness를 함께 봐야 합니다.
어떤 code task가 image 압축에 더 잘 견디나요?
전체 구조와 유사성을 보는 clone detection, repository overview는 비교적 견딜 수 있지만 exact token이 필요한 completion, patch, security review는 원문 text 보존이 안전합니다.
Syntax highlighting 색상만 쓰면 정확도가 유지되나요?
색상이 token category 단서를 줄 수 있지만 theme, language, image compression이 바뀌면 효과가 약해질 수 있어 monochrome, 여러 theme, 다중 language에서 재검증해야 합니다.
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.