OV-Encoder는 원문 실험에서 시각 토큰을 최대 80% 줄이면서 비디오 이해 평균을 Qwen3-ViT보다 4.1% 높였지만, 이 이득은 코덱 잔차가 의미 있는 변화를 제대로 드러낼 때 성립합니다. 토큰 수 감소가 곧 같은 비율의 지연, 전력 감소를 보장하지도 않으므로 전처리까지 포함한 측정이 필요합니다.
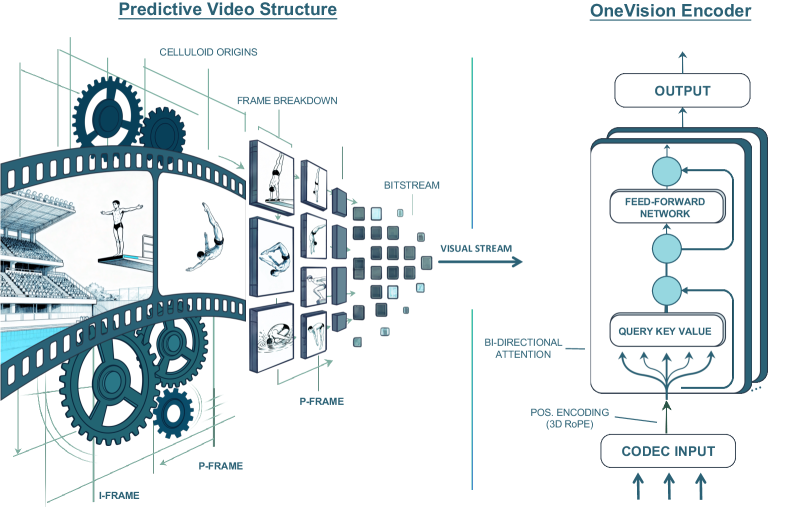 고정된 공간 맥락과 희소한 시간 변화로 비디오를 보는 codec-aligned compression.
OV-Encoder는 원문 실험에서 시각 토큰을 최대 80% 줄이면서 비디오 이해 평균을 Qwen3-ViT보다 4.1% 높였지만, 이 이득은 코덱 잔차가 의미 있는 변화를 제대로 드러낼 때 성립합니다. 토큰 수 감소가 곧 같은 비율의 지연, 전력 감소를 보장하지도 않으므로 전처리까지 포함한 측정이 필요합니다.
고정된 공간 맥락과 희소한 시간 변화로 비디오를 보는 codec-aligned compression.
일반 ViT는 프레임마다 같은 크기의 grid patch를 만듭니다. 배경이 그대로여도 매번 비슷한 토큰이 컨텍스트를 차지합니다. 원문은 비디오 데이터의 90% 이상이 이전 프레임과 중복되거나 예측 가능한 내용이라고 설명합니다.
프레임 수와 해상도가 커질 때 토큰 수 자체가 기하급수적으로 늘어나는 것은 아니지만, 표준 self-attention은 토큰 수 $N$에 대해 $O(N^2)$ 비용을 갖습니다. 중복 토큰은 연산뿐 아니라 제한된 context window에서 오래 추적해야 할 사건의 자리를 빼앗습니다.
OV-Encoder의 질문은 단순합니다. 코덱이 이미 전체 장면과 변화분을 나누는데, 비전 인코더도 그 구조를 이용할 수 없느냐는 것입니다.
Codec Patchification은 I-frame에서 공간 구조를 조밀하게 잡고, P-frame에서는 motion-compensated residual이 큰 영역을 선택합니다.
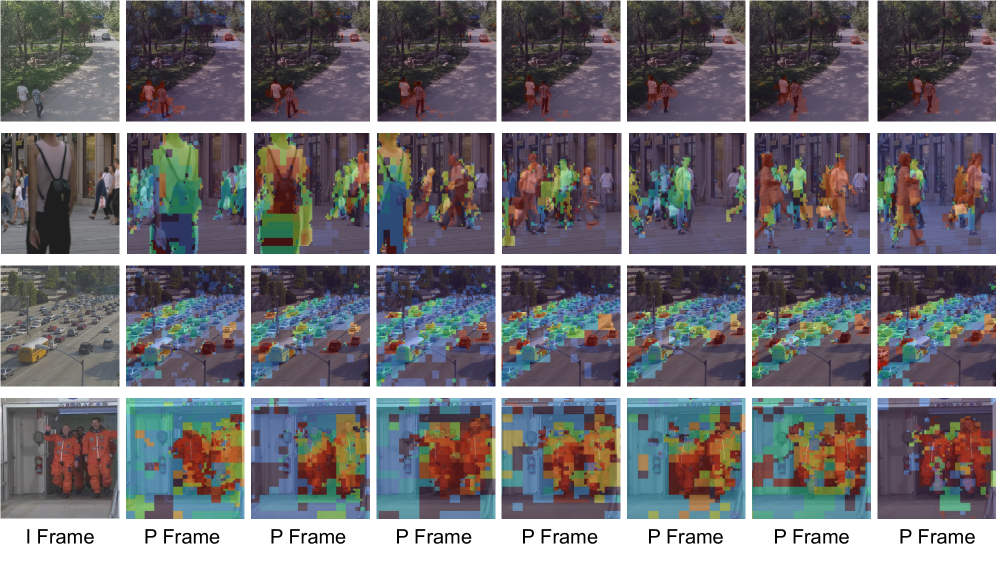 HEVC의 I-frame과 움직임 잔차가 밝게 표시된 P-frame.
원문에서 선택되는 유효 토큰은 전체의 약 3.1%~25%입니다. 모델은 dense video, chunk-wise, single-image/frame spatial patchification을 입력에 맞게 사용하고 같은 encoder parameter를 공유합니다.
희소 토큰은 규칙적인 grid 위치를 잃으므로 시간과 공간의 상대적 offset을 기록하는 3D-RoPE가 필요합니다.
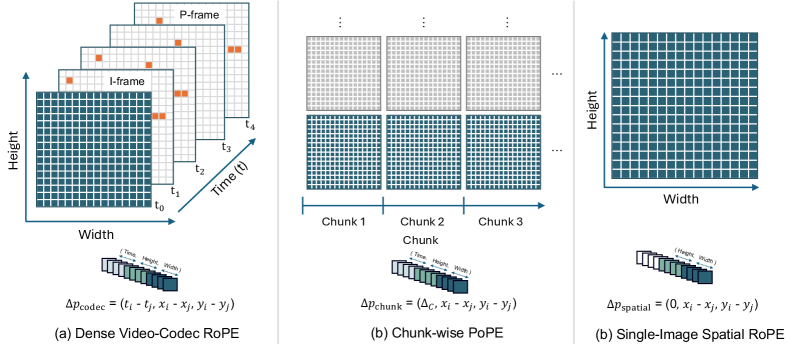 불규칙한 희소 토큰에 시간, 가로, 세로 위치를 부여하는 3D-RoPE.
3D-RoPE는 $\Delta t$, $\Delta x$, $\Delta y$를 이용해 선택되지 않은 패치 사이의 간격까지 표현합니다. 이 좌표가 없으면 서로 멀리 떨어진 두 residual token이 sequence에서 이웃이라는 이유로 가까운 장면처럼 처리될 수 있습니다.
OV-Encoder는 patchification만 바꾼 모델이 아닙니다. 이미지와 비디오 embedding을 global cluster center에 정렬하는 cluster discrimination objective를 함께 사용합니다.
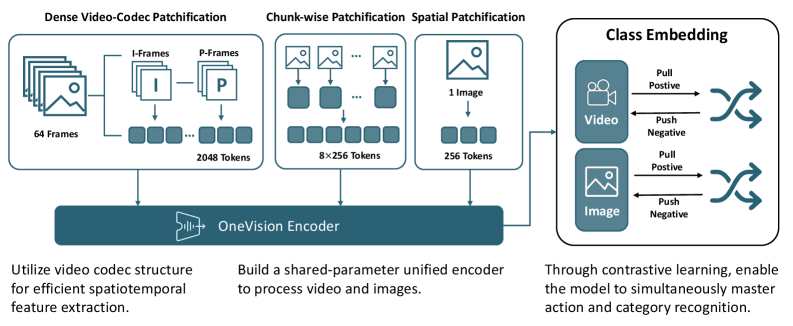 세 patchification 전략과 공유 인코더, global cluster objective.
일반 contrastive learning이 batch 안의 negative에 주로 의존한다면, 이 방식은 100만 개 이상의 semantic concept을 담은 global concept bank와 비교합니다.
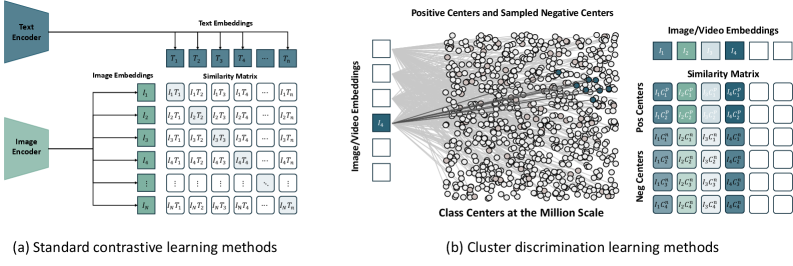 Batch-local negative와 global concept center를 이용한 판별의 차이.
따라서 +4.1%가 residual selection 하나의 효과라고 단정할 수 없습니다. patchification, 3D 위치 표현, 더 넓은 cluster supervision이 함께 들어간 결과입니다.
원문은 VQAv2, OK-VQA, ActivityNet, MSVD, 문서, OCR를 포함한 16개 이상의 벤치마크를 언급합니다. 비디오에서는 Qwen3-ViT 대비 평균 4.1% 향상, SigLIP2의 절반 이하 토큰, dense model 대비 최대 80% 토큰 절감을 제시합니다. 데이터와 모델 규모가 커질 때 희소 모델도 scaling trend를 보였다는 설명도 있습니다.
그러나 다음 값은 이 글에 없습니다.
Attention 입력이 줄어도 codec decode, patch selection, 3D coordinate 생성이 새 비용으로 들어옵니다. “서버 부하 1/10”이나 스마트폰 실시간 구동은 원문의 응용 전망이지 측정 결과가 아닙니다.
움직임이 큰 곳이 항상 의미가 큰 곳은 아닙니다. 고정된 계기판의 작은 숫자, 멈춰 있는 표지판, 압축 노이즈 속의 작은 객체는 residual magnitude만으로 우선순위를 정하기 어렵습니다. 반대로 카메라 흔들림이나 노이즈는 화면 전체를 변화 영역으로 만들어 희소성 이득을 없앨 수 있습니다.
도입 시험은 장면 유형을 나눠야 합니다.
각 유형에서 선택 토큰 비율, 정답률, codec 전처리 시간, encoder 시간, 최대 메모리를 함께 기록하면 희소성의 실제 값을 볼 수 있습니다. OV-Encoder는 “모든 픽셀은 불필요하다”는 결론보다, 비디오의 예측 구조를 token budget에 반영할 때 무엇을 놓치는지까지 측정하라는 설계 원칙에 가깝습니다.
Residual은 장면의 의미만 반영하는 값이 아니라 인코딩 설정의 결과이기도 합니다. 같은 원본 영상도 코덱, 압축률, keyframe 간격, motion estimation 방식이 달라지면 밝게 남는 영역과 선택 토큰 비율이 바뀔 수 있습니다. 배포 입력이 연구 설정과 다른 스트리밍 영상이나 여러 번 재인코딩된 파일이라면 논문의 3.1~25% 범위를 그대로 용량 계획에 쓰기 어렵습니다.
검증에서는 같은 원본 클립을 서로 다른 압축 조건으로 만든 뒤 답의 일관성을 비교해야 합니다. 사람이 보기에는 같은 사건인데 선택 토큰과 답이 크게 바뀌면 모델이 장면보다 코덱 흔적에 민감한 것입니다. 고정 카메라 영상, 빠른 카메라 이동, 화면 전체 노이즈, 작은 정적 글자를 각각 넣으면 희소성이 사라지는 경우와 중요한 정적 단서를 버리는 경우를 나눌 수 있습니다.
종단 지연도 단계별로 쪼갭니다. 파일 읽기와 codec parsing, residual map 계산, token 선택, vision encoder, language decoder의 시간을 따로 측정합니다. 시각 토큰이 80% 줄어도 전처리가 길거나 language decoder가 병목이면 사용자 지연은 훨씬 적게 줄 수 있습니다. 반대로 긴 비디오에서 컨텍스트 초과를 막아 재시도를 줄인다면 단순한 한 번의 속도보다 전체 작업 성공률이 좋아질 수 있습니다.
품질 하한은 평균 점수가 아니라 중요한 사건의 재현율로 정하는 편이 안전합니다. 안전 장비의 작은 경고등, 멈춰 있는 표지판, 짧게 나타난 객체를 놓치면 다른 일반 장면에서 얻은 토큰 절감으로 상쇄되지 않습니다. 업무상 필수 사건을 모은 별도 세트에서 dense 입력과 희소 입력의 누락률을 비교하고, 누락이 허용치를 넘으면 residual threshold를 낮추거나 해당 영상 유형만 dense 경로로 보내야 합니다.
이 과정을 거쳐야 +4.1%와 최대 80%라는 서로 다른 지표가 실제 시스템 판단으로 연결됩니다. 하나는 선택된 평가의 정확도 변화이고 다른 하나는 입력 토큰 변화이므로, 동일 하드웨어의 종단 처리량과 중요한 사건 누락률까지 확인한 뒤에만 비용 절감으로 환산할 수 있습니다.
구성 요소의 기여는 dense 입력, codec patchification만 적용한 입력, 3D-RoPE와 cluster objective까지 넣은 전체 구성을 같은 학습, 추론 예산에서 비교해야 합니다. 전체 모델만 기준선보다 좋다면 토큰 선택 자체가 정확도를 높였는지 다른 학습 목표가 손실을 보상했는지 알 수 없습니다. 중요한 정적 신호가 빠진 사례에서 dense 경로가 답을 복구하는지도 확인하면 희소 입력의 실패를 감지해 우회할 수 있는 기준을 만들 수 있습니다.
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.