“아침 회의 발표자가 오후 카페에서 누구와 있었나” 같은 질문은 한 번의 이미지 유사도 검색으로 풀기 어렵고, DeepImageSearch는 첫 사건을 찾은 뒤 그 단서로 다음 사건을 재검색합니다. 대신 검색, 필터, 검증 호출이 이어지므로 정확도 이득은 지연 시간, 도구 누락, 개인정보 범위와 함께 판단해야 합니다.
사진 수만 장에서 나중에 다시 만난 사람을 찾을까: DeepImageSearch의 검색 비용과 오류 전파
한 장을 찾는 검색과 사건을 잇는 검색은 왜 다를까?
CLIP 계열 검색은 각 이미지를 독립적으로 보고 텍스트와 가까운 순서로 반환합니다. “빨간 코트를 입은 사람”에는 적합하지만, 오전과 오후에 같은 사람이 등장했는지처럼 시간적 맥락이 답의 일부인 질문은 한 이미지에 모든 단서가 없습니다.
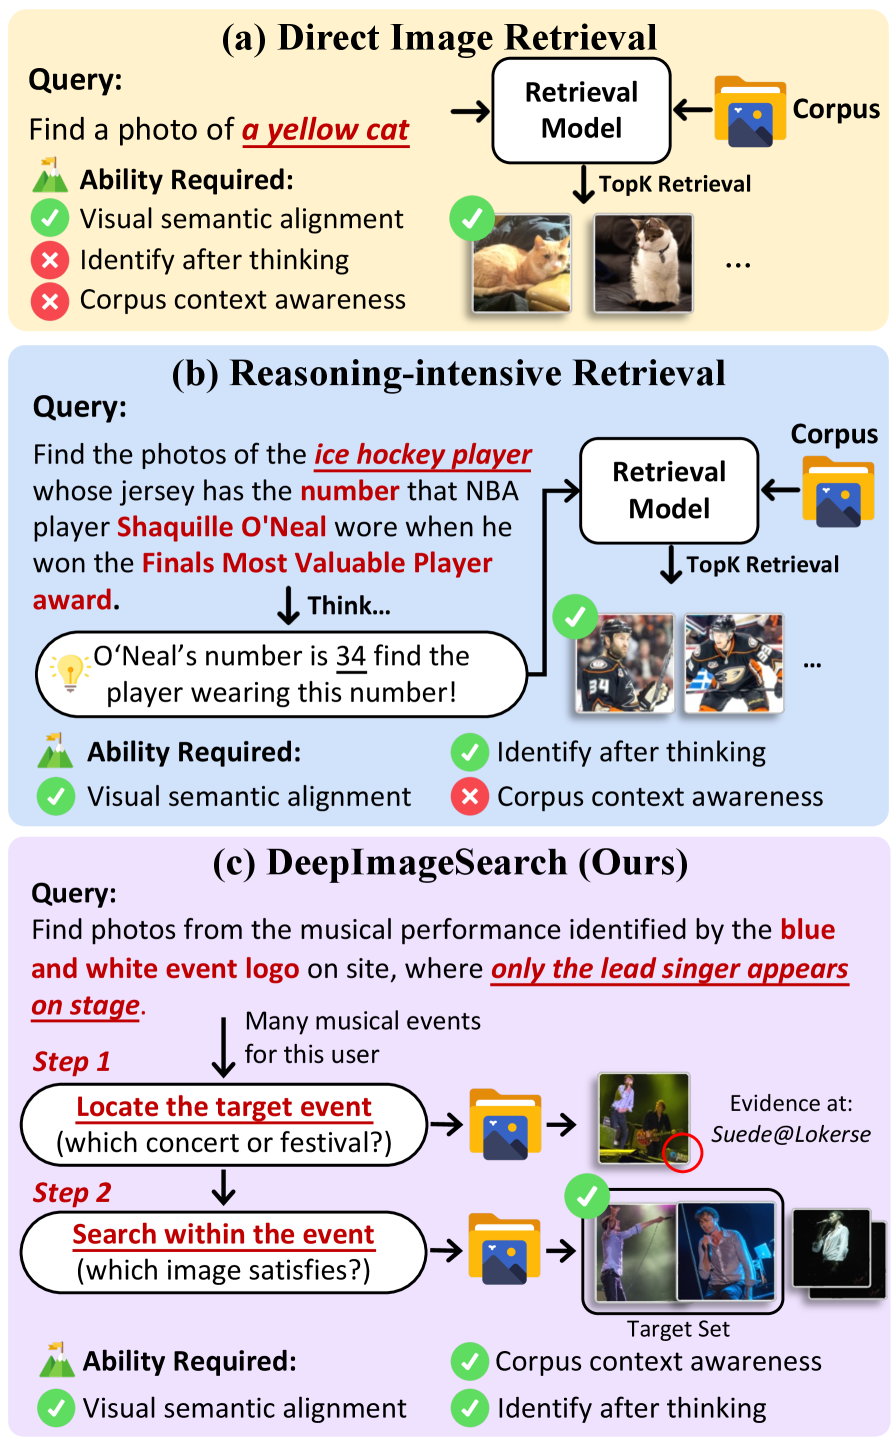 직접 검색, 지식 기반 검색, 시각적 이력을 탐색하는 DeepImageSearch의 차이.
DeepImageSearch는 검색을 다음과 같은 다단계 작업으로 바꿉니다.
- 질문을 여러 조건으로 분해합니다.
- 첫 이벤트의 후보 이미지를 검색합니다.
- 인물, 장소, 시간 단서를 작업 메모리에 남깁니다.
- 그 단서로 다른 이벤트를 다시 검색합니다.
- 최종 후보가 모든 조건을 만족하는지 검증합니다.
이 구조에서는 첫 후보의 인물 식별이 틀리면 다음 검색 전체가 잘못된 방향으로 갈 수 있습니다. 추론 모델뿐 아니라 초기 검색기의 recall이 중요합니다.
DISBench는 사건 안과 사건 사이를 어떻게 나눠 물을까?
DISBench에는 두 유형의 질의가 있습니다.
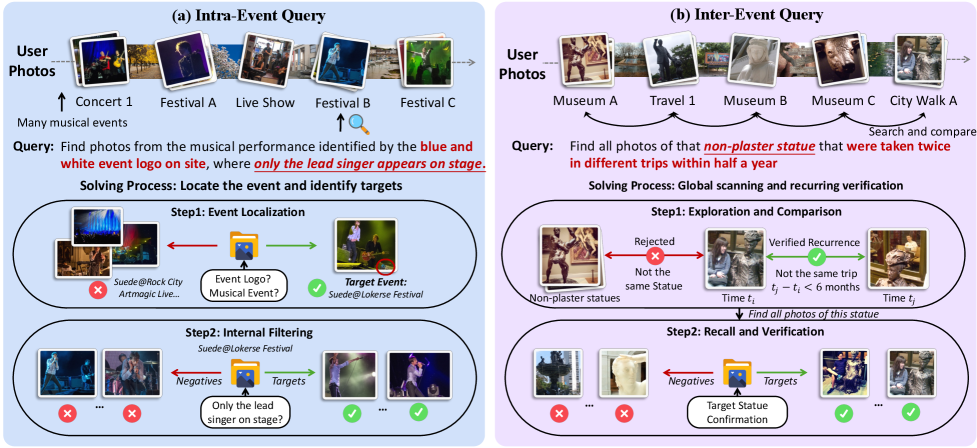 하나의 이벤트를 좁히는 intra-event와 여러 이벤트를 잇는 inter-event 질의.
- Intra-event: 공원에서 요가한 사람 중 파란 매트를 사용한 사람처럼 한 사건 내부의 속성을 조합합니다.
- Inter-event: 오전 마트에서 본 인물이 저녁 식당에도 등장했는지처럼 여러 사건을 연결합니다.
데이터는 VLM이 이미지의 인물, 행동, 장소 속성을 추출하고, 이를 memory graph로 조직한 뒤 random walk로 관계 경로와 질문 초안을 만드는 반자동 방식입니다. 마지막에는 사람이 질문의 논리와 답을 검증합니다.
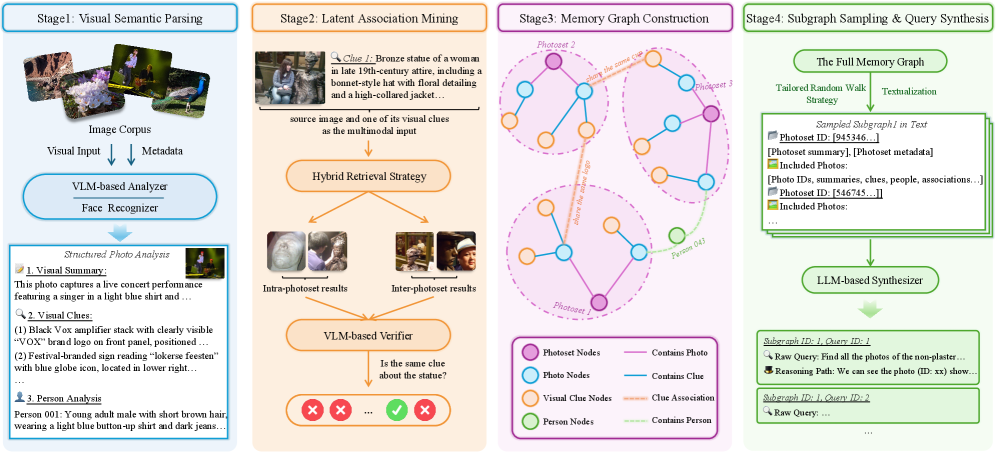 속성 추출, memory graph, random walk, 사람 검증으로 이어지는 구축 과정.
이 방식은 관계가 명확한 평가 문제를 만들기 좋지만, 실제 사진첩의 누락된 시간 정보, 흔들린 사진, 비슷한 얼굴과 우연한 동시 등장까지 그대로 재현한다는 뜻은 아닙니다.
왜 에이전트 성능이 검색 도구와 두 메모리에 묶일까?
프레임워크는 Search, Filter, Verify처럼 세분화된 도구와 ReAct 방식의 계획을 사용합니다. 작업 메모리는 현재 가설과 단서를 유지하고, 장기 메모리는 전체 visual history를 참조합니다. 첫 결과를 보고 다음 query를 바꾸는 점이 single-turn retrieval과 다릅니다.
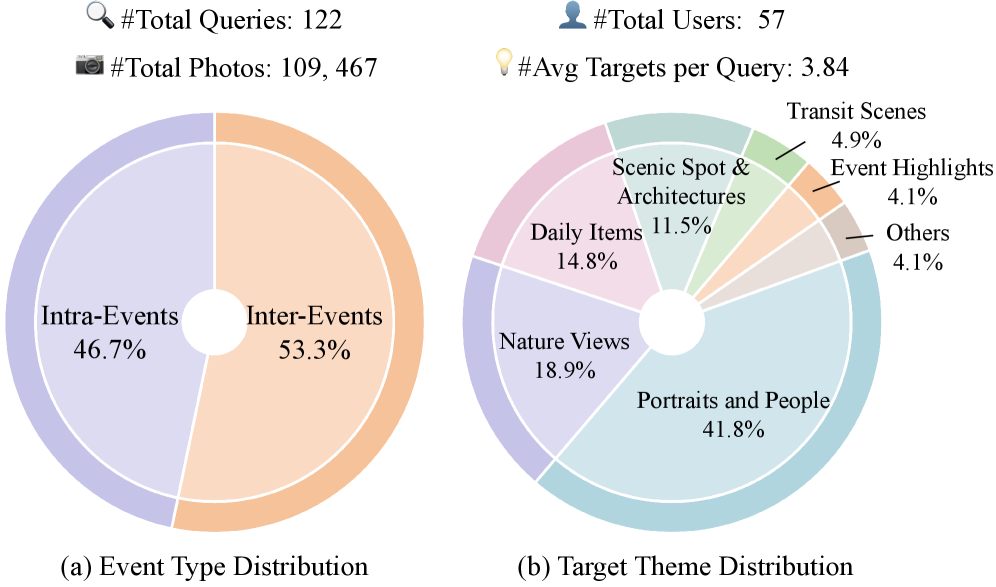 DISBench의 질의 유형과 대상 이미지 테마 분포.
평가에는 GPT-4o, Gemini-1.5-Pro와 LLaVA 계열 모델이 언급됩니다. 같은 reasoning model이라도 제공된 검색 엔진과 필터가 중요한 인물을 후보군에서 빼면 정답에 도달할 수 없습니다. 반대로 검색 결과가 넓으면 모델은 더 많은 이미지를 비교하느라 토큰과 시간이 늘어납니다.
실패를 분석할 때는 최종 정답 하나보다 단계를 나눠야 합니다.
| 단계 | 확인할 실패 |
|---|---|
| 초기 검색 | 정답 사건이 후보에 포함되지 않음 |
| 속성 추출 | 인물, 행동, 장소를 잘못 읽음 |
| 상태 유지 | 이전 사건의 단서를 잊거나 섞음 |
| 검증 | 조건 일부만 맞는 후보를 최종 선택 |
| 중단 | 충분한 근거가 없는데 답을 확정 |
Test-time scaling은 어디까지 이득일까?
연구는 Best-of-N과 Beam Search로 여러 탐색 경로를 시험합니다. 더 많은 reasoning step을 허용하면 single-turn보다 성공률이 오르지만, 일정 수준 이후 향상이 수렴하는 경향을 보입니다.
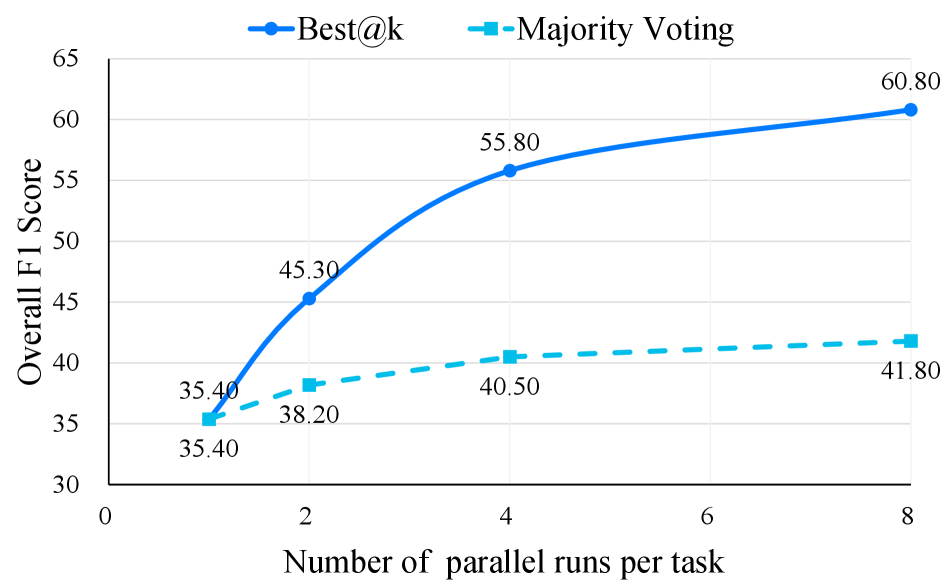 탐색 전략과 test-time compute 증가에 따른 성능 변화.
이는 호출 횟수를 무작정 늘려도 초기 검색 누락이나 잘못된 visual attribute를 복구하지 못한다는 뜻입니다. 폐쇄형 모델이 오픈소스 LMM보다 복잡한 tool call과 상태 유지에서 앞섰다는 설명도 있지만, 이 글에는 모델별 절대 점수와 호출 비용이 없습니다.
실서비스에서는 질문당 최대 검색 횟수, 후보 이미지 수, 시간 제한을 정하고 다음을 함께 기록해야 합니다.
- Recall@K와 최종 정답률
- 평균 및 P95 도구 호출 수
- 이미지 재인코딩 수와 응답 지연
- 근거 이미지가 부족해 답변을 보류한 비율
- 같은 질문을 반복했을 때 경로의 안정성
사진 기억을 연결할수록 어떤 접근 권한이 필요할까?
개인 사진, 로봇 카메라, CCTV는 시간과 장소를 잇는 순간 단일 이미지보다 민감한 정보를 드러낼 수 있습니다. 검색 에이전트가 장기 메모리 전체를 볼 수 있게 하기 전에 사용자, 장소, 기간별 접근 범위를 분리하고, 최종 답과 함께 어떤 이미지 경로를 사용했는지 남겨야 합니다.
DeepImageSearch가 적합한 경우는 질문의 답이 여러 사건에 흩어져 있고, 단순 top-K 검색의 실패가 반복되는 환경입니다. 한 이미지의 객체나 색만 찾으면 되는 작업에는 다단계 에이전트가 불필요한 비용일 수 있습니다. 도입 여부는 “맥락을 이해한다”는 문구보다, 정답이 빠진 후보를 얼마나 복구하고 그 과정의 근거를 얼마나 감사할 수 있는지로 결정해야 합니다.
다단계 검색을 언제 중단하고 답을 보류해야 할까?
첫 검색에서 정답 사건이 후보에 없으면 이후 추론을 늘려도 복구하기 어렵습니다. 후보를 넓히기 전에 질문의 핵심 단서가 인덱스에 표현돼 있는지 확인하고, 일정 횟수 뒤에도 관련 이미지가 없으면 “찾지 못함”으로 끝낼 수 있어야 합니다. 근거 부족을 답변 실패가 아니라 안전한 중단으로 측정하는 이유입니다.
서로 다른 경로가 다른 인물을 가리킬 때도 추가 호출만 반복하면 비용이 늘 수 있습니다. 인물, 장소, 시간 중 어느 단서가 충돌하는지 표시하고, 같은 사진에서 확인할 수 없는 관계라면 사람 검토로 넘깁니다. Beam Search의 여러 경로가 같은 초기 오인에서 출발했다면 합의도 신뢰 근거가 되지 않습니다.
중단 조건에는 최대 도구 호출 수와 시간뿐 아니라 최소 근거 수를 둘 수 있습니다. inter-event 답변이라면 각 사건을 지지하는 이미지와 두 사건을 연결하는 식별 단서가 있어야 합니다. 조건 일부만 맞는 후보를 발견했을 때 나머지를 모델의 상식으로 채우지 않도록 최종 검증 단계가 이를 명시적으로 확인해야 합니다.
재현성 시험에서는 같은 질문을 여러 번 실행해 검색 경로와 최종 근거가 얼마나 달라지는지 봅니다. 답이 같아도 근거 이미지가 계속 바뀌거나 우연히 한 번만 정답을 찾는다면 운영 안정성이 낮습니다. 자주 쓰는 질의 유형에는 검증된 경로를 캐시할 수 있지만 사진 삭제와 접근 권한 변경이 즉시 반영되는지도 확인해야 합니다.
개인 사진에서는 답변을 보류하는 기능이 개인정보 보호와도 연결됩니다. 다른 사람의 사진까지 장기 메모리에 묶거나 불확실한 얼굴을 같은 사람으로 확정하면 잘못된 관계를 만들 수 있습니다. 접근 범위, 보존 기간, 근거 이미지 삭제와 감사 로그를 검색 정확도와 같은 수준의 배포 조건으로 다뤄야 합니다.
초기 검색기의 후보 수를 늘릴 때는 개인정보 노출과 비용이 함께 커집니다. 관련성이 낮은 사진까지 추론 모델에 보내면 정답 가능성보다 불필요한 얼굴, 장소 정보의 처리 범위가 더 빠르게 늘 수 있습니다. 필요한 기간과 앨범을 먼저 좁히고 그 안에서 recall을 조정하는 편이 낫습니다.
사용자에게는 최종 답과 함께 근거 이미지의 날짜, 위치 범위와 연결한 조건을 보여 줄 수 있습니다. 모델이 잘못된 사람을 연결했을 때 사용자가 수정하거나 삭제를 요청할 경로도 필요합니다. 근거를 보여 줄 수 없는 답은 높은 자신감이라도 자동으로 확정하지 않는 정책을 둘 수 있습니다.
단일 사건 질문이 대부분이라면 기존 top-K 검색과 다단계 에이전트를 분리해 라우팅합니다. 모든 질문을 ReAct 경로로 보내면 간단한 검색까지 느려지고 더 많은 이미지가 노출됩니다. inter-event 조건이 실제로 포함된 질문에만 작업 메모리와 반복 검색을 쓰는 것이 비용과 권한을 함께 줄입니다.
삭제와 접근 철회도 사건 그래프 전체에 전파돼야 합니다. 사용자가 한 사진을 지웠는데 요약 메모나 연결된 사건 설명에 인물, 장소 정보가 남으면 원본 삭제의 의미가 약해집니다. 이미지 ID별로 파생 임베딩, 작업 메모, 장기 메모와 캐시를 추적하고 삭제 후 재검색에서 해당 정보가 나오지 않는지 시험해야 합니다. 검색 품질 평가와 별개로 최소 권한, 보존 기간, 감사 로그를 확인해야 개인 사진을 잇는 능력이 과도한 감시 기능으로 바뀌지 않습니다.
함께 읽으면 이해가 이어지는 글
- 긴 대화 RAG에서 관련 문서를 다시 골라야 할까? QRRanker의 4B 해법 — QRRanker가 4B 모델의 query-focused attention head로 후보 문서를 함께 재정렬하고 대화, 서사 메모리를 활용하는 방법과 적용 한계를 정리합니다.
- 멀티모달 에이전트가 같은 실수를 반복한다면? XSkill의 경험, 스킬 메모리 — 모델을 다시 학습하지 않고 실행 경험과 작업 스킬을 축적하는 XSkill의 두 메모리, 검색 방식, 성능 향상 조건과 오염 위험을 정리합니다.
- STEP3-VL-10B가 200B 모델보다 효율적일까: PaCoRe 성능과 추론 비용 점검 — STEP3-VL-10B의 fully unfrozen 1.2T-token pretraining과 1k+ RL, PaCoRe 병렬 추론이 작은 parameter 수를 실제 비용 절감으로 이어 주는지 벤치마크와 한계로 살펴봅니다.
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.