ZwZ는 테스트 때 이미지를 다시 자르고 인코딩하지 않아도 작은 영역을 더 잘 찾게 만들지만, 입력 단계에서 이미 사라진 픽셀 정보를 되살리는 기술은 아닙니다. 확대 도구의 비용을 학습 시점의 Region-to-Image Distillation로 옮긴 것이므로, single-pass 속도와 미세 정보의 물리적 한계를 함께 봐야 합니다.
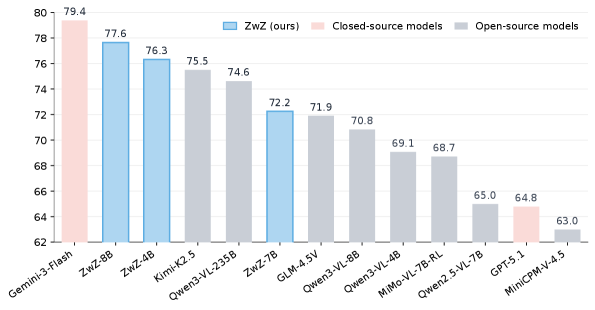 ZwZ 4B, 7B, 8B와 여러 대형 MLLM의 평균 인지 성능 비교.
ZwZ는 테스트 때 이미지를 다시 자르고 인코딩하지 않아도 작은 영역을 더 잘 찾게 만들지만, 입력 단계에서 이미 사라진 픽셀 정보를 되살리는 기술은 아닙니다. 확대 도구의 비용을 학습 시점의 Region-to-Image Distillation로 옮긴 것이므로, single-pass 속도와 미세 정보의 물리적 한계를 함께 봐야 합니다.
ZwZ 4B, 7B, 8B와 여러 대형 MLLM의 평균 인지 성능 비교.
작은 글자나 멀리 있는 부품이 답의 결정적 단서일 때, 전체 이미지를 한 번 보는 MLLM은 해당 영역을 놓칠 수 있습니다. Thinking-with-Images 방식은 의심 영역을 고르고 crop한 뒤 다시 시각 인코더에 넣습니다. 필요하면 이 과정을 반복합니다.
정확도에는 도움이 되지만 질문 하나에 여러 번의 vision forward, crop tool 호출, 재인코딩이 필요합니다. 또한 첫 crop 위치가 틀리면 이후 추론은 중요한 증거를 보지 못합니다. ZwZ의 목표는 이 탐색을 inference loop에서 제거하는 것입니다.
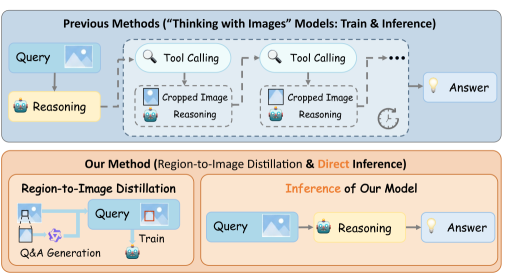 테스트 시 반복 crop 방식과 학습 시에만 zoom을 쓰는 ZwZ의 차이.
Single-pass는 “모델을 한 번 호출한다”는 뜻입니다. 모델 크기, 입력 해상도와 시각 토큰 수가 같다는 뜻은 아니므로 실제 지연 시간은 같은 하드웨어에서 별도로 측정해야 합니다.
Region-to-Image Distillation은 다음 순서로 데이터를 만듭니다.
학생에게는 crop 자체를 주지 않습니다. 전체 이미지와 좌표가 포함된 prompt 또는 box-overlay를 보여주고, teacher가 crop에서 만든 답을 목표로 학습시킵니다.
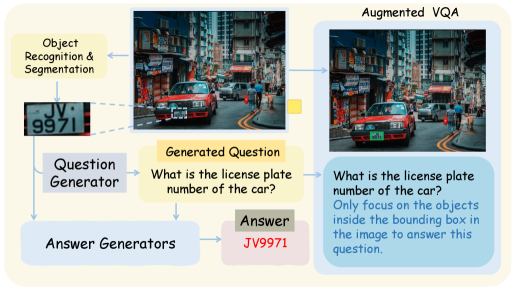 Micro-crop VQA를 전체 이미지와 box grounding으로 증류하는 파이프라인.
이 구조가 가르치는 것은 “전체 장면에서 작은 증거가 어디 있고 어떤 답과 연결되는가”입니다. teacher 여러 명의 합의는 오답을 줄일 수 있지만, 같은 편향이나 같은 OCR 오류를 공유하면 잘못된 label도 합의를 통과합니다.
ZoomBench는 845개의 고난도 VQA를 attribute, counting, existence, position, text, comparison의 여섯 범주로 나눕니다. 이미지 해상도와 전체 대비 crop 영역 비율도 함께 봅니다.
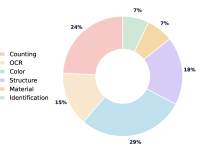 ZoomBench 범주와 해상도, crop-to-image 면적 비율 분포.
학습 백본은 InternVL2-4B, 8B와 Qwen2-VL-7B이며, 약 100k~200k의 증류 데이터를 LoRA 또는 full fine-tuning으로 학습했다고 설명합니다. MMBench, SEED-Bench, OCRBench, GUI 과제에서도 향상이 언급됩니다.
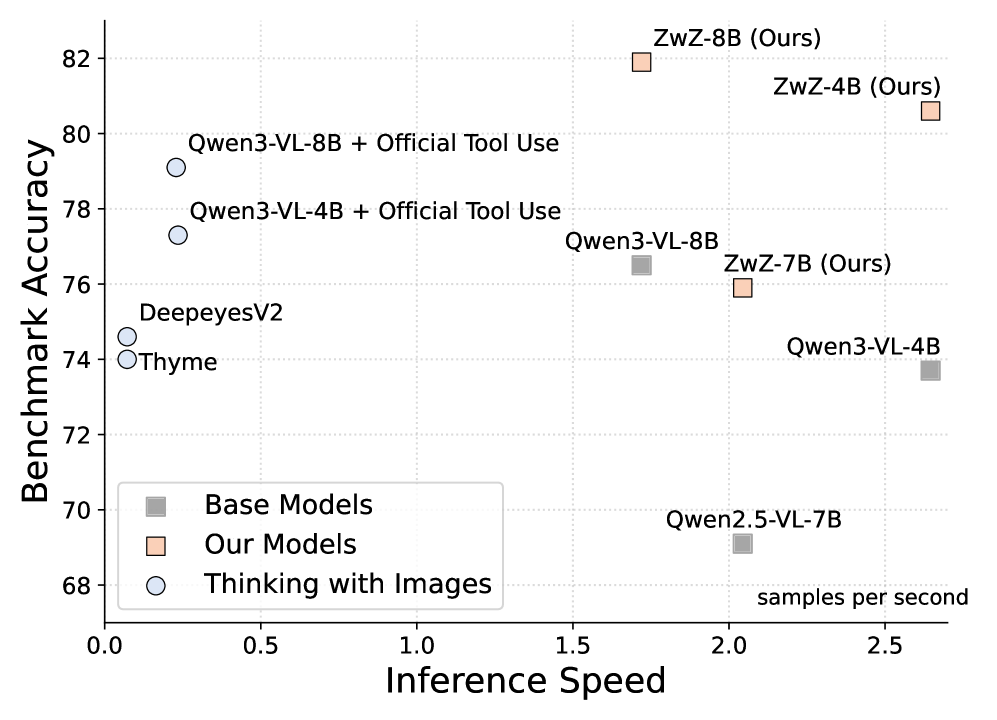 Single-pass ZwZ와 test-time crop 에이전트의 비교.
그림은 Gemini-3-Flash, Kimi-K2.5, Qwen3-VL-235B 등과 경쟁적인 평균을 제시하지만, 이 글에는 과제별 숫자와 호출 예산이 없습니다. “4B가 235B를 전반적으로 이겼다”가 아니라, 선택된 fine-grained perception 평가에서 작은 모델이 증류 이득을 얻었다고 읽는 편이 맞습니다.
학생이 보는 전체 이미지가 vision encoder에서 낮은 해상도로 줄어들면, 한두 픽셀짜리 글자나 결함은 표현에서 사라질 수 있습니다. 학습은 남아 있는 약한 신호에 주의를 주도록 만들 수 있지만 존재하지 않는 정보를 복원할 수는 없습니다. 이때 모델은 실제 판독이 아니라 주변 맥락으로 답을 추측할 위험이 있습니다.
다음 조건에서는 crop 도구와의 hybrid가 필요할 수 있습니다.
특히 의료와 자율주행에 바로 적용할 수 있다는 원문의 예시는 가능성이지 안전성 검증 결과가 아닙니다.
같은 이미지와 질문으로 single-pass ZwZ, 원본 백본, crop 에이전트를 비교하면서 정확도 외에 vision forward 수, P95 지연, GPU 메모리, teacher 데이터 구축 비용을 기록해야 합니다. 영역 크기별 정확도를 그리면 어느 지점에서 single-pass가 무너지는지도 볼 수 있습니다.
운영에서는 ZwZ가 높은 확신으로 답할 수 있는 사례는 한 번에 처리하고, 작은 증거가 실제 입력 표현에 남았는지 불확실한 사례만 확대 도구로 보내는 방식이 현실적입니다. 이 연구의 성과는 확대를 완전히 없앴다는 데 있지 않고, 반복 확대가 필요했던 많은 문제를 학습 데이터로 선결제해 한 번의 추론으로 옮겼다는 데 있습니다.
이때 라우팅 기준은 모델의 자신감만으로 정하지 않는 편이 좋습니다. 질문이 가리키는 영역의 크기, 입력 리사이즈 뒤 남는 픽셀 수, 텍스트, 미세 결함처럼 오류 비용이 큰 범주를 함께 사용해야 높은 확신의 추측을 확대 경로로 보낼 수 있습니다.
파일럿은 동일한 질문을 세 경로로 처리하면 됩니다. 원본 백본이 전체 이미지만 한 번 보고 답하는 경로, ZwZ가 한 번에 답하는 경로, 에이전트가 영역을 골라 crop한 뒤 다시 답하는 경로입니다. 각 경로에 같은 최종 답 채점기를 쓰고, 정확도와 함께 시각 인코더 호출 수, P50/P95 지연, 최대 메모리를 기록해야 “한 번 호출”의 운영상 가치가 드러납니다.
평가 세트는 작은 영역의 면적만 달라지고 나머지는 같은 문제 쌍을 포함하는 편이 좋습니다. 예를 들어 같은 표지판 글자를 원본 크기, 절반 크기, 더 작은 크기로 배치하면 어느 축소 지점부터 single-pass가 맥락으로 추측하기 시작하는지 볼 수 있습니다. 글자 대신 작은 부품의 존재, 개수, 상대 위치도 같은 방식으로 바꾸면 OCR만 잘하는지 여섯 능력 전반이 좋아졌는지 구분할 수 있습니다.
라우터는 “확신이 낮으면 확대” 한 조건으로 끝내면 안 됩니다. 모델은 보이지 않는 작은 글자를 주변 문맥으로 맞히면서 높은 확신을 낼 수 있습니다. 질문이 text, counting, comparison 중 어느 범주인지, 관심 영역이 리사이즈 뒤 몇 픽셀로 남는지, 오답 비용이 큰 업무인지와 확신을 결합해야 합니다. 확대 경로가 정답을 바꾸었을 때에는 처음 답이 틀렸는지와 crop 위치가 맞았는지를 따로 남겨 라우터와 crop 도구를 분리해 고칠 수 있습니다.
증류 데이터의 오류도 운영 실패로 이어질 수 있습니다. 여러 teacher가 합의했더라도 모두 같은 잘못된 글자를 읽었거나 box-overlay가 답 영역을 부정확하게 가리킬 수 있습니다. 사람이 검수한 작은 고정 세트를 따로 두고, 새 카메라, 압축 방식, 업무 도메인마다 이 세트의 성능이 유지되는지 확인해야 합니다. single-pass의 오류가 특정 영역 크기 아래에서 급격히 늘면 그 지점을 확대 도구로 넘기는 명시적 경계로 삼을 수 있습니다.
결국 선택은 확대 기능을 없앨지의 양자택일이 아닙니다. 반복 crop 비용이 큰 일반 사례는 ZwZ로 처리하고, 입력 표현에 정보가 남지 않는 사례만 도구 호출로 보내는 계층형 구조가 가능합니다. 두 경로를 운영할 때는 정확도 향상보다 라우팅 오류가 만드는 위험을 먼저 정하고, 확대가 실패하면 답을 보류할 수 있어야 합니다.
운영 후에는 확대 경로로 보냈어야 했던 single-pass 오답을 따로 모아야 합니다. 작은 글자, 미세 결함, 멀리 있는 객체처럼 반복되는 유형이 보이면 라우팅 규칙과 증류 데이터를 함께 보강할 수 있습니다. 반대로 확대가 답을 바꾸지 않는데 지연만 늘린 사례가 많다면 해당 범주는 single-pass로 되돌립니다. 두 경로의 비율과 오류 비용을 주기적으로 비교해야 입력 분포가 달라져도 한 번 정한 경계가 고정된 채 낡지 않습니다.
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.