Teacher model의 CoT를 볼 수 없어도 성공한 tool call과 argument, 미래 trajectory처럼 training 때만 얻는 privileged information을 hint로 주면 student agent를 학습할 수 있습니다. π-Distill은 설명 문장을 그대로 모방하는 대신 PI가 있는 policy와 없는 policy를 같은 parameter 안에서 맞춥니다.
Teacher의 CoT를 못 봐도 Agent를 학습할 수 있을까? π-Distill의 PI
Privileged Information은 Training 뒤 사라지는 Hint다
Frontier model API가 final action만 제공하고 내부 reasoning을 숨기면 일반적인 CoT SFT를 만들기 어렵습니다. Behavior cloning으로 action만 복사하면 왜 그 tool을 골랐는지와 long-horizon plan을 배우는 신호가 부족하고, reward만 쓰는 RL은 exploration space가 큽니다.
PI는 training에는 있지만 inference에는 없는 정보입니다. 성공 trajectory, environment hidden state, teacher의 tool-call record가 예입니다. π-Distill 실험은 세 수준을 다룹니다.
- tool call과 argument를 모두 제공
- 어떤 tool을 썼는지만 제공
- student가 성공 trajectory에서 스스로 만든 hint 제공
PI가 완전한 reasoning일 필요는 없습니다. 다음 탐색 방향을 좁힐 만큼의 구조가 student에게 도움이 되는지 보는 접근입니다.
Teacher와 Student가 같은 Parameter를 공유한다
π-Distill에서 teacher policy는 현재 state와 PI를 모두 받고, student policy는 state만 받습니다. 두 policy는 별도 거대 model이 아니라 같은 model parameter를 공유하며 cross-entropy와 distribution alignment를 함께 학습합니다.
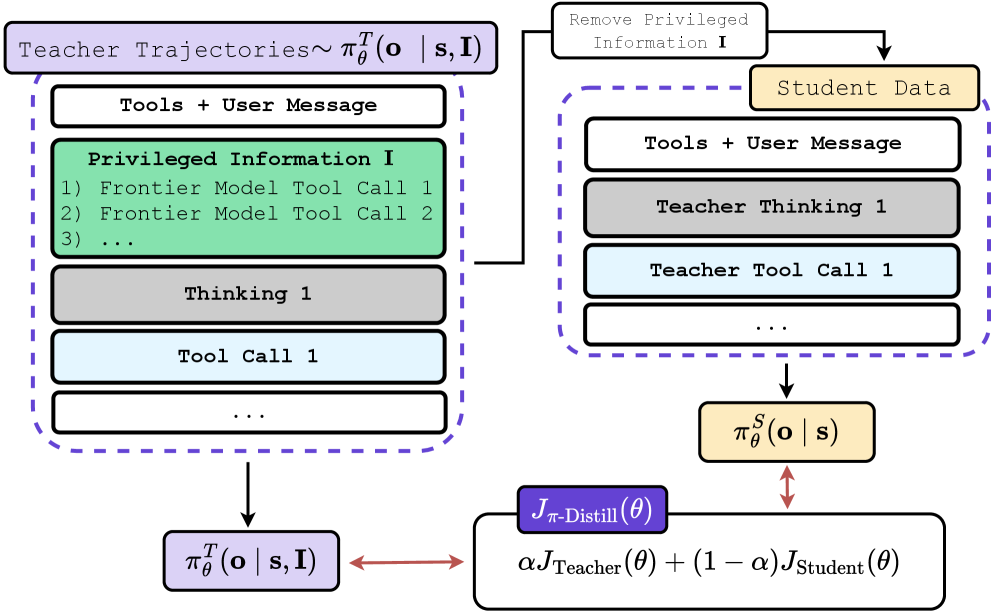
PI-conditioned teacher는 성공 action을 쉽게 찾고, student는 PI 없이 비슷한 output distribution을 내도록 배웁니다. 이 구조는 inference 때 privileged data가 없어도 되게 하지만 joint batch와 KL weight 조정이 복잡합니다. Teacher와 student 조건이 너무 다르면 같은 weight 안에서 task가 충돌할 수도 있습니다.
OPSD는 움직이는 PI Teacher를 RL 기준으로 쓴다
On-Policy Self-Distillation(OPSD)은 RL 중 student가 PI-conditioned teacher에서 지나치게 멀어지지 않게 reverse-KL 기준을 둡니다. 고정 pretrained reference보다 현재 학습 중인 teacher를 reference로 삼아 reward hacking을 줄이고 성공 trajectory 방향을 유지하려는 방식입니다.
TravelPlanner, τ-Bench의 retail, airline task, Qwen3-8B와 Llama-3-8B가 평가에 쓰였습니다. Teacher data는 GPT-4o 계열의 성공 trajectory이며 CoT는 포함하지 않습니다. 원문은 TravelPlanner에서 기본 RL 대비 약 두 배 개선하고 CoT SFT+RL보다도 높은 결과를 보고합니다. GEM의 out-of-domain 평가에서도 forgetting이 덜했다고 설명합니다.
이 숫자는 해당 tool environment와 success trace 조건에 묶여 있습니다. Closed frontier model과 동급의 일반 능력을 작은 model에 복제했다는 뜻은 아닙니다.
성공 Trace가 없으면 PI도 만들 수 없다
어려운 task에서 teacher조차 거의 성공하지 못하면 privileged trajectory가 부족합니다. Tool log에 secret이나 민감한 argument가 포함될 가능성도 있으므로 training data로 쓰기 전 정제해야 합니다. CoT를 출력하지 않는다는 이유만으로 student가 해석 가능하거나 안전해지는 것도 아닙니다.
실무 검증에서는 PI 유형별 성공률, PI를 제거한 inference 성능, unseen tool과 domain에서의 generalization, 잘못된 PI에 대한 민감도를 비교합니다. Joint training memory와 rollout 비용도 SFT baseline에 포함해 계산해야 합니다. π-Distill의 핵심은 frontier model의 지능을 “훔친다”는 표현이 아니라 추론 설명 대신 성공 행동의 구조를 training-only condition으로 사용해 exploration을 좁히는 것입니다.
세 종류 PI가 주는 Hint는 어떻게 다른가
Tool과 argument를 모두 주면 다음 action을 거의 직접 알려 주지만 inference 조건과의 차이가 큽니다. Tool 이름만 주면 탐색 공간은 줄이면서 argument reasoning은 student가 배워야 합니다. Student가 성공 trajectory에서 스스로 만든 hint는 외부 teacher 의존은 낮지만 초기 policy가 약하면 품질도 낮을 수 있습니다.
| PI 수준 | 학습 신호 | 대표 위험 |
|---|---|---|
| Tool + argument | 가장 구체적인 action target | 특정 값 암기, secret leakage |
| Tool only | action family 선택 | 잘못된 argument 생성 |
| Self-generated hint | 현재 student와 조건이 가까움 | 초기 오류를 자기 증폭 |
| PI 없음 | deployment와 동일 조건 | exploration 난도 증가 |
같은 trajectory에서 PI 수준만 바꾼 ablation을 해야 개선이 teacher model 크기인지 구체적인 action hint인지 구분할 수 있습니다. PI가 있는 teacher policy의 success와 PI가 없는 student success 차이도 공개해야 distillation gap을 알 수 있습니다.
Shared Parameter가 두 조건을 모두 견디는가
Teacher policy와 student policy가 같은 weight를 쓰면 별도 model을 유지하지 않는 장점이 있지만 input condition은 다릅니다. PI token에 지나치게 의존하면 teacher batch에서는 잘하고 student batch에서는 action을 못 고를 수 있습니다. 반대로 alignment weight가 너무 강하면 teacher의 유용한 hint까지 무시할 수 있습니다.
Training 중에는 PI-present, PI-absent batch의 loss와 success를 따로 기록합니다. PI를 random하게 가리거나 일부 argument를 제거해 graceful degradation을 보는 것도 유용합니다. Inference에서는 PI field가 완전히 존재하지 않는 실제 prompt로만 평가해 accidental leakage를 막습니다.
OPSD의 reverse-KL reference도 고정 model이 아니라 함께 움직이는 PI-conditioned policy이므로 두 policy가 동시에 잘못된 shortcut으로 갈 가능성이 있습니다. Reward score뿐 아니라 invalid tool call, 반복 action, policy가 성공 trace를 표면적으로 복사하는지 audit합니다.
잘못된 PI를 주면 Student는 어떻게 반응해야 하나
모든 성공 log가 정확한 것은 아닙니다. Tool은 맞지만 argument가 오래됐거나, environment가 달라 같은 action이 실패할 수 있습니다. Training에 contradictory PI, missing step과 out-of-order trajectory를 일부 넣어 student가 state evidence와 충돌할 때 무조건 따라가는지 확인합니다.
예를 들어 travel task에서 성공 당시의 availability identifier를 새 state에 그대로 넣으면 invalid action입니다. PI-conditioned teacher가 이를 복사하지 않고 현재 observation을 확인해야 합니다. Student도 특정 argument pattern을 외워 unseen inventory에서 hallucinate하지 않는지 봅니다.
평가 지표는 final success 외에 tool selection accuracy, argument validity, unnecessary call, recovery after tool error와 PI corruption sensitivity를 포함합니다. Wrong PI에서 성능이 급락하면 data filtering과 condition dropout을 우선 검토해야 합니다.
Privacy와 총비용은 어디에서 생기나
CoT가 없다고 privacy 문제가 사라지는 것은 아닙니다. Tool log에는 customer identifier, address, payment 상태나 credential-like token이 들어갈 수 있습니다. Training 전 schema별 allowlist와 redaction을 적용하고 raw trace 접근, retention을 제한합니다. Argument를 학습 target으로 쓰지 않아도 prompt context에 남으면 model이 memorization할 수 있습니다.
비용에는 frontier teacher의 성공 trajectory 생성, 실패 rollout 폐기, joint PI/no-PI batch와 RL sampling이 포함됩니다. Basic SFT, reward-only RL, π-Distill을 같은 total rollout, GPU budget으로 비교해야 “작은 student inference”와 “비싼 training”을 함께 판단할 수 있습니다.
도입 조건은 PI 없는 student가 unseen state에서도 baseline보다 성공하고, wrong PI, tool failure에서 회복하며, trace 정제와 training 비용이 운영 절감보다 작은 경우입니다. 성공 log를 갖고 있다는 사실만으로 이 조건들이 자동 충족되지는 않습니다.
함께 읽으면 이해가 이어지는 글
- Soft Teacher는 라벨 1%에서 왜 강했나: Pseudo Label 신뢰도 설계 — Soft Teacher의 Teacher-Student 반복, confidence 기반 pseudo label 필터링, soft labeling과 box jittering이 라벨 부족 문제를 다루는 방식을 설명합니다.
- 카메라 없이 WiFi CSI로 자세를 읽을 수 있나: WiFi-DensePose의 조건 — WiFi 신호의 진폭, 위상 변화로 신체 영역과 UV 좌표를 예측하는 teacher–student 구조, 하드웨어 배치, 노이즈, 프라이버시 한계를 짚습니다.
- 이미지를 다시 자르지 않고 작은 글씨를 읽을까: ZwZ Single-pass와 Zooming Gap — 크롭을 본 교사의 답을 전체 이미지 학생에게 증류하는 ZwZ가 줄이는 추론 비용과 복구하지 못하는 정보 손실을 구분합니다.
자주 묻는 질문
π-Distill은 frontier model의 숨은 CoT를 복원하나요?
아닙니다. 내부 reasoning text 대신 외부에서 관측 가능한 성공 tool call, argument, trajectory를 privileged information으로 사용해 student의 action exploration을 좁힙니다.
Inference 때 PI가 없어도 같은 성능이 나오나요?
그것이 목표지만 teacher와 student 조건 차이가 크면 성능이 떨어질 수 있으므로 PI를 완전히 제거한 evaluation과 unseen tool, domain test가 필요합니다.
성공 trajectory는 그대로 training data로 써도 되나요?
아닙니다. Tool argument에 secret, 개인정보, 일회성 identifier가 포함될 수 있고 우연한 성공도 있어 redaction, validity check와 data provenance를 확인해야 합니다.
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.