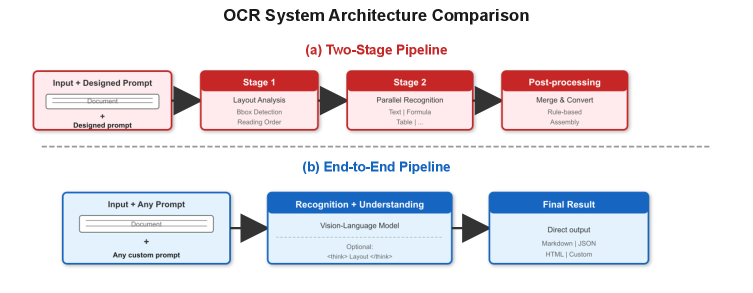
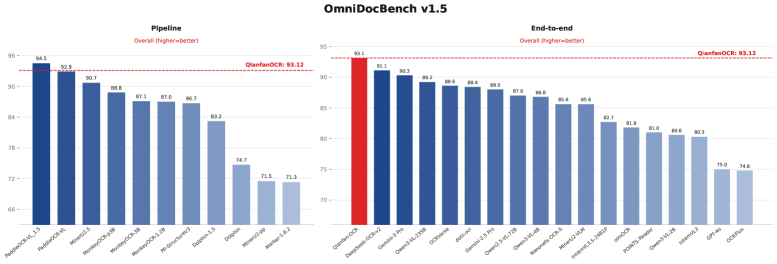
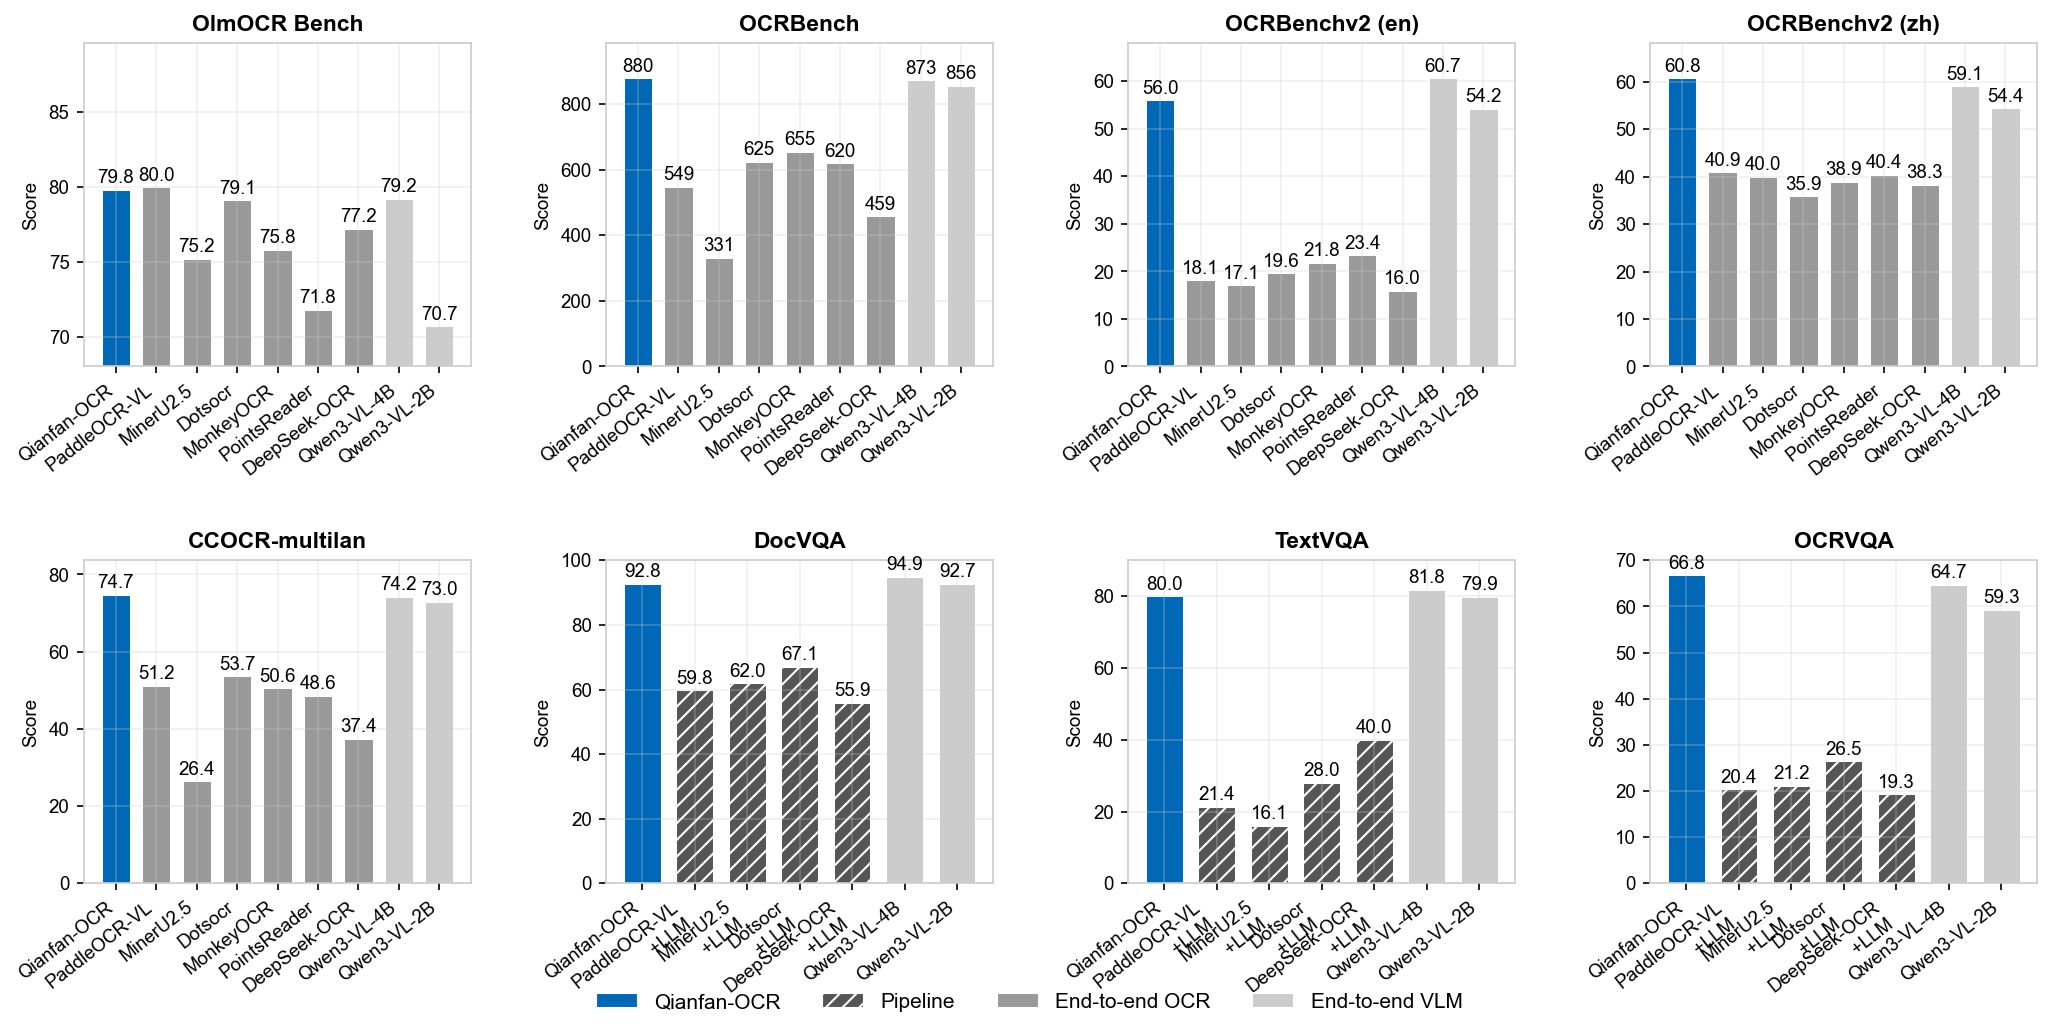
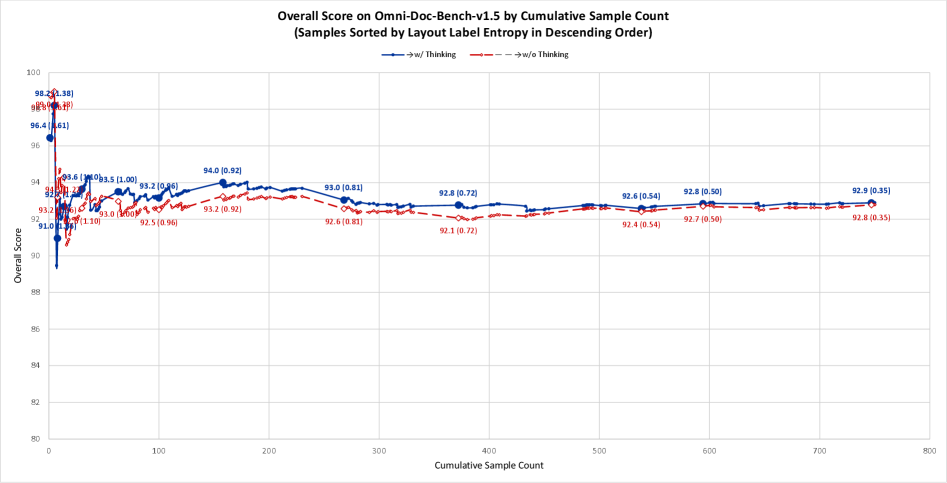
표, 차트, 여러 단이 섞인 문서는 글자 인식만으로 부족하며, Qianfan-OCR처럼 읽기 순서와 영역을 먼저 계획하는 접근이 더 적합합니다. 다만 4B 단일 모델의 출력도 숫자와 표 구조를 완전히 보증하지 않으므로 원문 대조가 필요합니다.
Qianfan-OCR 논문 자료는 OCR, 레이아웃 분석, 표 복원을 여러 모델로 이어 붙이는 대신 이미지에서 Markdown까지 한 모델로 처리하는 방식을 제안합니다. 모델 규모는 4B이며 문서 변환뿐 아니라 표, 차트 이해와 문서 질의응답을 함께 다룹니다.