포스트

비디오를 16 FPS로 바로 이어 만들 수 있을까? ShotStream의 캐시 조건

ShotStream은 논문 조건의 단일 GPU에서 16 FPS 멀티샷 생성을 보고하지만, 무한 스트리밍까지 메모리와 정체성이 유지된다는 뜻은 아닙니다. 빠른 인과적 생성은 교사 모델의 증류와 글로벌, 로컬 캐시 관리가 함께 있을 때 나온 결과입니다.

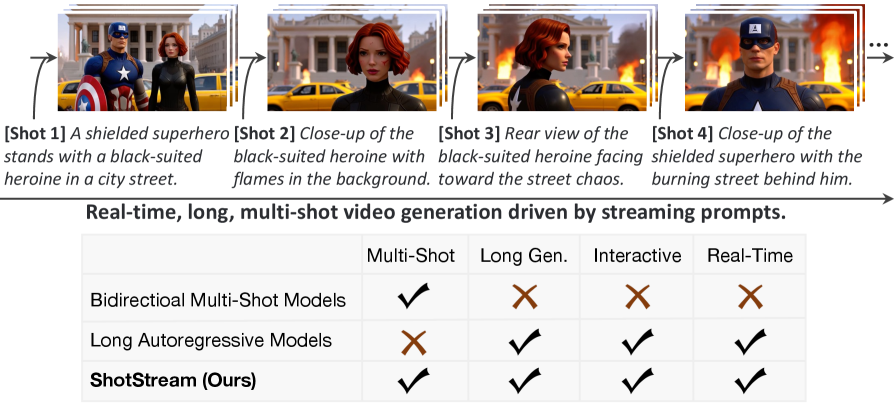
논문 자료가 겨냥하는 문제는 사용자가 다음 장면을 바꾸고 싶어도 전체 클립이 끝날 때까지 기다려야 하는 양방향 비디오 생성입니다. ShotStream은 이전 프레임만 보고 다음 프레임을 만드는 causal student로 바꿔 첫 장면부터 순서대로 내보냅니다.

프롬프트를 받으며 다음 샷을 스트리밍하는 흐름

느린 교사를 먼저 만든 뒤 인과적 학생에게 옮긴다

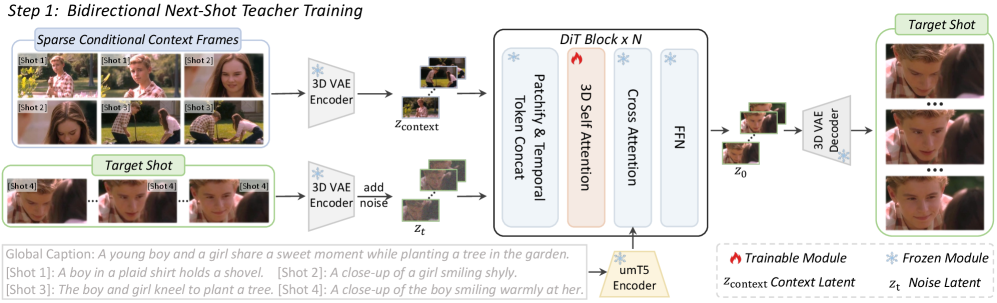
기존 텍스트-비디오 모델을 bidirectional next-shot teacher로 조정해 컨텍스트와 다음 샷의 관계를 학습합니다. 교사는 미래 정보를 함께 보므로 품질은 좋지만 스트리밍에는 맞지 않습니다. 이후 DMD(Distribution Matching Distillation)로 교사의 분포를 causal student에 전달합니다.

양방향 next-shot 교사 학습 단계

원문 의사 코드는 이 모델을 실제로 실행하는 구현이 아니라 듀얼 캐시 어텐션을 설명하는 목업입니다. 모델 가중치, 학습 데이터와 DMD 손실이 빠져 있으므로 몇 줄의 PyTorch로 16 FPS를 재현할 수 있다는 뜻이 아닙니다.

글로벌 캐시와 로컬 캐시가 다른 시간 범위를 맡는다

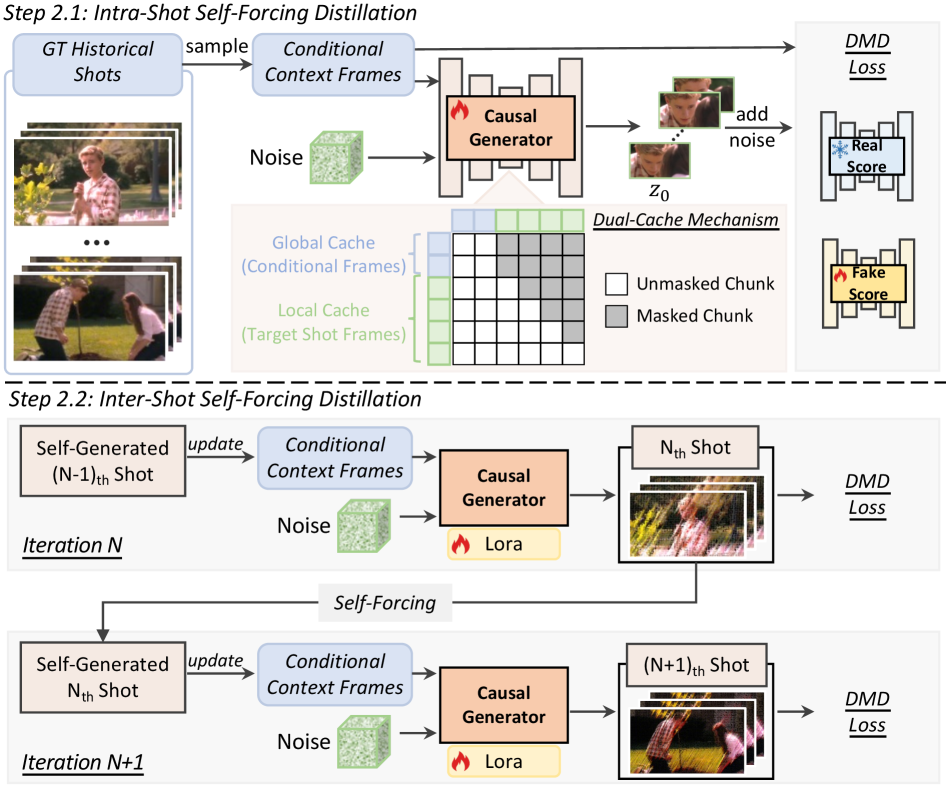
global cache는 이전 샷의 핵심 조건을 보존해 인물과 배경의 정체성을 잇고, local cache는 현재 샷의 최근 프레임을 담아 짧은 움직임을 매끄럽게 합니다. RoPE discontinuity indicator는 두 캐시의 위치 체계가 섞여 과거와 현재를 잘못 연결하는 문제를 줄입니다.

두 캐시와 2단계 증류를 결합한 구조

학습도 두 단계입니다. 먼저 정답 과거를 주어 샷 내부 생성을 익히고, 다음에는 학생이 직접 만든 불완전한 과거를 조건으로 다음 샷을 만들게 합니다. 실제 추론에서 자기 오류를 다시 입력으로 받는 train-test gap을 줄이려는 설계입니다.

16 FPS는 하드웨어와 품질 조건을 붙여 읽는다

논문 비교는 단일 GPU에서 16 FPS와 1초 미만 반응을 제시합니다. 이는 해상도, 프레임 묶음, 샘플링 스텝과 사용한 GPU가 정해진 평가값입니다. 웹 서비스의 전송, 인코딩 지연이나 여러 사용자의 동시 요청까지 포함한 처리량은 아닙니다.

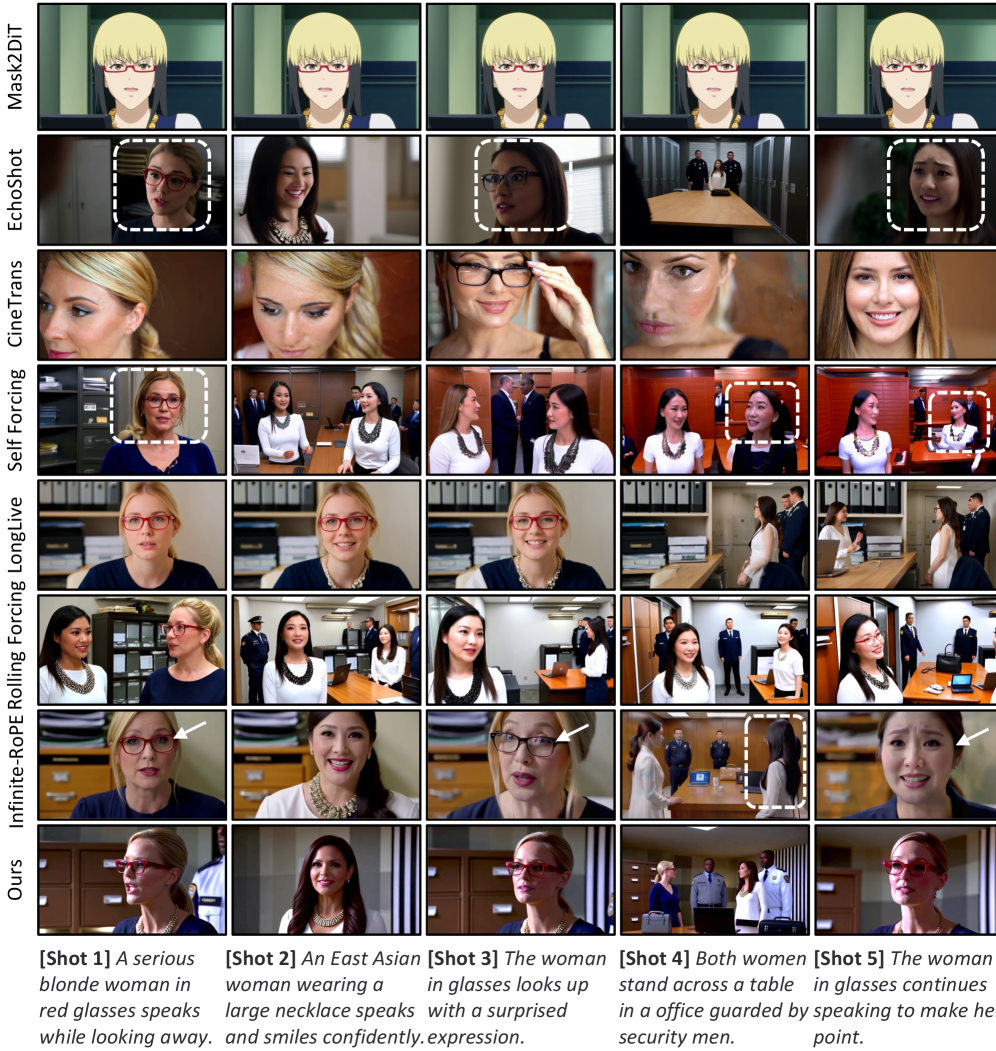
다른 생성 방식과 속도, 일관성 비교

실제 PoC에서는 time-to-first-frame, 지속 FPS, VRAM, 프롬프트 변경 반영 시간, 샷이 늘어날 때 인물 외형의 드리프트를 함께 재야 합니다. 16 FPS가 재생 가능한 속도라는 것과 사용자가 원하는 품질의 최종 영상이라는 것도 구분해야 합니다.

장기 스트리밍에는 캐시 퇴출 규칙이 필요하다

샷이 계속 늘면 global cache도 커집니다. 오래된 키와 값을 언제 버릴지, 어떤 기준 프레임을 남길지 정하지 않으면 결국 OOM이나 장기 맥락 손실이 생깁니다. 지나치게 많이 버리면 초반 인물과 배경이 바뀌고, 많이 남기면 속도 이점이 줄어듭니다.

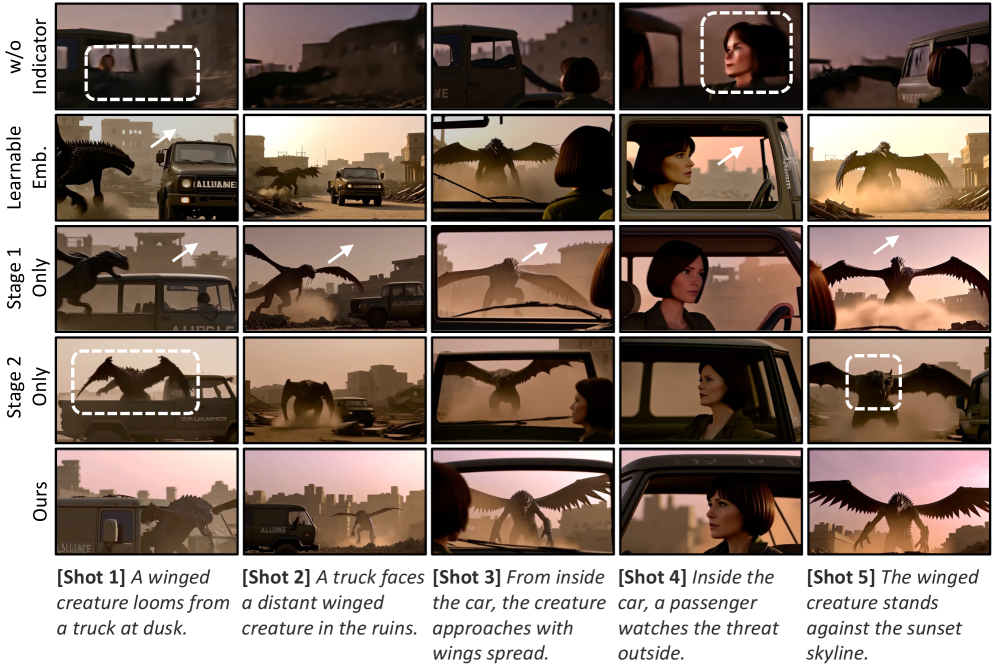
causal student 구성 요소별 결과

ShotStream은 짧은 인터랙티브 이야기와 캠페인처럼 생성 길이가 통제되는 경우에 먼저 시험할 만합니다. 교사 학습과 2단계 증류 비용, 캐시 상한, 부적절한 장면 생성의 중단 장치까지 준비해야 합니다. 배치 비디오를 스트림으로 바꾸는 설계는 의미 있지만, 24시간 이어지는 일관된 세계를 완성했다는 해석은 피해야 합니다.

사용자의 새 지시는 어느 경계에서 반영되나

스트리밍 서비스에서 중요한 것은 평균 FPS뿐 아니라 프롬프트를 바꾼 뒤 몇 프레임 만에 변화가 보이는지입니다. 이미 생성 큐에 들어간 프레임, local cache에 남은 움직임과 global cache의 인물 조건이 새 지시와 충돌할 수 있습니다. 즉시 장면을 바꾸면 전환이 끊기고, 기존 상태를 오래 유지하면 상호작용이 늦어집니다.

PoC에서는 인물 유지, 배경 교체, 카메라 이동, 새로운 객체 추가처럼 변화 유형을 나눠 반영 지연을 측정해야 합니다. “빨간 우산을 추가하라”는 지시 뒤 우산이 처음 등장하는 프레임, 장면이 안정되는 프레임, 기존 인물 외형이 훼손되는지를 함께 기록합니다. 텍스트 입력 시각과 인코딩, 전송 시간을 포함해야 실제 사용자 체감과 맞습니다.

두 캐시는 어떤 지표로 튜닝해야 하나

global cache는 장기 정체성을, local cache는 단기 움직임을 주로 담당하므로 하나의 품질 점수로 크기를 정하기 어렵습니다. global 크기를 줄이면서 초반 인물과 배경의 유사도가 언제 떨어지는지 보고, local 길이를 줄이면서 optical flow의 단절과 깜박임이 언제 늘어나는지 봅니다. 두 캐시를 동시에 크게 하면 품질은 오를 수 있지만 지연과 VRAM도 함께 커집니다.

장면별로 캐시를 무조건 초기화하는 것도 정답은 아닙니다. 등장인물이 이어지는 shot에는 정체성 앵커가 필요하고, 완전히 다른 장소로 넘어갈 때는 옛 배경을 버려야 합니다. shot boundary 검출이 틀렸을 때의 결과를 따로 시험하고, 사용자가 명시적으로 “새 장면” 또는 “이 인물 유지”를 지정할 수 있는 제어 경로를 두는 편이 안전합니다.

품질 평가는 어떤 시간축으로 나눠야 하나

첫 2초만 본 평가에서는 누적 오류가 드러나지 않습니다. 5초, 30초, 60초와 목표 최대 길이에서 인물 정체성, 배경 일관성, 움직임 자연스러움, 지시 반영을 반복 측정해야 합니다. 프레임마다 품질을 평균내면 후반 붕괴가 희석되므로 시간대별 최저점과 드리프트 기울기도 남깁니다.

사람 평가에는 같은 seed와 prompt로 만든 배치 방식 기준선을 섞어 보여 줍니다. 스트리밍이라는 사실을 숨긴 채 자연스러움과 이야기 연결성을 비교해야 속도 기대가 품질 판단에 영향을 덜 줍니다. 자동 지표는 빠르지만 작은 손가락, 텍스트, 객체 수 같은 오류를 놓칠 수 있어 실패 유형별 표본 검토가 필요합니다.

제품 아키텍처에는 모델 밖의 지연도 포함된다

생성된 latent를 디코딩하고 영상으로 인코딩해 네트워크로 보내는 동안에도 버퍼가 생깁니다. 모델이 16 FPS를 만들어도 인코더가 느리거나 클라이언트가 불안정하면 재생이 끊길 수 있습니다. 추론 FPS, time-to-first-frame, end-to-end FPS, 재생 buffer 길이를 분리해 관측해야 병목을 찾을 수 있습니다.

동시 사용자가 늘면 한 세션의 두 캐시가 사용자 수만큼 복제됩니다. admission control과 세션별 VRAM 상한이 없으면 소수의 긴 세션이 전체 서비스를 막을 수 있습니다. 사용자가 창을 닫거나 연결이 끊겼을 때 캐시를 즉시 해제하고, 복구 가능한 세션만 제한된 시간 보관하는 정책이 필요합니다.

실패를 어떻게 멈추고 되돌릴까

생성 중 얼굴이 바뀌거나 금지 콘텐츠가 나타났을 때 이미 전송한 프레임은 회수하기 어렵습니다. 프레임 단위 안전 필터와 지연 버퍼를 두면 검토할 시간은 생기지만 실시간성이 낮아집니다. 위험 수준에 따라 완전 실시간, 몇 초 지연 검수, 사후 렌더링 모드를 구분하는 것이 현실적입니다.

모델이 불안정해지면 마지막 정상 keyframe과 승인된 prompt로 짧은 세션을 다시 시작할 수 있어야 합니다. 무한 재시도보다 최대 shot 수와 최대 생성 시간을 두고, 실패 이유와 seed, 모델 버전, 캐시 설정을 저장해야 같은 문제를 재현할 수 있습니다.

사용자 입력 자체의 version도 남겨야 합니다. 생성 도중 prompt를 여러 번 고치면 어느 지시가 어느 frame 범위에 적용됐는지 모호해집니다. 각 변경에 sequence 번호와 적용 목표 시점을 붙이고, 늦게 도착한 입력은 폐기하거나 다음 shot부터 반영합니다. 이 기록이 있어야 품질 문제를 모델 오류와 network 순서 뒤바뀜으로 나눠 재현할 수 있습니다.

오디오가 포함되는 제품이라면 영상 frame과 음성, 효과음의 timestamp도 같은 기준 시계로 관리해야 합니다. 영상만 빠르게 이어져도 입 모양과 소리가 밀리면 상호작용 품질은 무너집니다.
함께 읽으면 이해가 이어지는 글

자주 묻는 질문

16 FPS면 바로 실시간 서비스가 가능한가요?

아닙니다. 논문의 모델 추론 조건과 실제 디코딩, 인코딩, 전송, 동시 접속 비용은 다릅니다. 사용자 장치까지 포함한 첫 프레임 시간과 지속 FPS를 측정해야 합니다.

global cache를 계속 유지하면 인물이 영원히 같아지나요?

캐시는 과거 단서를 남기지만 생성 오류와 압축 손실을 없애지 않습니다. 길이가 늘수록 퇴출 규칙과 정체성 검증이 필요하며, 화면 밖의 사건까지 정확히 기억하는 것도 아닙니다.

배치 비디오 생성보다 언제 유리한가요?

사용자가 생성 도중 다음 장면을 바꾸고 빠르게 미리 봐야 할 때 유리합니다. 한 번에 최고 품질의 완성본만 필요하다면 배치 방식의 재샘플링과 후편집이 더 단순할 수 있습니다.

THE END / OPSOAI

여기까지 읽었습니다

핵심 장면을 한 번 더 떠올려 보세요. 이해가 남았다면 이 책은 제 역할을 다했습니다.

다른 책 고르기
표지 1 —

←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.

CONTENTS

이 책의 목차

    11개 장 16 분읽는 시간