1분짜리 AI video의 character drift는 Student가 긴 history를 다루는데 Teacher는 최근 5초만 본다면, 장기 일관성 오류를 Teacher 자체가 알아차릴 수 없어서 고치기 어렵습니다. Context Forcing은 teacher와 student가 같은 long-context memory를 보게 만들어 이 supervision mismatch를 줄입니다.
1분 AI 영상의 Character Drift, Teacher도 5초만 보면 왜 못 고칠까?
짧은 Teacher는 긴 Student를 제대로 채점할 수 없다
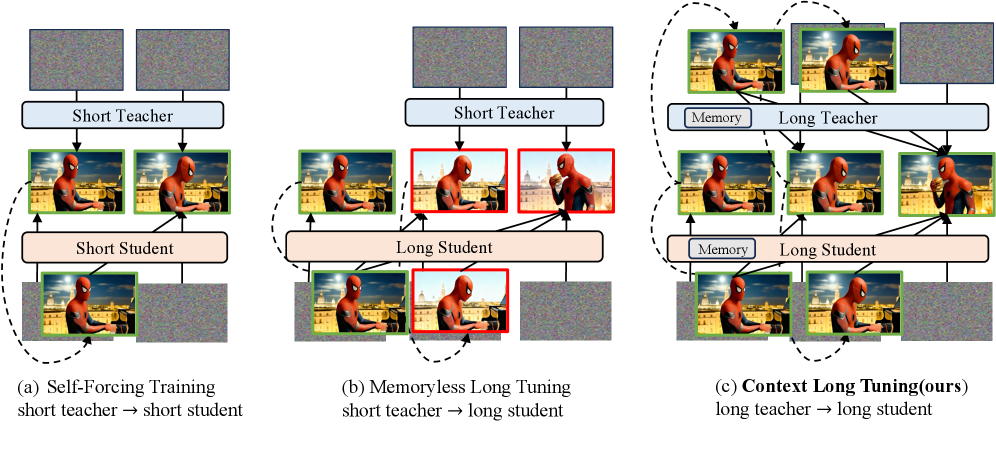
Autoregressive video diffusion은 긴 영상을 chunk로 이어 생성합니다. 최근 frame만 보면 local motion은 자연스럽게 만들 수 있지만 오래전의 character, costume, background가 점차 달라집니다. LongLive 계열 설명에서는 student가 긴 rollout을 만들면서도 memoryless teacher가 임의의 5초 chunk만 지도합니다.
Teacher가 초기 scene을 기억하지 못하면 student의 identity drift를 정상으로 판단할 수 있습니다. Context Forcing은 long-context teacher를 두어 전체 생성 history를 조건으로 다음 chunk를 평가합니다. Contextual Distribution Matching Distillation(DMD)에서 teacher와 student가 동일한 context memory mechanism을 사용한다는 점이 핵심입니다.
Sink, Slow, Fast Memory가 KV Cache를 나눈다
모든 frame의 KV cache를 그대로 보존하면 memory가 감당하기 어렵습니다. Context management는 세 영역으로 history를 나눕니다.
- sink: 첫 frame을 남겨 character와 scene의 초기 anchor를 유지
- slow memory: 먼 과거를 낮은 빈도로 sampling하거나 압축
- fast memory: 최근 frame을 자세히 보존해 local motion을 연결
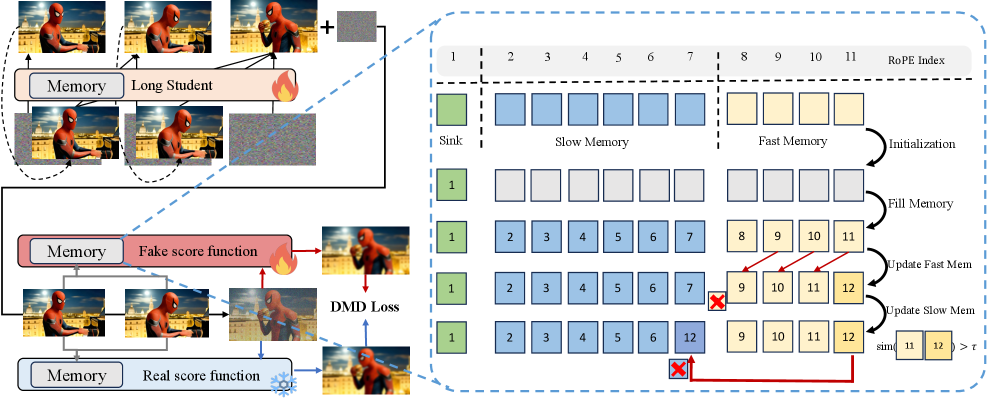
이 구조는 가까운 변화와 오래된 identity에 서로 다른 해상도를 배정합니다. 그러나 slow memory로 내려간 작은 accessory나 texture는 사라질 수 있습니다. 어떤 정보를 slow로 보낼지 잘못 고르면 전체 배경은 비슷해도 세부 특징은 drift합니다.
1분 생성과 20초 ECL을 같은 말로 읽지 않는다
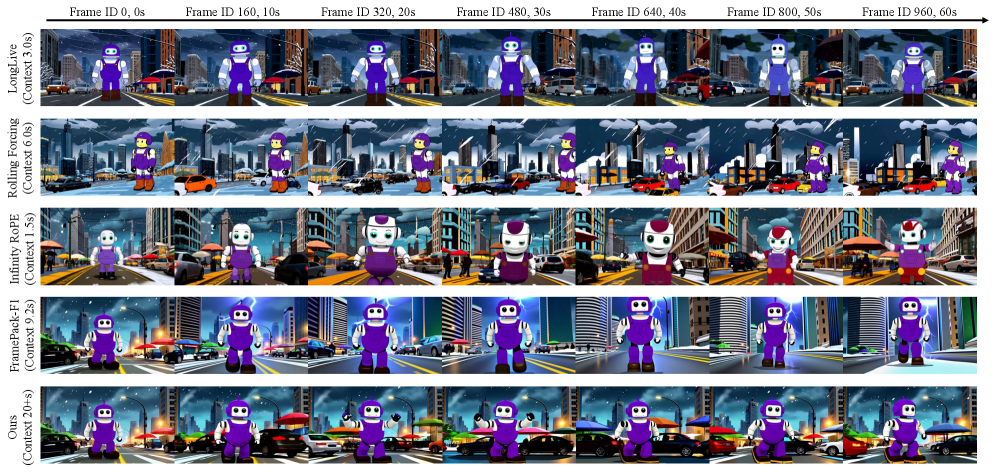
원문은 LWM과 Open-Sora Plan 계열 baseline, 대규모 video-text data, 다수 H100 환경을 설명합니다. Contextual DMD로 AR inference를 빠르게 하고 minute-level video를 생성합니다. Effective Context Length(ECL)은 model이 실제로 얼마나 먼 정보를 유의미하게 참조하는지 재는 지표입니다.
보고된 ECL은 20초 이상이며 기존 방식의 2~5초와 비교됩니다. 1분 이상 output이 가능하다는 사실과 1분 전의 모든 detail을 직접 참조한다는 사실은 다릅니다. Qualitative result에서 subject와 background가 유지돼도 작은 object, causal event, prompt story가 같은지는 별도 평가해야 합니다.
긴 Memory의 학습 비용과 손실을 함께 잰다
Long-context teacher를 training에 유지하는 비용은 큽니다. Slow memory compression이 만든 정보 손실과 DMD teacher의 오류도 student에 전달될 수 있습니다. FVD나 ECL이 인간이 느끼는 story coherence를 완전히 대변하지도 않습니다.
검증할 때는 첫 frame의 identity, 최근 motion, 먼 과거의 작은 object, 장기 causal event를 각각 query하는 test를 만듭니다. Memory 구간별 token 수, training compute, generation latency도 기록합니다. Context Forcing의 핵심은 “1분 영상 문제를 모두 해결했다”가 아니라 긴 context를 요구하는 student에게 짧은 기억의 teacher를 쓰던 구조적 불일치를 제거했다는 것입니다.
Teacher와 Memory의 기여를 어떻게 분리할까
Long-context teacher와 계층 memory가 동시에 바뀌면 어느 요소가 drift를 줄였는지 알기 어렵습니다. Teacher context와 student memory를 교차한 네 조건을 같은 checkpoint, data budget에서 비교합니다.
| Teacher | Student memory | 확인할 질문 |
|---|---|---|
| Short | Short | 기존 local supervision 기준선 |
| Long | Short | Teacher만 오래 봐도 student가 활용할 수 있는가 |
| Short | Sink, slow, fast | Memory는 있지만 잘못 채점되는가 |
| Long | Sink, slow, fast | Context match의 추가 이득은 얼마인가 |
동일한 initial frame에서 10초, 20초, 60초 rollout의 identity, motion과 작은 object를 측정합니다. Long teacher가 전체 품질을 높였지만 training compute가 크게 늘었다면 효과와 비용을 함께 공개해야 합니다. Student만 긴 memory를 갖는 조건에서 drift가 남는다면 supervision mismatch라는 설명을 지지합니다.
ECL 20초는 어떤 질문으로 확인할까
ECL은 단순히 20초짜리 video를 생성했다는 뜻이 아니라 현재 output에 과거 정보가 유의미하게 영향을 주는 범위를 측정합니다. 과거 frame을 바꾸거나 가린 뒤 현재 generation이 필요한 방향으로 달라지는지 보는 intervention이 유용합니다.
예를 들어 처음에 character가 red scarf를 착용하고 25초 동안 화면 밖에 있다 돌아오는 prompt를 만듭니다. 재등장 때 scarf를 유지하는지, 초기 frame에서 scarf 색만 바꾸면 재등장 색도 바뀌는지 봅니다. Background identity는 유지되지만 작은 scarf를 잃으면 memory가 coarse scene에는 작동하고 fine detail에는 약한 것입니다.
| 기억 항목 | 필요한 구간 | 대표 failure |
|---|---|---|
| Initial face, costume | Sink, slow | identity, accessory drift |
| 최근 pose, velocity | Fast | motion jump, flicker |
| 잠깐 등장한 object | Slow selection | rare event 삭제 |
| 앞 사건의 결과 | Slow와 story condition | causal reset |
20초라는 하나의 평균 대신 item별 recall이 시간에 따라 어떻게 떨어지는지 표시하면 실제 usable context를 알 수 있습니다.
Slow Memory에서 무엇을 버렸는지 추적할까
Slow memory sampling interval과 token budget을 바꾸고 작은 object recall, identity와 generation latency를 함께 그립니다. 압축을 강하게 할수록 memory는 줄지만 정보 손실이 커집니다. First-frame sink도 언제나 정답 anchor는 아닙니다. 초기 frame에 artifact가 있으면 그 오류가 긴 영상 전체에 고정될 수 있습니다.
Scene change가 의도된 prompt에서는 첫 배경을 끝까지 유지하는 것이 오히려 실패입니다. Identity는 유지하되 location은 바뀌어야 하는 case를 넣어 memory가 모든 과거 pixel을 복사하는지 narrative state를 선택하는지 확인합니다. Long-context consistency와 변화 가능성 사이의 균형입니다.
운영 비용에는 long teacher의 training token, GPU memory와 student의 generation FPS, peak KV를 나눠 기록합니다. Teacher는 deployment에 없더라도 학습비를 늘리고, sink, slow, fast cache는 inference memory와 selection overhead를 청구합니다. 1분 output이 필요하지 않은 service라면 이 비용이 short-context baseline의 단순성보다 큰지 먼저 판단해야 합니다.
함께 읽으면 이해가 이어지는 글
- 카메라가 돌아오면 배경이 바뀌는 AI 영상, Spatia는 3D Memory로 어떻게 막나 — Spatia가 정적 장면을 3D point cloud memory에 저장하고 새 clip에서 얻은 정보를 Visual SLAM으로 갱신해 loop-back 일관성을 유지하려는 구조와 한계를 정리합니다.
- 화면 밖 자동차를 비디오 모델이 잊는다면? HyDRA의 Top-K 기억 — 과거 프레임을 모두 쌓지 않고 압축 메모리에서 관련 토큰만 찾는 HyDRA의 객체 영속성 설계, HM-World 범위와 검색 병목을 살펴봅니다.
- TMD는 50-step 비디오 생성을 정말 4-step으로 줄일까: Backbone, Flow Head 구조 — TMD가 teacher의 긴 sampling trajectory를 네 transition으로 증류하고 무거운 backbone과 반복 flow head를 분리하는 방식, 95% 성능, 실시간 주장과 1~2-step 한계를 점검합니다.
자주 묻는 질문
1분 영상을 만들면 1분 전 정보를 모두 기억하나요?
아닙니다. Output duration과 effective context length는 다르며 보고된 ECL 20초 이상도 identity, 작은 object, causal event별 recall을 각각 보장하지 않습니다.
Long-context teacher는 왜 필요한가요?
Student의 현재 chunk가 초기 character, scene과 달라졌는지를 판단하려면 teacher도 같은 장기 history를 봐야 짧은 5초 teacher의 supervision mismatch를 줄일 수 있습니다.
Sink, slow, fast memory가 모든 detail을 보존하나요?
아닙니다. Sink는 초기 anchor, fast는 최근 motion, slow는 먼 과거의 압축 정보를 맡으므로 작은 accessory, 짧은 사건이 slow memory에서 사라질 수 있습니다.
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.