RLVR에서 답변 길이가 흔들리는 이유는 정답 reward만 같아도 policy objective가 sequence 길이에 따라 gradient 크기와 상대 이점을 다르게 만들 수 있기 때문입니다. LUSPO는 긴 답이나 짧은 답을 선호하지 않도록 길이 의존 항을 정규화해, 필요한 reasoning 길이를 reward가 아니라 optimizer 편향이 결정하는 문제를 줄입니다.
RLVR 답변이 알고리즘에 따라 길어지거나 무너지는 이유: LUSPO
같은 환경에서도 GRPO와 GSPO의 길이는 반대로 움직였다
Reinforcement Learning with Verifiable Rewards(RLVR)는 수학, code처럼 answer를 자동 채점할 수 있는 task에서 여러 response를 sampling하고 정답 sample에 reward를 줍니다. 어려운 문제를 더 오래 생각하며 response가 길어질 수 있지만, 길이 증가 자체가 reasoning 향상의 증거는 아닙니다.
원문은 Qwen2.5-VL-7B-Instruct에서 loss function 외 조건을 통제했을 때 GRPO response는 길어지고 GSPO response는 점차 짧아지는 결과를 제시합니다. GSPO에서는 length collapse와 함께 성능이 정체되거나 내려갈 수 있습니다.
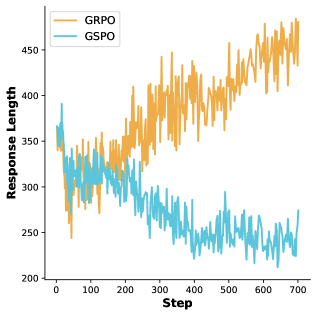
이 비교는 prompt나 dataset 탓만으로 길이 변화를 설명할 수 없음을 보여줍니다. Algorithm objective 자체를 분해해야 합니다.
Sequence 수준 Gradient에 길이 편향이 섞인다
GSPO는 sequence log probability와 group-relative reward를 사용합니다. Sample마다 token 수가 다른데 sequence 전체 score와 reward를 결합하면 길이에 따라 gradient scale과 평균 비교가 달라질 수 있습니다. Model은 reasoning 품질이 아니라 objective를 쉽게 줄이는 방향으로 짧은 response를 택할 수 있습니다.
LUSPO는 sequence 길이에 비례하는 성분을 normalization하고, group advantage에서 길이로 생기는 noise를 줄입니다. 목표는 길이를 일정 값으로 고정하는 것이 아니라 reward가 같은 두 response를 길이만으로 다르게 대우하지 않는 것입니다. 따라서 “Length-Unbiased”는 짧게 답하는 model이나 길게 답하는 model을 직접 만드는 옵션이 아닙니다.
Accuracy와 평균 Token을 반드시 함께 본다
실험은 Qwen2.5-VL-7B-Instruct와 Qwen2.5-7B-Base, MATH-500, GSM8K, MathVista, ScienceQA, MMMU를 사용합니다. 원문은 LUSPO가 GRPO와 GSPO보다 안정적인 length curve와 높은 benchmark accuracy를 보였다고 설명합니다.
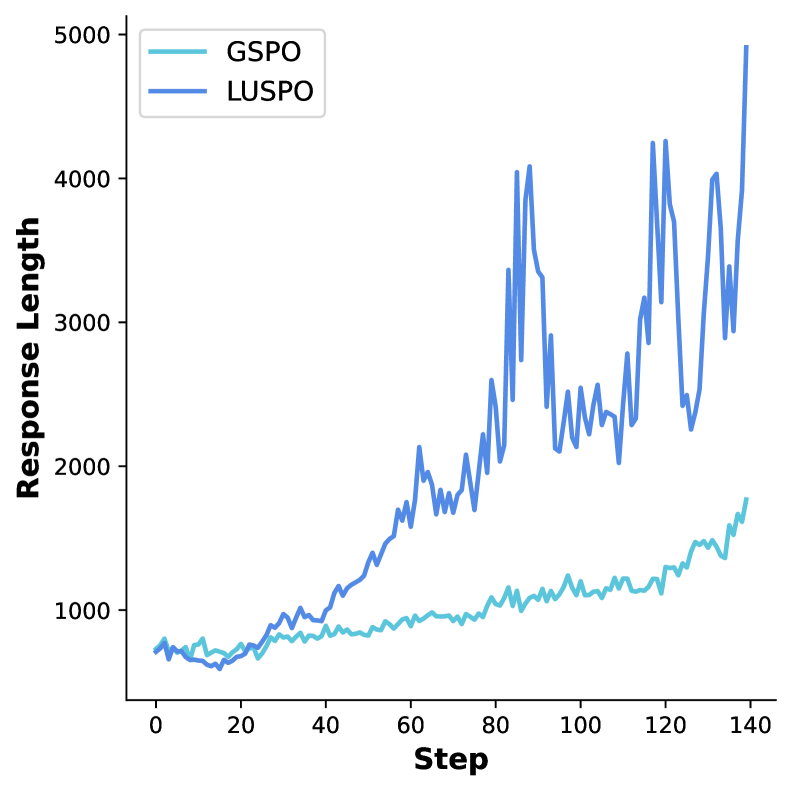
그러나 length collapse를 막는 과정에서 평균 output token이 늘면 inference cost도 증가합니다. 정답인 장문 안에 불필요한 반복이나 잘못된 중간 설명이 섞여도 binary reward는 잡지 못할 수 있습니다. Accuracy, median, tail length, latency, reasoning error를 함께 평가해야 합니다.
Length-neutral이 Process quality까지 보장하지 않는다
LUSPO는 objective의 통계적 편향을 다루지만 reward function의 한계를 없애지 않습니다. Group sampling에는 여러 response를 동시에 생성할 VRAM과 compute가 필요합니다. 특정 dataset에서 얻은 optimal length가 다른 domain에도 맞는다는 보장도 없습니다.
검증할 때는 같은 model, data, sampling 수에서 GRPO, GSPO, LUSPO를 비교하고 seed별 length distribution을 기록합니다. Correct answer 중 redundant token과 wrong reasoning step도 표본 검사합니다. LUSPO의 중요한 교훈은 “더 길게 생각하면 똑똑하다”가 아니라 optimizer가 response length를 몰래 reward하지 않도록 먼저 교정한 뒤 reasoning 품질을 평가해야 한다는 것입니다.
길이 구간별 Accuracy를 왜 나눠 봐야 하나
전체 평균 length와 accuracy 두 값만 보면 어떤 response가 늘거나 줄었는지 알 수 없습니다. Output token을 짧음, 중간, 김 bucket으로 나누고 각 bucket의 sample 수, accuracy와 평균 reward를 봅니다. Algorithm이 어려운 문제에서만 길이를 늘렸는지 쉬운 문제까지 반복을 붙였는지 드러납니다.
| 관찰 | 가능한 해석 | 추가 확인 |
|---|---|---|
| 긴 bucket 증가와 accuracy 상승 | 어려운 문제의 reasoning 확대 | 중간 step이 실제로 유효한가 |
| 긴 bucket 증가, accuracy 동일 | verbosity 또는 reward exploit | 반복, 무관 token 비율 |
| 짧은 bucket 급증, accuracy 하락 | length collapse | 답을 찍는 sample, gradient scale |
| Length 안정, accuracy 상승 | 편향 교정 가능성 | seed, domain 재현성 |
문제 자체의 난도를 맞추지 않으면 쉬운 question이 짧고 정확한 자연스러운 관계를 algorithm bias로 오해할 수 있습니다. 같은 prompt의 여러 rollout 안에서 reward와 length 관계를 보고, 문제별 평균을 제거한 분석을 함께 둡니다.
Correct answer의 과정 품질은 어떻게 audit할까
RLVR verifier가 마지막 숫자만 검사하면 잘못된 전제에서 우연히 답을 맞힌 response도 positive가 됩니다. Correct sample을 표본 추출해 중복 문장, self-contradiction, unsupported visual claim, 최종 답과 충돌하는 중간 계산을 label합니다.
긴 response를 무조건 penalty 주면 필요한 proof를 줄일 수 있으므로 redundancy와 essential reasoning을 구분합니다. 문장을 하나씩 제거했을 때 답의 논리 연결이 유지되는지 보거나, 계산 가능한 중간 식을 독립 verifier로 확인할 수 있습니다. Multimodal task에서는 rationale가 언급한 object, text가 image에 실제 있는지도 봅니다.
LUSPO가 length bias를 줄였더라도 reward가 process error를 보지 못하면 이 audit 결과는 개선되지 않을 수 있습니다. 그 경우 optimizer보다 verifier 또는 training data를 바꿔야 합니다.
안정성은 어느 training 구간에서 확인할까
Checkpoint별 median, p90, p99 length와 accuracy를 그립니다. 초반에는 안정돼 보이다가 특정 step 이후 GSPO가 collapse하거나 GRPO가 계속 길어질 수 있습니다. Mean만 보면 소수의 극단 장문이 가려지므로 tail length와 max context 초과 비율을 포함합니다.
같은 hyperparameter에서 seed를 바꿔야 normalization 효과가 우연한 sampling trajectory인지 알 수 있습니다. Group size와 maximum output length도 고정합니다. Algorithm마다 다른 cap을 쓰면 한쪽의 collapse 또는 expansion을 인위적으로 막은 비교가 됩니다.
추론 비용은 어떤 기준으로 결정할까
Training에는 group sampling response 수와 총 generated token이 비용을 좌우하고, deployment에는 answer당 output token과 latency가 직접 영향을 줍니다. Accuracy가 조금 높아졌지만 p95 length가 크게 늘었다면 service 비용과 timeout을 함께 판단해야 합니다.
Domain별 허용 length도 다릅니다. Short arithmetic는 간결한 답이 적합하고 formal proof는 긴 과정이 필요할 수 있습니다. Length-unbiased objective를 적용한 뒤에는 task-aware reward와 output contract로 필요한 detail을 정하되, 단순 token 수를 품질 proxy로 사용하지 않습니다.
도입 기준은 GRPO, GSPO보다 curve가 안정적이고 accuracy가 재현되며, correct response의 불필요한 token과 p95 latency가 운영 한도 안에 있는 것입니다. Length neutrality는 평가를 공정하게 만드는 기반이지 최종 답변 품질의 완성 조건은 아닙니다.
함께 읽으면 이해가 이어지는 글
- 5B 이미지 모델이 80B보다 낫다는 말은 어디까지 사실일까: DeepGen 1.0 — DeepGen 1.0의 SCB, Think Token, MR-GRPO 구조와 WISE, UniREditBench 비교 수치를 조건별로 읽고 배포 가능성을 판단합니다.
- Reasoning LLM은 정말 인간처럼 생각할까: System 1, 2와 추론 성능을 구분하는 법 — Reasoning LLM 설문 논문이 정리한 구조적 탐색, 보상 모델, 자기 개선, macro action, 강화 미세 조정을 살펴보고 ‘긴 답변’과 실제 추론을 구분하는 평가 기준을 정리합니다.
- 영상의 다음 사건을 맞히려면: Video-CoE가 시간 근거를 강제하는 법 — Video-CoE의 사건 사슬 SFT와 형식, 시간 정렬, 정답 보상 GRPO가 미래 예측을 어떻게 훈련하는지, 공개 코드와 지연 한계까지 짚습니다.
자주 묻는 질문
LUSPO는 답변을 짧게 만드는 알고리즘인가요?
아닙니다. 특정 길이를 목표로 하지 않고 reward가 같은 response를 길이 자체만으로 다르게 대우하는 gradient 편향을 줄이는 방법입니다.
응답 길이가 안정되면 reasoning 품질도 좋아지나요?
자동으로 보장되지는 않습니다. Binary correctness reward는 장문의 반복, 잘못된 중간 단계나 짧은 guess를 놓칠 수 있어 과정 오류와 효율을 별도로 검사해야 합니다.
LUSPO 평가에는 accuracy 외에 무엇이 필요한가요?
Correct, incorrect별 length distribution, median, p95 output token, latency, sampling compute, redundant token과 seed별 collapse 여부를 함께 봐야 합니다.
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.