DreamDojo의 답은 “가능하지만 그대로는 아니다”입니다. 4만 4천 시간의 사람 영상에서 관측 변화의 latent action을 배우고, 약 500시간의 robot data로 실제 action space에 연결해야 합니다. 10.81 FPS의 future prediction도 전체 closed-loop control 속도나 안전을 자동으로 보장하지 않습니다.
인간 영상 4만 4천 시간은 로봇 행동이 될 수 있나: DreamDojo
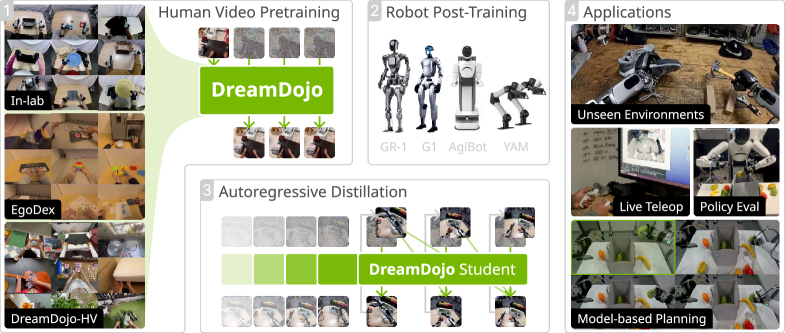


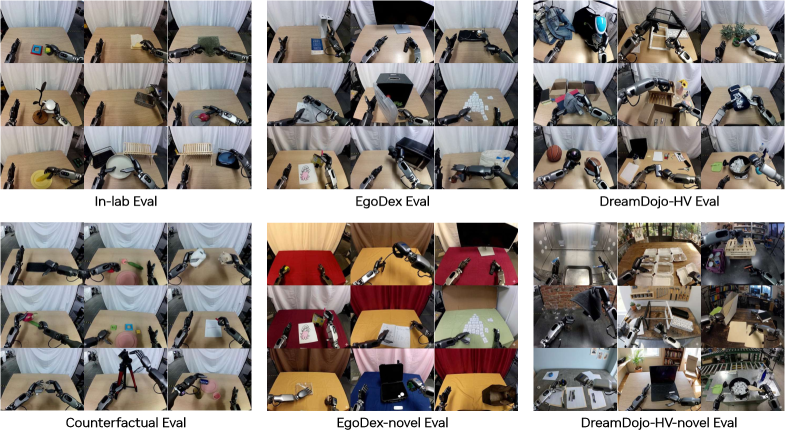
실제 도입 전에 볼 실패 조건
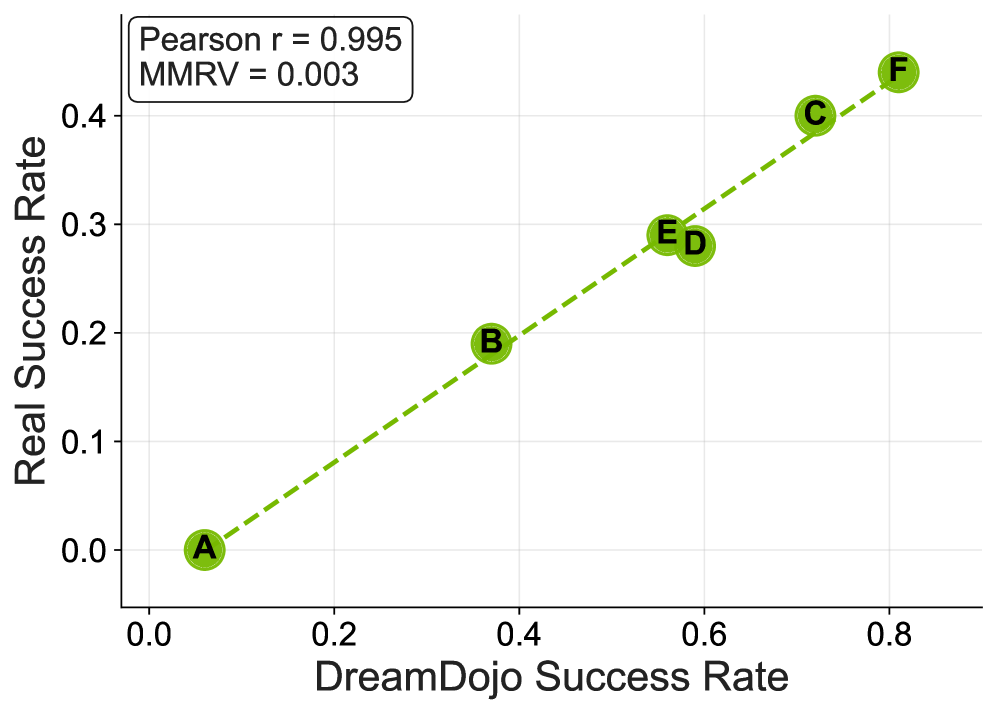
첫째, 잠재 행동이 로봇의 실제 제어 명령과 얼마나 안정적으로 대응하는지 확인해야 합니다. 둘째, 긴 롤아웃에서는 작은 영상 예측 오류가 누적되는지 봐야 합니다. 셋째, 사람의 손과 몸을 중심으로 배운 표현이 다른 로봇 형태나 작업 공간에서도 유지되는지 시험해야 합니다.
DreamDojo는 대규모 비라벨 영상의 활용 가능성을 보여주는 연구이지, 어떤 로봇에도 즉시 연결되는 완성형 제어 소프트웨어는 아닙니다. 실제 적용에서는 충돌 제한과 정지 조건을 세계 모델 밖의 안전 계층에 두고, 짧은 예측 구간부터 검증하는 편이 타당합니다.
Latent Action이 행동만 담았는지 어떻게 확인할까
인접 frame의 변화에는 사람 손의 motion뿐 아니라 camera 흔들림, 조명, 다른 사람과 background 변화도 들어갑니다. Information bottleneck이 있다고 해서 자동으로 controllable action만 남는 것은 아닙니다. 같은 행동을 서로 다른 camera, background에서 수행한 pair와, camera만 움직이고 행동은 없는 pair를 비교해야 합니다.
| 입력 변화 | Latent에서 기대하는 관계 | 실패 신호 |
|---|---|---|
| 같은 grasp, 다른 배경 | 비슷한 action 표현 | 배경에 따라 latent가 크게 변함 |
| Camera만 이동 | robot action과 분리 | camera motion을 action으로 오인 |
| 손 모양, 속도 변화 | 관련 latent가 달라짐 | 세부 contact를 구분 못함 |
| 물체가 외력으로 이동 | agent action과 구분 | 모든 object motion을 자기 행동으로 해석 |
Latent를 decode해 reconstruction하는 것만으로 controllability를 증명할 수 없습니다. Robot data에서 같은 latent가 일관된 end-effector, gripper command와 연결되는지, candidate latent를 바꿨을 때 predicted future가 필요한 방향으로 달라지는지 intervention test를 합니다.
Human 4만 4천 시간과 Robot 500시간의 효과를 어떻게 나눌까
Human pretraining 없이 robot data만 쓴 baseline, human video만 학습한 world model, 두 data를 순서대로 연결한 DreamDojo 조건을 같은 robot task에서 비교합니다. Robot data budget을 0, 소량, 약 500시간 구간으로 바꾸면 human representation이 sample efficiency를 실제로 높였는지 볼 수 있습니다.
총시간 외의 분포도 중요합니다. Human video가 cooking과 hand-object interaction에 치우쳤다면 industrial tool이나 mobile robot navigation에는 transfer가 약할 수 있습니다. Robot 500시간도 embodiment, camera, task별 비율을 공개해야 target robot과 얼마나 가까운지 판단할 수 있습니다.
Unseen object, unseen task와 unseen robot을 분리합니다. 새 object에서 성공해도 같은 hardware와 action mapping을 썼다면 embodiment generalization은 아닙니다. 새 robot에서는 latent-to-action adapter에 필요한 additional episode, calibration과 성공률을 함께 기록합니다.
10.81 FPS와 Closed-loop Latency는 어떻게 다른가
10.81 FPS는 일정 시간에 생성하는 predicted frame의 throughput입니다. Model-based control은 한 번 future를 만드는 것보다 여러 candidate action의 미래를 예측하고 score해 하나를 고를 수 있어 planning cost가 커집니다.
1
2
3
4
5
6
현재 관측 encode
→ candidate action 생성
→ 후보별 future rollout
→ goal, risk score 계산
→ action 선택, safety filter
→ actuator 실행
Candidate가 $K$개이고 horizon이 길어지면 한 frame FPS만으로 응답 시간을 알 수 없습니다. Batch로 후보를 처리하면 throughput은 높아져도 첫 action latency와 memory가 커질 수 있습니다. Batch 1의 observation-to-action p50, p95, candidate 수, rollout horizon과 peak memory를 함께 측정합니다.
빠른 world model이 stale observation을 사용하면 움직이는 object에 늦을 수 있습니다. 예측 시작 frame timestamp와 실제 action 실행 시각을 연결하고, scene 변화가 큰 경우 진행 중인 plan을 취소합니다. 목표 control frequency에 맞지 않으면 짧은 horizon이나 더 적은 candidate, reactive policy fallback을 검토해야 합니다.
Future Prediction은 어떤 층으로 평가할까
Visual quality 하나가 아니라 task에 필요한 state를 봅니다.
- 단기 visual: 다음 몇 frame의 object identity, motion이 맞는가.
- Action adherence: candidate action을 바꾸면 target state가 올바르게 달라지는가.
- Contact dynamics: grasp, slip, collision과 deformable change가 맞는가.
- 장기 rollout: 작은 오류가 누적돼 object 수, 위치와 goal이 drift하는가.
- Policy value: predicted future로 고른 action이 실제 environment에서도 성공하는가.
Oracle action의 future도 틀리면 world model 문제이고, future는 맞지만 선택한 action이 틀리면 planner, scoring 문제입니다. 실제 state를 일정 간격마다 다시 넣는 closed-loop와 예측만 이어 가는 open-loop를 비교하면 correction이 drift를 얼마나 줄이는지 알 수 있습니다.
안전하게 시작할 수 있는 적용 범위
첫 PoC는 collision이 없는 simulation이나 저속 tabletop에서 짧은 horizon으로 시작합니다. Predicted와 observed state 차이가 threshold를 넘으면 남은 action을 버리고 재관측합니다. Joint limit, force, torque, 사람 접근과 emergency stop은 world model 밖의 deterministic controller가 담당합니다.
Human video에는 실패, 위험 행동과 camera 편집도 포함될 수 있습니다. 대규모라는 이유만으로 모든 trajectory를 바람직한 행동으로 보지 않고 robot reward, safety constraint와 분리합니다. Teleoperation 보조나 candidate visualization은 model이 직접 motor를 제어하는 것보다 낮은 위험의 초기 용도입니다.
도입 조건은 human pretraining이 같은 robot data budget에서 실제 success를 높이고, latent mapping이 새 camera, embodiment에 견디며, planning latency와 drift가 안전 limit 안에 있을 때입니다. 가장 큰 data 시간과 FPS 한 숫자만으로는 이 세 조건을 판단할 수 없습니다.
함께 읽으면 이해가 이어지는 글
- 로봇 비디오가 물체를 뚫고 지나간다면? Kinema4D의 URDF, Pointmap 제어 — 로봇 기구학에서 만든 3D 궤적과 pointmap을 비디오 생성에 넣는 Kinema4D의 구조, Robo4D-200K 학습 범위와 물리 한계를 살펴봅니다.
- 로봇이 미래 영상을 만들지 않고도 다음 행동을 고를 수 있나: World Guidance — WoG가 미래 관측을 Q-former 조건 표현으로 압축하고 VLA가 행동과 함께 예측하게 하는 2단계 학습, UMI 성과와 지연 한계를 설명합니다.
- 예쁜 영상이 물리까지 맞는지 어떻게 알까: Omni-WorldBench 평가법 — Omni-WorldBench의 상호작용 중심 Suite와 MLLM 기반 AgenticScore가 인과, 상태 변화, 카메라 제어를 평가하는 방식과 비용, 평가자 편향을 정리합니다.
자주 묻는 질문
사람 영상 4만 4천 시간이 있으면 robot data는 필요 없나요?
아닙니다. Human video에는 joint, gripper command가 없어 약 500시간의 robot data가 latent change를 실제 action space와 연결하는 역할을 합니다.
10.81 FPS이면 실시간 robot control이 가능한가요?
Video prediction throughput 수치만으로는 부족하며 camera input, candidate action 평가, planning, safety check와 actuator 통신을 합친 closed-loop latency를 측정해야 합니다.
Latent action은 사람과 모든 robot 사이에서 공통인가요?
공통 변화 표현을 목표로 하지만 hand, camera, DoF, contact 차이가 커서 unseen embodiment와 target hardware별 calibration, adaptation 성능을 별도로 확인해야 합니다.
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.