GigaBrain-0.5M*는 현재 관측만으로 다음 행동을 고르는 대신, 월드 모델이 만든 미래 상태 표현을 정책의 조건으로 사용하는 VLA 모델입니다. 핵심인 RAMP는 월드 모델 사전학습, 조건부 정책 학습, 인간 개입 롤아웃, 지속 학습을 하나의 순환 과정으로 연결합니다. 원문이 보고한 10,000시간 이상의 기반 데이터와 RECAP 대비 약 30% 개선은 특정 과제, 설정의 결과이므로, 실제 로봇에서는 지연과 잘못된 미래 예측의 위험을 함께 검증해야 합니다.
GigaBrain-0.5M*는 월드 모델을 로봇 정책에 어떻게 연결하나
직접 행동 예측만으로는 왜 장기 작업이 어려울까?
기존 VLA가 현재 관측에 의존할 때 생기는 한계
RT-2, Octo 등 기존 VLA 모델의 한 접근은 현재 관측값에서 다음 행동 청크를 직접 출력하는 Direct Action Prediction(직접 행동 예측)입니다.
이 접근에는 두 가지 한계가 생길 수 있습니다.
- 제한된 장면 이해(Constrained Scene Understanding): 정적인 이미지나 짧은 비디오 클립만으로는 물리적 공간의 복잡한 상관관계를 파악하기 어렵습니다.
- 약한 미래 예측 능력(Weak Future Anticipation): 행동이 환경에 미칠 영향을 명시적으로 참고하지 않으면, 실수를 수정하거나 장기 계획을 유지하기 어렵습니다.
월드 모델은 무엇을 추가하는가?
비디오 월드 모델은 미래 상태를 나타내는 시공간적 표현(Spatiotemporal Representation)을 정책에 제공할 수 있습니다. 연구의 질문은 이 미래 표현을 로봇의 제어 정책에 직접 조건으로 넣었을 때 행동 선택이 나아지는지입니다.
GigaBrain-0.5M*는 월드 모델을 보조 시각화가 아니라 강화학습 정책의 조건으로 사용합니다. 다만 생성된 미래는 실제 환경이 아니라 모델의 예측이므로, 예측 오류가 행동 선택에 미치는 영향도 함께 고려해야 합니다.
RAMP의 네 단계는 어떻게 정책을 개선할까?
RAMP(Reinforcement leArning via world Model-conditioned Policy)는 네 단계의 파이프라인으로 구성됩니다.
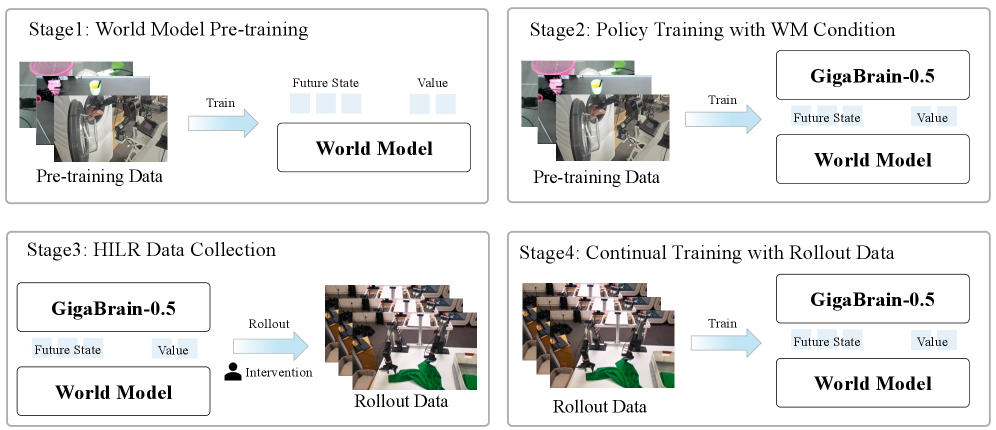 그림 2: RAMP 프레임워크의 4단계 파이프라인 개요. 월드 모델 사전 학습부터 인간 개입형 데이터 수집, 지속적 학습에 이르는 폐쇄 루프(Closed-loop) 과정을 보여줍니다.
1단계: 월드 모델 사전 학습
연구팀은 비디오 데이터로 미래 상태를 예측하는 월드 모델을 학습시킵니다. 이 모델은 잠재 공간에서 미래 상태 예측(Future State Prediction)과 가치 추정(Value Estimation)에 쓰일 통합 표현을 만듭니다.
2단계: 월드 모델 조건부 정책 학습
기존 GigaBrain-0.5에 월드 모델의 잠재 표현을 명시적인 조건으로 주입합니다. 정책은 현재 시각 정보와 예상 미래를 함께 참고해 행동을 선택합니다.
3단계: 인간 개입형 롤아웃 데이터 수집
자율적인 실행만으로는 복잡한 코너 케이스(Corner Case)를 극복하기 어렵습니다. RAMP는 Human-in-the-Loop Rollout (HILR) 방식을 채택했습니다. 로봇이 작업을 수행하다가 실패하거나 불확실한 상황에 직면하면 전문가가 개입하여 수정을 가합니다. 이 과정에서 성공 궤적뿐만 아니라 ‘수정 신호(Corrective Signal)’가 포함된 고품질 데이터가 축적됩니다.
4단계: 롤아웃 데이터를 이용한 지속 학습
수집된 데이터로 정책을 계속 업데이트합니다. 성공 시연과 인간의 수정 신호를 함께 사용하고, 월드 모델의 가치 추정을 강화학습 과정에 연결합니다. 이 순환이 유효하려면 인간 교정이 실제 실패를 잘 대표하고 월드 모델의 잘못된 예측이 보상으로 굳어지지 않는지 확인해야 합니다.
어떤 데이터와 로봇 과제에서 시험했나?
학습 데이터 규모
GigaBrain-0.5M*의 베이스 모델인 GigaBrain-0.5는 10,000시간 이상의 실제 로봇 조작 데이터로 학습된 것으로 보고됩니다. 데이터 시간은 규모를 보여 주지만 작업 종류, 실패 사례, 센서 조건의 다양성을 대신하지는 않습니다.
하드웨어 구성
연구는 두 가지 주요 플랫폼을 사용했습니다.
- PiPER 로봇 암: 정밀한 박스 포장 및 물체 조작 테스트용.
- G1 휴머노이드 로봇: 전신 제어 및 이동성이 결합된 복잡한 과업 수행용.
테스트 시나리오
단순한 집기(Pick-and-place)를 넘어, 다음과 같은 Long-horizon 과업을 설정했습니다.
- Laundry Folding: 유연한 물체(비정형 객체)를 다루는 고난도 작업.
- Box Packing: 공간 추론이 필요한 정밀 작업.
- Espresso Preparation: 여러 도구를 순차적으로 사용하는 복합 시퀀스 작업.
RECAP 대비 약 30% 개선을 어떻게 읽어야 할까?
원문은 RAMP를 적용한 GigaBrain-0.5M*를 RECAP 기준선과 비교합니다.
- 성능 향상 폭: 세탁물 접기, 박스 포장 등 핵심 과업에서 성공률이 약 30% 향상되었습니다.
- 장기 실행 안정성: 긴 작업에서 월드 모델을 참고해 궤적을 수정하는 결과를 제시합니다.
- 적응성(Adaptability): 조명 조건이나 물체 위치가 달라진 상황의 결과를 제시합니다.
이 수치는 절대 성공률인지 상대 개선률인지, 어떤 과제를 묶은 값인지와 함께 읽어야 합니다. 인간 개입 데이터와 월드 모델 조건을 동시에 사용하므로 개선을 한 요소에만 돌리기도 어렵습니다. 같은 로봇, 작업, 초기 상태에서 월드 모델 없이 학습한 정책과 비교하고, 실패 유형별 결과와 추론 지연을 함께 봐야 합니다.
실제 적용 가능성은 어느 과제에서 확인할 수 있을까?
논문에 포함된 과제를 바탕으로 물류와 서비스 로봇의 적용 조건을 살펴볼 수 있습니다.
물류 및 풀필먼트 센터
박스 포장 실험은 물체 크기와 배치 순서가 달라지는 조작 과제를 보여 줍니다.
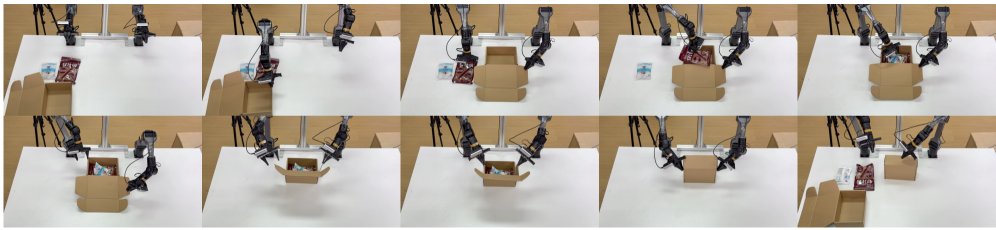 그림 5: 실제 환경에서 PiPER 로봇 암을 이용해 박스 포장 작업을 수행 중인 GigaBrain-0.5.
실제 물류에 적용하려면 다양한 크기의 물건과 상자에서 충돌, 파손, 재시도 횟수를 따로 측정해야 합니다. 한정된 실험 과제의 성공만으로 임의의 물품 배치를 일반화할 수는 없습니다.
서비스 및 가사 로봇
G1 휴머노이드에 탑재한 결과는 전신 제어와 이동이 포함된 과제로 확장할 가능성을 보여 줍니다.
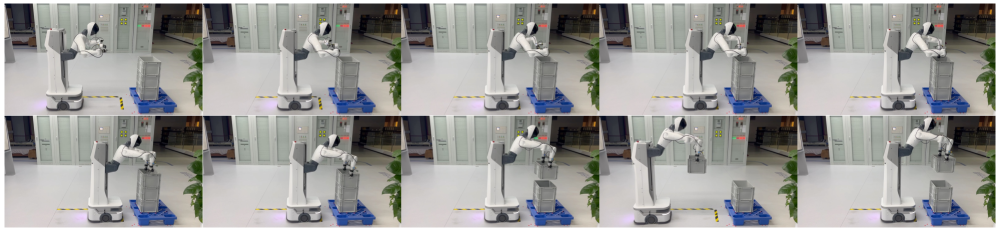 그림 6: G1 휴머노이드 로봇에 탑재되어 실제 환경에서 박스 운반 과업을 수행하는 모습.
사람과 장애물이 있는 공간에서는 평균 성공률보다 충돌 회피, 정지 응답, 예측이 틀렸을 때의 안전 경로가 우선입니다. 월드 모델의 예상 미래는 안전 센서와 제어기의 확인을 대신할 수 없습니다.
어떤 조건에서 도입을 보류해야 할까?
세 가지 한계를 먼저 검토해야 합니다.
- 추론 비용(Inference Cost): 정책 네트워크 외에 거대한 월드 모델을 동시에 실행하거나 조건부로 활용하는 것은 계산 리소스를 많이 소모합니다. 엣지 디바이스에서의 실시간성(Real-time latency) 확보가 관건이 될 것입니다.
- HILR의 확장성 문제: 개선의 일부가 인간 전문가의 개입 덕분이라면, 더 많은 로봇과 과제에 필요한 교정 데이터를 어떻게 확보할지 남습니다.
- 물리적 정확도의 한계: 비디오 월드 모델이 생성한 ‘상상’이 실제 물리 법칙과 미세하게 다를 경우(예: 마찰력, 미끄러짐 등), 정책 결정에 오히려 독이 될 수 있습니다. 잠재 공간의 물리적 정합성을 어떻게 보장할지에 대한 더 깊은 연구가 필요합니다.
결론: 월드 모델 조건부 정책을 선택할 기준은 무엇인가?
GigaBrain-0.5M*의 의미는 미래 상태 표현, 정책 학습, 인간 교정 데이터를 하나의 폐쇄 루프로 연결했다는 데 있습니다. 적용할 과제가 긴 순서를 요구하고 직접 행동 정책의 오류 누적이 반복된다면 비교 실험할 이유가 있습니다.
다만 월드 모델의 예측이 실제 마찰, 미끄러짐과 어긋나거나, 추가 추론 때문에 제어 주기를 맞추지 못하거나, 인간 교정 비용이 확장을 막는다면 적용을 보류해야 합니다. 대표 과제에서 성공률뿐 아니라 첫 실패 단계, 개입 횟수, 지연, 안전 정지 결과를 함께 측정해야 논문의 개선이 실제 운영 가치로 이어지는지 판단할 수 있습니다.
월드 모델의 신뢰도는 예측 영상의 선명함보다 행동 결과의 보정 오차로 확인해야 합니다. 후보 행동별 성공 확률 순위가 실제 로봇의 성공 순위와 같은지, 자신 있게 높게 평가한 실패가 얼마나 있는지 기록합니다. 특정 물체나 조명에서 순위가 뒤집히면 그 구간의 상상 롤아웃을 정책 업데이트에 쓰지 않거나 가중치를 낮춰야 합니다. 월드 모델이 모르는 상태에서 정책이 더 공격적으로 변하지 않도록 불확실한 후보는 사람 교정이나 안전한 기본 행동으로 보내는 경계도 필요합니다.
함께 읽으면 이해가 이어지는 글
- 로봇은 미래 픽셀까지 그려야 할까? FRAPPE의 다중 VFM 정렬 — FRAPPE가 다음 화면의 픽셀 대신 여러 시각 기초 모델의 미래 표현을 맞추는 이유와 장기 조작에서 얻는 이점, 계산 비용을 정리합니다.
- 실물 시행착오 없이 로봇 정책을 개선할 수 있나: RISE의 상상 롤아웃 — RISE가 동역학 모델과 진행 가치 모델을 조합해 가상 롤아웃으로 정책을 개선하는 구조, 세 조작 과제 성과와 모델 편향 위험을 분석합니다.
- 로봇이 목표까지의 중간 장면을 상상하면 왜 나아질까? Act2Goal의 MSTH — Act2Goal이 현재 image와 goal image 사이의 중간 상태를 visual world model로 만들고, 가까운 미래는 촘촘하게 먼 미래는 성기게 읽는 MSTH로 control에 연결하는 방식을 설명합니다.
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.