MedXIAOHE는 해상도와 형태가 다른 의료 영상, 의료 텍스트와 환자 기록을 함께 다루기 위해 네이티브 해상도 비전 구조와 단계별 도메인 학습을 결합한 의료 MLLM입니다. Entity-aware Continual Pretraining, Reasoning-aware Mid-training, 도구 활용 학습이 각각 지식, 추론, 실행 능력을 맡습니다. 연구 벤치마크의 보고 결과는 임상 안전성이나 진단 승인을 뜻하지 않으므로, 영상 유형, 환자군별 외부 검증과 의료진 검토가 반드시 필요합니다.
MedXIAOHE는 의료 멀티모달 모델을 어떻게 학습하나: 구조와 검증 한계
범용 멀티모달 모델을 의료에 바로 쓰기 어려운 이유는 무엇인가?
범용 멀티모달 모델을 의료 현장에 적용할 때는 다음 한계를 구분해야 합니다.
- 도메인 지식의 깊이와 희귀 질환 문제: 범용 모델은 일반적인 의학 지식은 갖추고 있으나, 희귀 질환(Rare Diseases)이나 복잡한 병리 사진 해석에서 필요한 정밀한 지식이 부족합니다. 이는 데이터 분포의 롱테일(Long-tail) 특성 때문입니다.
- 의료 영상의 다양성과 해상도: 의료 영상은 X-ray, CT, MRI, 병리 슬라이드 등 양식이 매우 다양하며, 암 진단 등에서 미세한 병변을 포착하기 위해서는 초고해상도 처리가 필수적입니다. 기존 모델의 고정 해상도 접근 방식은 정보 손실을 초래합니다.
- 추론의 투명성 및 검증 가능성: 의료 진단은 ‘왜 그런 결론에 도달했는가’에 대한 명확한 근거(Evidence-grounding)가 필요합니다. 단순한 정답 제시가 아닌, 단계별 추론 과정(Reasoning Trace)을 생성하고 이를 검증할 수 있어야 합니다.
- 환각(Hallucination)의 위험성: 의료 리포트에서 영상이나 기록에 없는 내용을 생성하면 환자 안전에 영향을 줄 수 있습니다.
MedXIAOHE는 이 문제를 모델 구조와 데이터 학습 단계에서 다루려 합니다. 다만 전문가 추론 형식과 비슷한 문장을 생성한다고 해서 판단이 의학적으로 타당하다는 보장은 없습니다.
서로 다른 의료 영상 해상도를 어떻게 처리할까?
아키텍처는 서로 다른 영상 해상도와 텍스트 기록을 같은 생성 모델에 연결합니다.
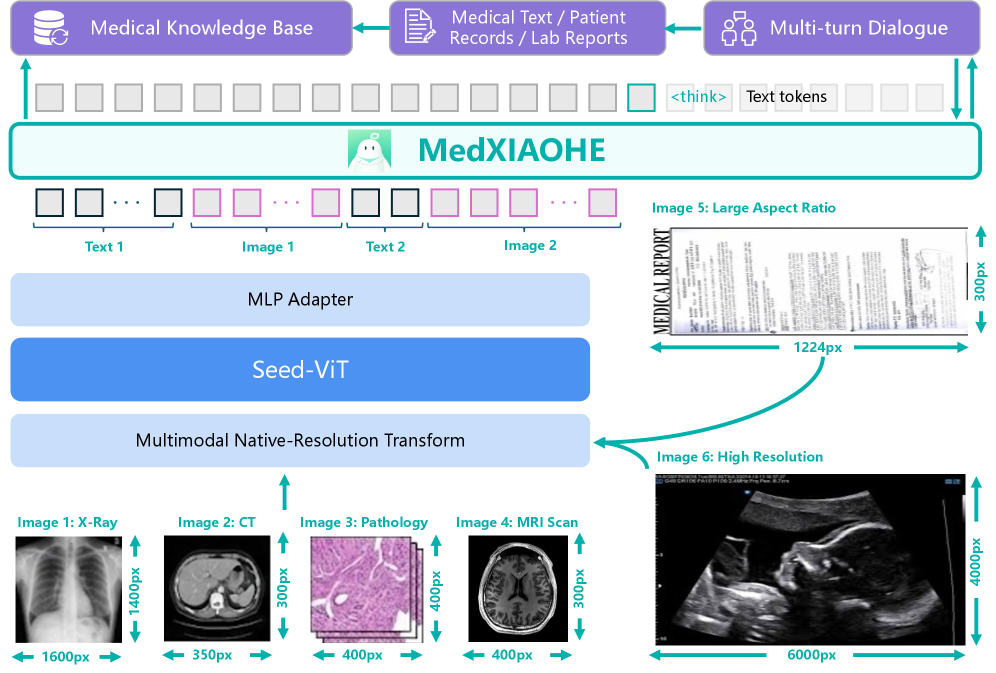 그림 2: MedXIAOHE의 전체 아키텍처. 다양한 의료 영상 모달리티와 해상도를 처리하기 위한 Native-Resolution Transformer 구조를 보여줍니다.
Multimodal Native-Resolution Transformer
고정 크기 리사이즈나 크롭은 작은 병변의 시각 정보를 잃을 수 있습니다. MedXIAOHE의 Native-Resolution 방식은 원래 종횡비와 해상도를 반영해 패치 단위로 처리합니다. 병리 조직이나 미세 구조처럼 작은 특징을 보존하려는 선택이지만, 입력 토큰과 메모리, 지연이 커질 수 있습니다.
Seed-ViT와 MLP Adapter
Seed-ViT가 영상 특징을 추출하고 MLP Adapter가 이를 텍스트 임베딩 공간에 연결합니다. 영상 토큰과 텍스트 토큰을 교차 배치해 기록과 영상을 함께 참조하는 다중 턴 생성을 지원합니다. 정렬된 표현이 병변의 위치와 근거 문장을 정확히 연결하는지는 별도 grounding 평가로 확인해야 합니다.
의료 지식과 추론 데이터는 어떤 단계로 구축될까?
MedXIAOHE는 의료 개체 중심 사전학습과 추론 중심 중간학습을 구분합니다.
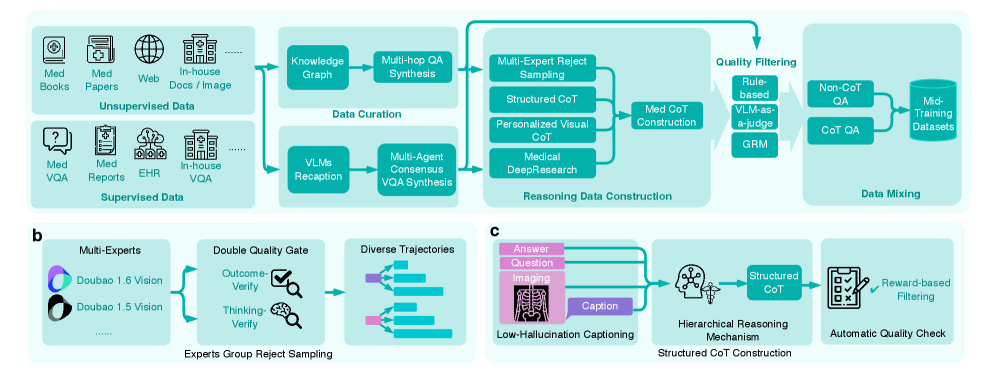 그림 5: Mid-training 데이터 구축 파이프라인. 지식 그래프와 멀티 에이전트 합의를 통해 고품질의 추론 데이터를 생성하는 과정을 나타냅니다.
Entity-aware Continual Pretraining
의료 텍스트의 전문 용어와 개체를 중심으로 지식을 구조화해 흔하지 않은 질환과 개념을 더 잘 포함하려는 단계입니다. 롱테일 지식의 누락을 줄이는 목적이지만, 희귀 질환별 표본 수와 외부 평가가 제시되지 않으면 실제 개선 범위를 단정하기 어렵습니다.
Reasoning-aware Mid-training 파이프라인
- 데이터 합성 엔진: 비정형 텍스트와 정형화된 지식 그래프(Knowledge Graph)를 결합하여 논리적 일관성이 있는 추론 데이터를 생성합니다. 단순히 ‘질문-답변’ 쌍이 아닌, ‘질문-추론 과정-최종 진단’의 Chain-of-Thought(CoT) 구조를 만듭니다.
- Multi-expert Reject Sampling: 생성된 추론 경로 중 논리적 오류가 있거나 의학적으로 부정확한 것을 걸러내기 위해 다중 전문가 모델이 검증하는 구조를 가집니다. Dual-quality Gate를 통해 인과관계가 명확한 데이터만 선별합니다.
- 환각 필터링: 시각 정보와 추론이 어긋나는 합성 사례를 자동 품질 검사로 거릅니다. 자동 필터가 모든 근거 없는 내용을 제거한다고 볼 수는 없습니다.
여러 전문가 모델의 합의는 단일 생성 오류를 거를 수 있지만, 같은 데이터와 의학 지식의 편향을 공유하면 공통 오답도 통과할 수 있습니다. 합성 추론의 문장이 자연스러운지보다 영상 근거, 임상 기록, 최종 결론의 연결이 실제 전문가 검토에서 맞는지를 확인해야 합니다.
벤치마크 우위는 임상 성능을 의미할까?
원문은 VQA, 의료 리포트 생성, 임상 추론 평가 결과를 제시합니다.
- 모델 비교: 병리와 방사선 관련 평가에서 비교 모델보다 높은 결과가 보고됩니다. 이는 해당 데이터와 평가 설정의 결과입니다.
- 장문 리포트 생성: 구조화된 보고서 생성과 지침 준수, 환각 관련 평가를 다룹니다.
- 추론 가시성: 단계별 설명을 제공하지만, 생성된 설명이 모델 내부 판단을 충실히 반영하거나 인과적으로 타당한지는 별도 검증이 필요합니다.
실제 성능 검증에서는 질환별 민감도와 특이도, 환자군과 장비가 바뀔 때의 성능, 근거 없는 소견, 중요한 누락을 나눠야 합니다. 보고서 문체가 전문적이라는 이유로 오류를 덜 의심하게 되는 자동화 편향도 고려해야 합니다.
어떤 용도부터 제한적으로 검토할 수 있을까?
연구 구조를 바탕으로 다음과 같은 보조 용도를 검토할 수 있지만, 이 글은 임상 승인이나 안전성을 확인하지 않습니다.
- 방사선 판독 보조: 영상과 기록을 바탕으로 의료진이 검토할 초안 리포트를 생성하는 용도.
- 디지털 병리 연구: 고해상도 병리 영상의 후보 영역과 설명을 검토하는 용도.
- 다학제 정보 정리: 여러 기록과 영상에서 관련 근거를 모으되 진단과 치료 결정은 의료진이 담당하는 용도.
- 교육 및 수련: 주니어 의사들이나 의대생들이 복잡한 케이스에 대해 AI와 대화하며 추론 과정을 학습하는 도구로 활용될 수 있습니다.
어떤 한계가 남으면 임상 도입을 보류해야 할까?
다음 한계는 별도 검증이 필요합니다.
- 데이터 편향: 지식 그래프와 합성 데이터를 사용해도 학습 기관, 환자군, 장비의 편향이 남을 수 있으므로 외부 기관에서 검증해야 합니다.
- 컴퓨팅 비용의 문제: Native-resolution Transformer는 높은 성능을 보장하지만, 추론(Inference) 시 요구되는 GPU 자원이 상당합니다. 실시간 응답이 중요한 임상 현장에서 비용 효율적인 서빙이 가능할지는 의문입니다.
- 책임 소지의 불분명성: ‘Verifiable decision traces’를 제공한다고 하지만, 복잡한 딥러닝 모델의 내부 작동 방식은 여전히 블랙박스에 가깝습니다. AI의 잘못된 추론 경로를 의사가 믿었을 때의 법적, 윤리적 책임 문제는 기술이 해결할 수 없는 영역입니다.
- 지식 업데이트: 학습 시점 이후의 가이드라인과 근거를 자동으로 반영한다고 가정할 수 없으므로 지식 버전과 도구 출처를 표시해야 합니다.
결론: MedXIAOHE를 평가할 때 무엇을 우선해야 할까?
MedXIAOHE는 네이티브 해상도 처리, 의료 개체 중심 학습, 합성 추론 필터링과 도구 활용을 하나의 개발 레시피로 제시합니다. 중요한 점은 각 장치가 환각과 편향을 “제거”하는 것이 아니라 줄이려는 설계라는 사실입니다.
도입 판단은 종합 벤치마크 순위보다 대상 병원과 장비에서의 외부 검증, 질환별 누락과 오탐, 근거 위치, 응답 지연, 의료진이 오류를 발견하는 시간으로 해야 합니다. 실제 환자 진단을 자동 확정하거나 치료를 추천하기 전에 규제, 개인정보, 책임 체계와 독립적인 안전 검토가 필요합니다.
함께 읽으면 이해가 이어지는 글
- UA-VLS의 불확실성 점수는 의료 판단을 안전하게 할까: SEU Loss와 Dice 3~5% 향상 — 임상 텍스트와 영상을 SSMix로 결합하는 UA-VLS의 계산 이득, SEU Loss의 보정 의미와 임상 적용 전 한계를 설명합니다.
- PhotoDoodle은 30~50쌍으로 스타일을 배울까: 배경 보존 구조와 실행 코드 함정 — PhotoDoodle의 OmniEditor 사전학습과 EditLoRA 미세조정, positional encoding cloning이 배경을 보존하는 방식, 비교, ablation 결과와 예제 코드의 해상도 주의점을 정리합니다.
- 서술형 의료 AI는 무엇으로 채점해야 하나: MediX-R1의 복합 보상 — MediX-R1이 객관식 일치 대신 LLM 판정, 의료 의미, 형식, 이미지 근거를 조합해 자유 응답을 학습하는 방법과 임상 적용 한계를 설명합니다.
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.