가능은 하지만, 두 대상이 초기 선을 함께 사용할 수 있는 구조를 가질 때에만 안정적입니다. Stroke of Surprise는 첫 그림을 고쳐 그리는 대신, 처음부터 나중 그림에도 남을 선을 공동 최적화하고 새 선이 기존 선을 덮지 않도록 제한합니다.
그림을 지우지 않고 토끼를 코끼리로 바꿀 수 있을까: Stroke of Surprise의 Prefix, Delta 최적화
왜 “앞선 선을 지우지 않는다”는 제약이 어려울까?
점진적 시맨틱 일루전(PSI)은 그림을 회전하거나 뒤집는 착시와 다릅니다. 그리는 순서 자체가 의미를 바꿉니다. Phase 1의 선만 보면 첫 대상이어야 하고, 여기에 선을 추가한 Phase 2는 두 번째 대상으로 읽혀야 합니다. 앞선 선은 수정하거나 삭제할 수 없습니다.
 래스터 편집, 순차 벡터 생성, 공동 최적화 방식의 차이.
래스터 방식은 최종 대상에 맞추며 초기 구조를 바꿀 수 있고, greedy 벡터 방식은 먼저 그린 세부가 나중 그림에서 잡음이 되기 쉽습니다. PSI의 핵심 질문은 “오리의 부리가 나중 대상의 어느 구조로 계속 쓰일 수 있는가”처럼 두 의미의 공통 골격을 찾는 것입니다.
왜 Prefix와 Delta를 동시에 학습할까?
획은 제어점, 두께, 투명도를 가진 베지에 곡선이며 DiffVG로 미분 가능한 이미지로 렌더링됩니다. 전체 획을 두 집합으로 나눕니다.
- $S_{\text{prefix}}$: 첫 단계에서 보이는 선
- $S_{\text{delta}}$: 두 번째 단계에서 추가되는 선
- $S_{\text{full}}=S_{\text{prefix}}\cup S_{\text{delta}}$: 최종 그림
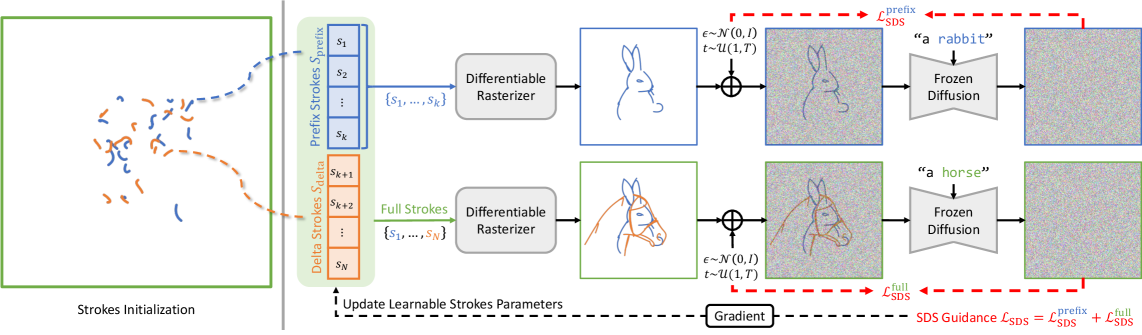 Prefix는 첫 프롬프트와 최종 프롬프트의 영향을 함께 받고, Delta는 최종 의미를 완성한다.
Stable Diffusion v1.5를 prior로 사용하는 이중 분기 Score Distillation Sampling(SDS)에서 prefix는 $\mathcal{L}{\text{SDS}}^{\text{prefix}}$와 $\mathcal{L}{\text{SDS}}^{\text{full}}$ 양쪽의 gradient를 받습니다. 즉 첫 그림만 잘 보이도록 먼저 확정한 뒤 두 번째 그림을 덧붙이는 것이 아닙니다. 처음 선을 정할 때부터 미래의 전체 그림까지 함께 계산합니다.
원문은 단계당 약 2,000회 최적화와 중앙 무작위 배치 또는 사전 학습 스케치 초기화를 언급합니다. 이는 한 번의 모델 forward로 그림이 나오는 생성기가 아니라, 프롬프트 쌍마다 벡터 파라미터를 반복 조정하는 절차입니다.
Overlay Loss는 어떻게 덮어쓰기 대신 여백을 만들까?
두 SDS loss만 합치면 delta 선이 prefix를 가려서 최종 대상만 맞히는 지름길이 생깁니다. 교차 여부만 막아도 선들이 아주 가까이 몰려 형태가 흐려질 수 있습니다.
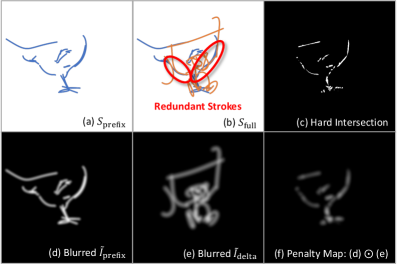 Blurred map으로 선 사이에 완충 영역을 만드는 Overlay Loss.
Overlay Loss는 prefix와 delta의 렌더링 맵을 Gaussian blur한 뒤 겹치는 영역에 penalty를 줍니다. blur가 실제 선보다 넓은 금지 구역을 만들기 때문에 새 선이 기존 선과 거리를 유지합니다. 다만 가중치가 너무 크면 필요한 접촉까지 막고, 너무 작으면 가림과 혼잡이 다시 생깁니다. 이 글의 원문에는 그 균형을 자동 선택하는 규칙이 없습니다.
좋은 최종 그림만으로 착시를 평가해도 될까?
최종 그림이 두 번째 프롬프트와 닮았더라도 delta만으로 완성되고 prefix가 불필요하다면 점진적 착시라고 보기 어렵습니다. 연구는 GPT-4o 기반 평가로 각 단계의 인식 가능성과 초기 선의 구조적 기여를 함께 묻습니다.
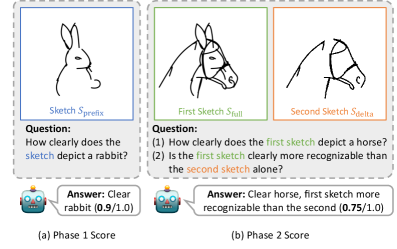 각 단계의 의미와 prefix 기여도를 함께 보는 VLM 평가.
SketchDreamer와 SketchAgent보다 높은 일루전 점수를 얻었다는 설명이 있지만, 이 글에는 절대 점수와 인간 평가 일치도가 없습니다. VLM이 두 대상을 알아봤다는 사실도 사람이 느끼는 전환의 놀라움이나 선의 미적 완성도와 동일하지 않습니다.
여러 단계에서는 누적 획 집합마다 별도 의미 손실을 둡니다.
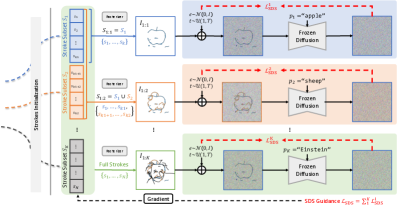 사과에서 양, 아인슈타인으로 이어지는 다단계 누적 획 구성.
단계가 늘면 각 의미를 동시에 만족해야 하므로 계산량과 구조 충돌도 함께 늘어납니다. 원문의 “선형적으로 증가”한다는 비용 설명은 loss와 단계 수의 관계를 말할 뿐, 최적화 난도가 선형이라는 보장은 아닙니다.
어떤 프롬프트 쌍을 먼저 골라야 할까?
이 방법이 잘 맞는 대상은 실루엣이나 주요 곡선을 공유하면서도, 몇 개의 선으로 의미가 분명하게 갈리는 조합입니다. 긴 기차와 둥근 공처럼 구조적 거리가 큰 쌍은 공통 비계를 찾기 어렵습니다. 각 단계의 획 수를 사용자가 미리 정해야 한다는 한계도 있습니다.
실제 제작에서는 다음 순서로 판단하는 편이 낫습니다.
- 두 대상의 공통 윤곽과 재사용 가능한 선을 먼저 스케치합니다.
- prefix 단독 인식률과 full 인식률을 따로 봅니다.
- delta만 렌더링해 최종 의미가 그대로 보이는지 확인합니다.
- 선 겹침, 여백, 단계별 최적화 시간을 기록합니다.
- SDS 특유의 과도한 단순화가 스타일 요구와 맞는지 검토합니다.
이 연구의 강점은 아무 대상이나 마법처럼 바꾸는 데 있지 않습니다. “먼저 그린 선이 나중에도 반드시 필요한가”를 학습 목표와 평가 항목으로 만든 데 있습니다.
단계별 착시가 실제로 성립하는지는 어떻게 확인할까?
평가할 때는 prefix, delta, full 세 그림을 따로 보여 줘야 합니다. Prefix만 본 사람은 첫 대상을 알아봐야 하고, full을 본 사람은 두 번째 대상을 알아봐야 합니다. Delta만으로 두 번째 대상이 그대로 읽힌다면 새 선이 앞선 선을 활용한 것이 아니라 사실상 별도 그림을 덧붙였을 가능성이 큽니다. 반대로 prefix가 너무 모호하면 최종 전환이 선명해도 첫 단계가 착시로 기능하지 않습니다.
표시 순서도 결과에 영향을 줍니다. 먼저 최종 그림을 본 평가자는 prefix에서도 두 번째 의미를 쉽게 찾아낼 수 있으므로, 단계별 인식률은 서로 다른 평가자에게 무작위 순서로 물어보는 편이 낫습니다. 대상 이름을 맞히는 비율 외에 전환이 자연스러운지, 새 선이 기존 선을 가렸는지, 어느 시점부터 두 번째 의미가 보였는지도 기록하면 VLM 점수 하나가 숨기는 품질 차이를 볼 수 있습니다.
실패 사례는 다시 최적화하기 전에 원인을 나눕니다. 두 대상의 공통 윤곽이 부족한지, 획 수가 부족한지, Overlay Loss가 접촉을 지나치게 막는지, SDS가 한 대상에만 끌리는지 구분해야 합니다. 구조가 맞지 않는 프롬프트 쌍을 반복 계산으로 밀어붙이면 시간만 늘고 복잡한 선 뭉치가 생길 수 있습니다. 작은 사람 평가에서 두 단계 모두 안정적으로 인식되는 조합만 제작 단계로 넘기는 것이 현실적인 중단 기준입니다.
최종 벡터 파일에서도 단계 제약이 유지되는지 확인해야 합니다. 렌더러가 바뀌거나 선 두께와 투명도가 변하면 화면에서는 떨어져 있던 획이 겹쳐 보일 수 있습니다. Prefix와 full을 동일한 확대 비율, 배경, 선 스타일로 다시 출력하고, SVG 요소 순서가 바뀌어 기존 선 위에 새 선이 덮이지 않는지 검사합니다. 제작 환경에서 재현되지 않는 착시는 최적화 점수가 높아도 배포 가능한 결과로 보기 어렵습니다.
함께 읽으면 이해가 이어지는 글
- 물을 채우고 금속을 구부리는 편집은 왜 어려울까: PhysicEdit — PhysicEdit이 3.8만 전이 데이터와 시각, 텍스트 이중 조건으로 물리적 상태 변화를 편집하는 방식, 보고 성과와 합성 데이터, 지연 한계를 분석합니다.
- 이미지 편집 후보를 많이 뽑을수록 좋을까? ADE-CoT의 조기 중단 — ADE-CoT가 편집 난이도에 따라 후보 수를 바꾸고 실패 후보를 일찍 제거하는 방식, Best-of-N 대비 속도 이득과 검증 모델 의존성을 살펴봅니다.
- UniTok은 이미지 생성과 이해를 둘 다 잘할까: rFID 0.38과 정확도 78.6의 의미 — UniTok이 단일 대형 코드북 대신 Multi-Codebook Quantization을 쓰는 이유와 이미지 재구성, 비전 언어 이해를 한 토큰으로 연결하는 방식, 벤치마크의 생성, 이해 trade-off를 정리합니다.
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.