AVControl은 동결한 LTX-2에 모달리티별 LoRA를 학습해 제어 추가 비용을 줄이지만, Parallel Canvas의 제어 토큰이 늘리는 attention 연산까지 없애 주지는 않습니다. 따라서 도입 여부는 어댑터 파일 크기가 아니라 원하는 제어 충실도와 동기화 품질을 얻는 데 드는 전체 학습, 추론 비용으로 판단해야 합니다.
AVControl은 LoRA 하나로 Audio, Video 제어를 끝낼까: Parallel Canvas 비용
백본을 복제하지 않고 제어 신호를 옆에 놓는다
기존 제어 방식은 깊이, 포즈나 에지 같은 조건을 추가할 때 큰 제어 브랜치를 붙이거나 입력 구조를 바꾸는 비용이 생길 수 있습니다. AVControl은 joint audio-visual backbone인 LTX-2를 동결하고, 참조, 제어 신호를 별도 캔버스의 토큰으로 다룹니다.
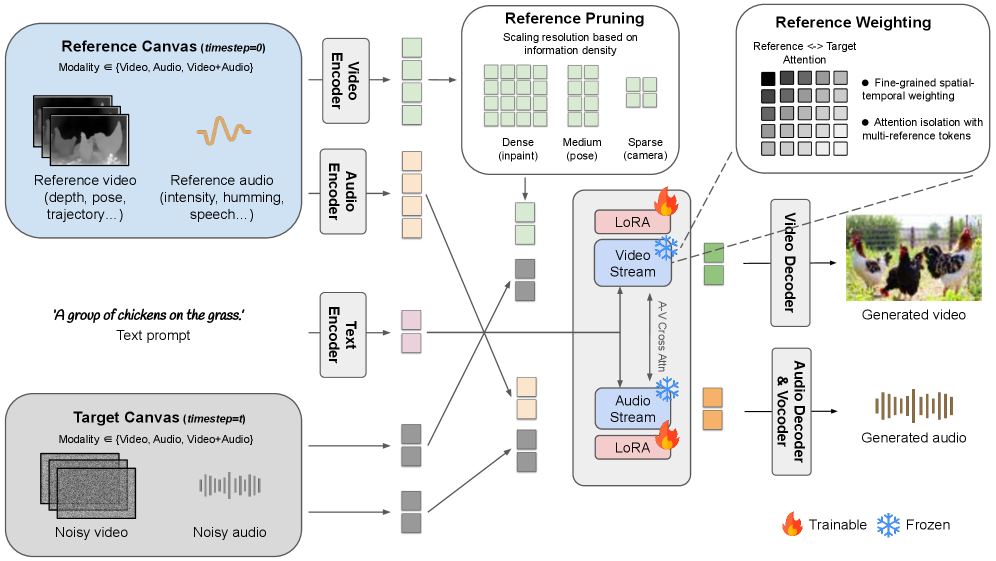
Parallel Canvas 토큰은 self-attention에서 추가 key와 value로 참여합니다. 백본 전체를 다시 학습하지 않고 LoRA 파라미터만 업데이트하므로 모달리티별 어댑터를 분리할 수 있습니다. 깊이, 포즈, 카메라, 오디오나 Canny 조건을 추가할 때 같은 백본을 공유한다는 점이 실용적 장점입니다.
여기서 “LoRA 하나”는 모든 제어를 자동으로 해결하는 만능 어댑터라는 뜻이 아닙니다. 원문 설명대로 각 모달리티가 자신의 LoRA를 통과한다면 데이터와 학습, 조합 검증도 모달리티별로 필요합니다.
제어 토큰은 언제 도움이 되고 언제 서로 충돌할까
제어 신호를 별도 캔버스에 둔다는 것은 원본 생성 토큰을 덮어쓰지 않고 참고할 정보를 attention에 추가한다는 뜻입니다. 깊이 지도는 공간 구조를, Canny 에지는 윤곽을, 포즈는 관절 위치를 강조하므로 같은 장면에서도 요구하는 제약이 다릅니다. 한 가지 조건만 쓸 때는 무엇을 따라야 하는지 비교적 명확하지만, 조건을 동시에 넣으면 서로 다른 신호가 같은 영역을 다른 방향으로 끌 수 있습니다. 깊이에는 맞지만 에지와 어긋나는 입력처럼 조건 자체가 불일치하면 모델의 결함인지 입력 충돌인지부터 구분해야 합니다.
오디오와 비디오는 공간 정렬뿐 아니라 시간축 정렬이 필요합니다. 제어 오디오의 짧은 타격 시점과 영상의 동작 프레임이 어긋난 상태로 학습되면, 모델은 평균적인 분위기는 맞추면서도 사건의 정확한 순간을 놓칠 수 있습니다. 재현 데이터에는 원본 프레임률, 오디오 샘플 구간, 클립 시작, 끝 위치를 함께 보존하고 전처리 후 길이가 달라졌는지 검사해야 합니다. padding과 mask가 잘못되면 빈 구간까지 유효한 제어로 읽힐 수 있으므로 텐서 크기만 맞는다고 정렬이 맞았다고 볼 수 없습니다.
조건 조합을 평가할 때는 단일 제어 기준선을 먼저 남깁니다. 깊이만, 에지만, 오디오만 넣은 결과와 두 조건을 섞은 결과를 같은 seed와 클립에서 비교하면 조합 때문에 생긴 이득과 손실을 분리할 수 있습니다. 여러 제어를 넣었는데 한 종류의 지표만 좋아진다면 “다중 제어 성공”이 아니라 우선순위가 한쪽으로 쏠린 결과일 수 있습니다.
의사 코드는 실제 AVControl API가 아니다
원문 코드는 기본 비디오 토큰에서 query, key, value를 만들고, 제어 토큰의 key, value를 이어 붙인 다음 LoRA 출력을 더하는 개념을 보여 줍니다. 하지만 get_qkv, calculate_attention과 실제 모델 인터페이스가 정의되지 않았고, 텐서 shape, mask, gradient 설정과 학습 루프도 없습니다.
특히 백본을 torch.no_grad()로 감싸고 마지막에 LoRA를 단순히 더하는 표현은 설명용 단순화입니다. 이를 저장소의 정확한 구현이나 그대로 실행 가능한 학습 코드로 사용해서는 안 됩니다. 재현할 때는 어느 attention 층에 LoRA가 붙는지, audio와 video 토큰의 시간 정렬 및 mask가 어떻게 구성되는지를 실제 구현에서 확인해야 합니다.
학습 파라미터가 작아도 attention은 길어진다
원문은 제어 종류에 따라 200~15,000 학습 스텝 범위를 제시합니다. 이는 특정 데이터와 설정의 보고값이지 새 모달리티가 항상 그 안에서 수렴한다는 보장은 아닙니다. “점심시간에 학습 완료”처럼 하드웨어와 데이터 양을 생략한 시간 약속으로 바꿔 읽으면 안 됩니다.
Parallel Canvas는 백본 복제 메모리를 줄이는 대신 attention이 보는 토큰 수를 늘립니다. 비디오 토큰을 $N$, 제어 토큰을 $C$라 하면 실제 비용은 층과 구현에 따라 달라지지만, $N+C$가 커질수록 attention의 메모리와 계산이 빠르게 증가합니다. 긴 영상, 높은 해상도와 여러 제어를 동시에 쓰면 LoRA 파라미터 크기만 보고 예상한 것보다 큰 VRAM 피크가 생길 수 있습니다.
측정할 때는 다음을 함께 기록해야 합니다.
- 제어 토큰 추가 전후의 최대 VRAM과 생성 시간
- 모달리티 하나와 여러 개를 조합했을 때의 품질
- 학습 스텝별 제어 충실도와 원본 품질 저하
- audio event와 video event 사이의 시간 오차
- 길이와 해상도를 늘렸을 때 OOM 경계
학습 파라미터 수와 학습 메모리도 분리해서 기록해야 합니다. 백본을 동결하면 그 가중치의 gradient와 optimizer state는 줄일 수 있지만, forward 과정의 activation과 추가된 attention 행렬은 여전히 메모리를 사용합니다. LoRA rank를 낮춰 저장 파일이 작아져도 제어 토큰 수가 그대로라면 추론 시 attention 비용은 크게 줄지 않을 수 있습니다. 반대로 토큰을 지나치게 압축하면 비용은 줄지만 작은 움직임이나 세밀한 윤곽이 사라질 수 있습니다.
공정한 비교를 위해 기본 LTX-2와 AVControl을 동일한 해상도, 프레임 수, 정밀도, 배치 크기에서 측정합니다. 최대 VRAM만 보지 말고 첫 클립 지연, 클립당 처리 시간과 여러 요청을 연속 실행했을 때의 처리량도 남깁니다. 학습에서는 데이터 로딩 시간을 제외한 step 시간과 포함한 전체 시간을 나누면 모델 연산과 전처리 병목을 구별할 수 있습니다.
결과 그림에서 확인해야 할 두 가지
첫째는 제어 충실도입니다. Canny나 depth 윤곽을 잘 따르면서도 영상의 질감과 움직임이 자연스러운지 봐야 합니다. 보기 좋은 한 장면보다 전체 클립에서 구조가 유지되는지가 중요합니다.
둘째는 audio-video 동기화입니다. 큰 동작과 음악 분위기가 맞는 것과, 타격, 입 모양처럼 짧은 이벤트가 정확한 시점에 맞는 것은 다른 평가입니다. 원문도 극단적인 미세 동기화는 더 검증해야 할 한계로 남깁니다. 팀의 사용 사례가 어느 수준의 싱크를 요구하는지 먼저 정해야 합니다.
한 개의 보기 좋은 예시만으로는 시간 안정성을 판단하기 어렵습니다. 클립 앞부분에서는 조건을 따르다가 뒤에서 인물 형태나 배경이 흔들릴 수 있고, 빠른 카메라 이동에서 제어가 뒤늦게 반영될 수도 있습니다. 결과를 일정한 간격의 프레임으로 펼쳐 구조가 유지되는지 보고, 짧은 이벤트에는 기대 시점과 실제 시점의 차이를 기록합니다. 사람이 평가한다면 제어 충실도, 자연스러움, 시간 안정성, 동기화를 별도 항목으로 채점해야 한 항목의 인상이 나머지를 가리지 않습니다.
실패도 유형별로 보관할 가치가 있습니다. 입력 조건을 거의 무시한 실패, 조건은 따르지만 영상 품질이 무너진 실패, 두 모달리티가 각자 자연스럽지만 서로 맞지 않는 실패는 수정 지점이 다릅니다. 첫 번째는 어댑터 학습이나 조건 강도, 두 번째는 데이터 품질과 백본 보존, 세 번째는 시간 정렬을 우선 의심할 수 있습니다. 이 분류 없이 평균 점수만 보면 다음 실험에서 무엇을 바꿔야 할지 알기 어렵습니다.
작은 모달리티 하나로 재현한다
처음에는 기존 데이터가 있는 한 제어 유형만 고르고, 고정된 LTX-2 기준선과 LoRA 설정을 비교하십시오. 짧은 저해상도 클립에서 학습 곡선과 VRAM을 확인한 뒤 길이, 해상도와 두 번째 제어를 하나씩 추가합니다. 여러 모달리티를 처음부터 섞으면 품질 저하의 원인을 찾기 어렵습니다.
재현 순서는 네 단계면 충분합니다. 먼저 전처리된 조건과 목표 영상이 같은 프레임 수와 시간 범위를 갖는지 사람이 확인합니다. 다음으로 동결해야 할 백본 파라미터에 gradient가 생기지 않고 LoRA만 저장되는지 점검합니다. 그다음 단일 제어에서 조건 없는 기준선보다 충실도가 실제로 높아지는지 비교합니다. 마지막으로 두 조건을 합치고, 단일 조건의 장점이 유지되는지와 VRAM 증가를 함께 봅니다.
중단 기준도 미리 정해야 합니다. 낮은 해상도의 짧은 클립에서도 조건을 안정적으로 따르지 못하거나, 단일 제어를 추가했을 뿐인데 원본 생성 품질이 반복해서 크게 떨어진다면 스텝을 늘리기 전에 데이터와 정렬을 다시 봐야 합니다. 목표 장치의 메모리를 초과한다면 LoRA rank만 줄이지 말고 제어 토큰 길이와 입력 해상도부터 조정해야 합니다. 두 조건 조합이 단일 조건보다 계속 나쁘다면 모든 모달리티를 한 모델에 억지로 넣는 대신 어댑터를 작업별로 분리하는 선택도 남겨 둡니다.
AVControl은 백본을 매번 복제하거나 전부 재학습하는 부담을 줄이는 설계입니다. 그렇다고 데이터 준비, attention 최적화와 시간 동기화 문제가 사라지는 것은 아닙니다. LoRA 파일 크기가 아니라 목표 품질을 얻는 총 학습, 추론 비용으로 판단해야 합니다.
자료:
- Link: https://arxiv.org/abs/2603.24793
- Original Paper Link
함께 읽으면 이해가 이어지는 글
- 이미지, 오디오를 모두 다음 토큰으로 만들면 더 단순할까? LongCat-Next의 비용 — DiNA와 dNaViT가 텍스트, 이미지, 오디오를 이산 토큰으로 통합하는 방식, 단일 목적 함수의 이점과 시퀀스, KV 캐시 비용 및 검증법을 살펴봅니다.
- AI ASMR 진짜, 가짜 판별, VLM 정확도가 56%에 그친 이유: 워터마크 편향 — Video Reality Test에서 인간과 VLM이 AI ASMR을 가르는 단서, 오디오가 준 제한적 도움, 워터마크 제거 후 성능 하락이 벤치마크 해석에 주는 경고를 정리합니다.
- 영상, 음성 Token을 똑같이 줄이면 왜 안 될까? OmniSIFT의 비대칭 압축 — OmniSIFT가 video의 시공간 중복을 먼저 줄이고 남은 visual anchor로 audio token을 고르는 STVP, VGAS 구조, 75% 압축 결과와 화면 밖 소리를 잃는 한계를 정리합니다.
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.