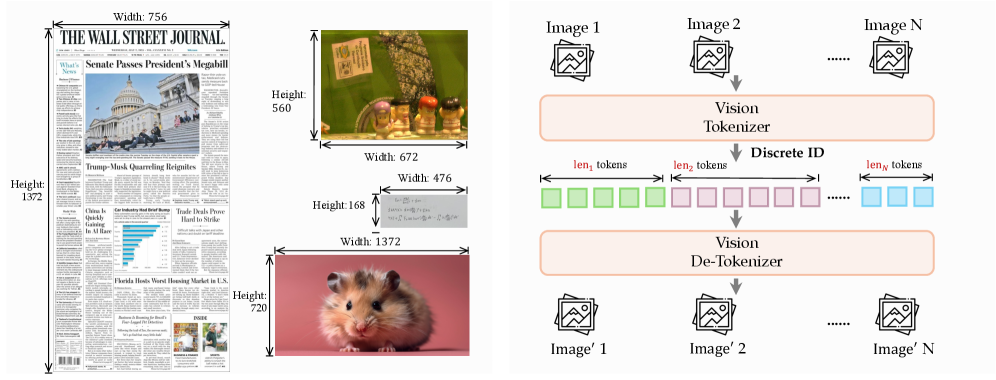
텍스트, 이미지, 오디오를 모두 이산 토큰으로 바꾸면 학습 목적은 단순해지지만, 고해상도 신호가 긴 시퀀스로 바뀌어 추론 비용까지 자동으로 줄지는 않습니다. LongCat-Next의 장점과 병목은 같은 선택, 즉 모든 모달리티를 next-token prediction으로 통일한 데서 나옵니다.
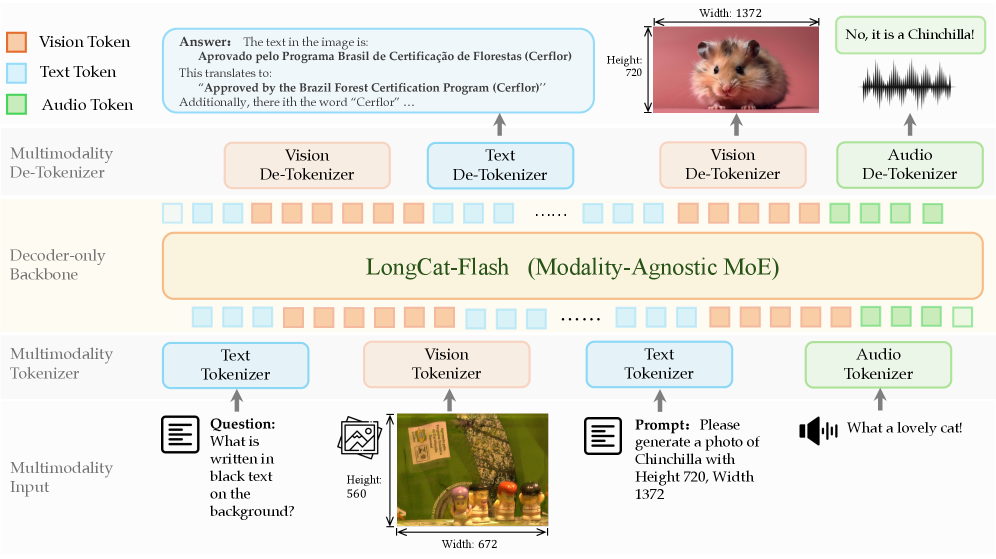
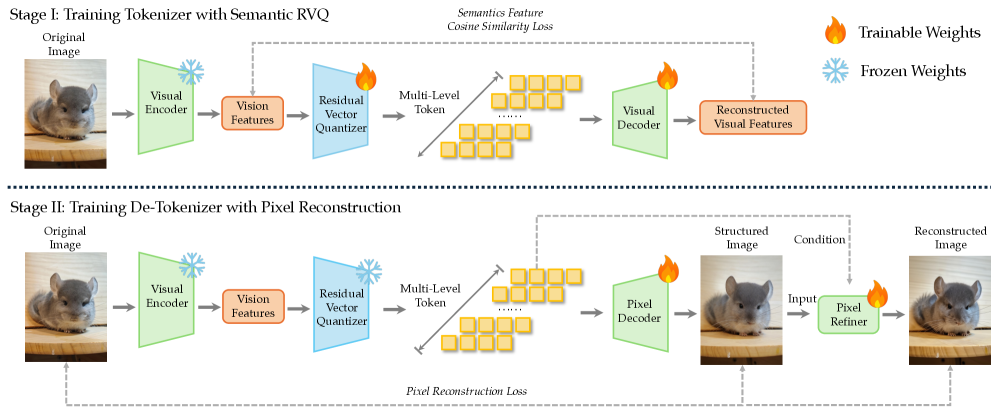
LongCat-Next 자료는 LLM, 비전 인코더, diffusion 생성기를 따로 이어 붙이는 대신 DiNA(Discrete Native Autoregressive) 구조를 제안합니다. 텍스트와 시각, 음향 신호를 공통 토큰 흐름으로 만들어 하나의 Transformer가 다음 토큰을 예측합니다.