긴 영상의 배경음악을 장면 변화에 맞추려면 전체 장르를 붙드는 전역 신호와 순간의 긴장도를 바꾸는 시간 신호가 모두 필요하며, NarraScore는 이를 두 개의 주입 경로로 분리합니다. 영상 전체의 의미는 Global Semantic Anchor가, 시점별 감정 변화는 Token-Level Affective Adapter가 맡습니다. 다만 두 축의 감정 곡선과 자동 지표가 음악의 예술적 적합성을 모두 설명하지는 못하므로 사람의 장면별 청취 평가가 필요합니다.
긴 영상 배경음악이 장면 감정을 놓칠 때: NarraScore의 이중 제어
왜 영상 감정을 두 개의 축으로 줄일까?
NarraScore는 Valence와 Arousal을 영상과 음악 사이의 공통 제어 신호로 사용합니다. Valence는 긍정과 부정의 방향, Arousal은 차분함과 격렬함의 강도를 나타냅니다. 사전학습된 VLM을 고정한 채 영상 프레임에서 이 연속 곡선을 뽑아 음악의 시간 변화에 연결합니다.
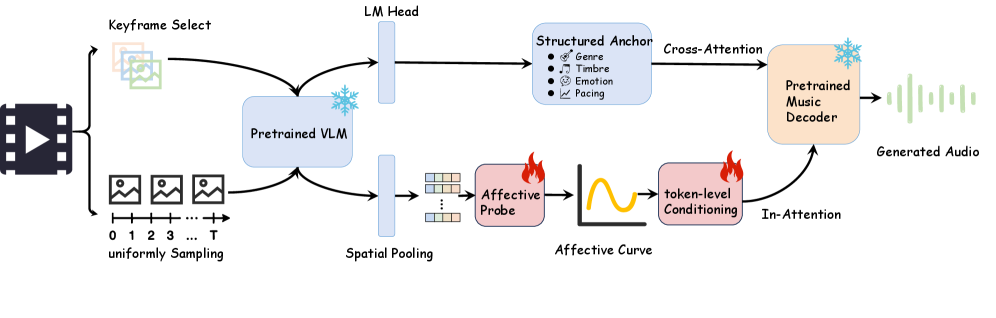
원문은 프레임을 약 1 FPS로 샘플링하고 보간해 오디오 토큰의 시간 해상도에 맞추는 구성을 설명합니다. 짧은 놀람이나 빠른 컷은 이 간격 사이에서 사라질 수 있으므로, 대상 영상의 편집 속도에 맞춰 감정 추출 간격을 검토해야 합니다.
두 축을 쓰면 서로 다른 길이의 영상과 음악을 연속적인 신호로 맞출 수 있습니다. 장면마다 자유로운 감정 문장을 만드는 것보다 수치 곡선은 보간과 시간 정렬이 쉽고, 음악 토큰에 반복해서 주입하기도 편합니다. 대신 “왜 이 장면이 슬픈가” 같은 의미와 특정 악기, 화성 선택은 두 숫자만으로 직접 표현되지 않습니다.
1 FPS 샘플링에서는 한 프레임 사이에 여러 컷이 지나갈 수 있습니다. 감정 곡선이 부드럽더라도 원본의 짧은 충격이나 갑작스러운 반전이 사라졌다면 음악은 늦게 반응할 수 있습니다. 적용 전에 곡선을 영상 위에 겹쳐 보고 중요한 전환점의 방향과 시점이 사람이 본 서사와 맞는지 확인해야 합니다.
전역 앵커와 토큰 어댑터는 어떻게 역할을 나눌까?
Global Semantic Anchor는 영상 전체의 분위기를 요약해 악기 구성이나 기본 스타일이 중간에 갑자기 바뀌는 것을 억제합니다. Token-Level Affective Adapter는 시점별 V-A 값을 음악 잠재 토큰에 잔차 형태로 주입해 긴장과 이완의 변화를 따라가게 합니다.
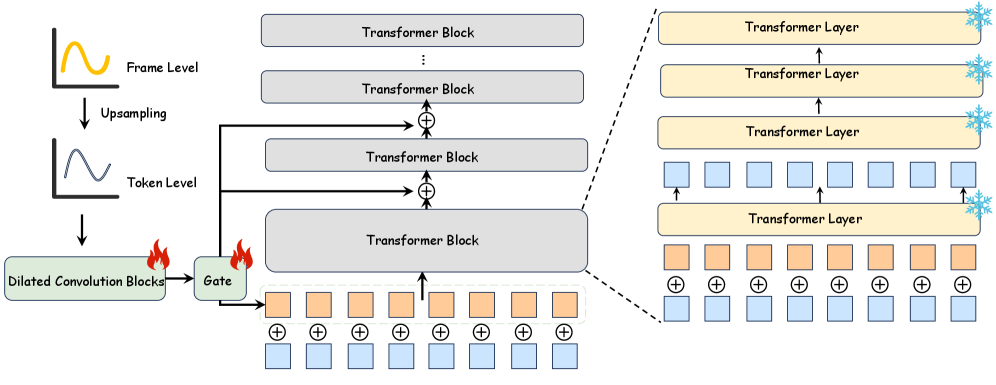
기본 오디오 생성기는 AudioLDM, 시각 특징 추출기는 CLIP ViT-L/14로 소개됩니다. 전체 모델을 다시 학습하기보다 감정 어댑터를 미세조정하는 선택은 데이터와 계산 요구를 줄이지만, 기본 오디오 모델의 음질과 악기 분리 한계도 함께 물려받습니다.
전역 신호만 쓰면 곡의 스타일은 유지되지만 장면별 긴장 변화가 평평해질 수 있습니다. 반대로 토큰 수준 신호만 강하게 쓰면 매 순간의 곡선을 따라가느라 음악의 주제와 악기 구성이 흔들릴 수 있습니다. 두 경로의 목적은 전역 일관성과 국소 반응성을 동시에 다루는 데 있습니다.
잔차 주입은 기존 오디오 표현을 완전히 바꾸지 않고 감정 조건을 더하는 방식입니다. 이 구조가 기본 생성기의 장점을 보존할 가능성은 있지만, 입력 감정이 잘못되면 그 오류도 시간축 전체에 주입됩니다. 어댑터의 강도를 높일수록 감정 추종이 좋아지는지와 음질, 음악적 자연스러움이 함께 유지되는지를 봐야 합니다.
“좋은 음악”과 “장면에 맞는 음악”을 어떻게 나눠 평가할까?
연구는 FAD로 오디오 품질을, Image-Audio Alignment로 영상과 소리의 대응을, Emotion Consistency로 의도한 감정 곡선의 추종 정도를 살핍니다. M2UGen과 Co-musi 같은 기준선과 비교하며 긴 영상의 서사 정렬 개선을 보고합니다.
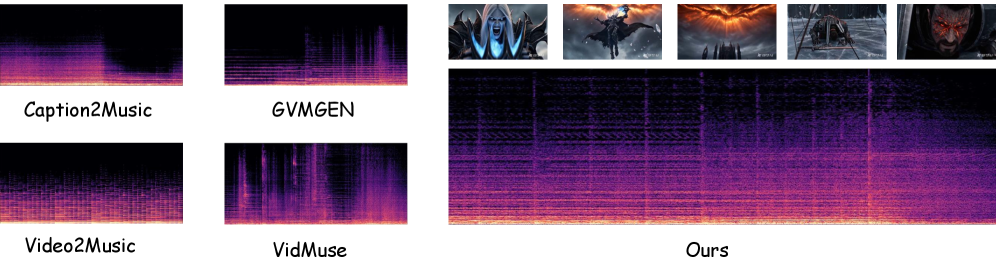
세 점수는 서로 대체할 수 없습니다. 감정 곡선을 정확히 따라도 음악이 반복적일 수 있고, 음질이 좋아도 중요한 장면 변화가 늦게 반영될 수 있습니다. 실제 검토에서는 전환 시점의 오차, 곡 전체의 반복, 장면별 사람 선호를 함께 기록해야 합니다.
FAD가 낮고 음질이 자연스러워도 영상과 무관한 곡일 수 있으며, 정렬 점수가 높아도 감정의 방향을 사람이 다르게 느낄 수 있습니다. Emotion Consistency가 높다는 사실도 입력 V-A 곡선 자체가 타당할 때만 의미가 있습니다. 따라서 감정 추출과 음악 생성의 오류를 하나의 점수로 합치지 않는 편이 좋습니다.
실전 평가는 같은 영상에 여러 음악을 붙이고 장면 전환의 타이밍을 모른 채 비교할 수 있습니다. 전체 선호뿐 아니라 “긴장이 시작된 시점”, “분위기가 과하게 바뀐 지점”, “반복이 느껴진 구간”을 표시하면 자동 지표가 놓친 원인을 찾기 쉽습니다. 긴 영상에서는 초반만 듣지 말고 전역 스타일이 끝까지 유지되는지도 확인해야 합니다.
V-A가 놓치는 감정 때문에 언제 적용을 보류해야 할까?
두 축은 계산하기 쉽지만 같은 낮은 각성에서도 슬픔과 평온은 다른 화성, 악기 선택을 요구할 수 있습니다. VLM이 특정 문화권의 표정과 장면 문법을 중심으로 감정을 판단하면 다른 문화적 맥락도 잘못 읽을 수 있습니다. 자동 생성 음악을 최종 납품물로 쓰려면 저작권과 사용 조건도 별도로 검토해야 합니다.
NarraScore는 긴 영상용 가이드 트랙이나 편집 초안에 유용한 연구 방향을 제시하지만, 이 글에는 실행 코드가 없습니다. 대상 영상에서 감정 곡선을 먼저 시각화해 사람이 납득하는지 확인하고, 곡의 예술적 완성도는 별도 청취 평가로 판단해야 합니다.
장르와 문화적 맥락이 중요한 작품에서는 같은 V-A 위치에 여러 음악적 해석이 가능합니다. 감정 곡선은 맞는데 인물이나 시대 배경과 어울리지 않는 악기가 선택된다면 자동 정렬만으로 해결하기 어렵습니다. 짧은 컷이 많은 영상에서 주요 전환이 계속 누락되거나, 슬픔과 평온처럼 같은 축 위치의 감정을 구별하지 못한다면 최종 음악 생성기로 쓰기보다 참고 신호로 제한해야 합니다.
반대로 긴 설명 영상이나 초안 편집처럼 전체 분위기를 유지하면서 큰 장면 변화에 맞춘 가이드 트랙이 필요하다면 비교 실험할 수 있습니다. 전역 일관성, 전환 시점, 음질, 반복, 사람 선호를 같은 영상에서 평가하고 저작권, 사용 조건까지 확인해야 도입 여부를 판단할 수 있습니다. NarraScore의 강점은 감정을 완벽히 해석하는 데 아니라 전역과 국소 제어를 분리해 조정 가능하게 만든 데 있습니다.
편집자에게 어떤 중간 결과를 보여 줘야 할까?
완성 음악만 전달하면 잘못된 감정 해석과 음악 생성 오류를 구분하기 어렵습니다. 영상 위에 시점별 Valence와 Arousal 곡선을 겹쳐 보여 주면 편집자는 중요한 전환이 어디에 잡혔는지 먼저 확인할 수 있습니다. 곡선이 틀리면 음악을 다시 만들기 전에 감정 입력부터 수정해야 합니다.
전역 분위기와 토큰 어댑터의 변화 강도도 별도로 관리할 수 있습니다. 전체 장르는 맞지만 장면 반응이 약하면 국소 제어를 조정하고, 매 장면마다 음악이 흔들리면 전역 일관성을 우선하는 식입니다. 두 제어를 한 슬라이더처럼 합치면 수정 이유를 찾기 어렵습니다.
비교 청취에서는 기준 음악과 생성 결과의 음량을 맞추고 장면 순서를 유지해야 합니다. 한 구간만 잘라 들으면 긴 영상에서 반복과 스타일 붕괴를 놓칠 수 있습니다. 편집자가 표시한 전환점과 실제 음악 변화 사이의 지연을 기록하면 감정 곡선을 따르는 정도를 더 구체적으로 판단할 수 있습니다.
자동 생성 결과는 초안으로 남기고 최종 사용 전 사람의 음악적 판단과 권리 검토를 거쳐야 합니다. V-A 곡선을 사람이 납득하지 못하거나 같은 장면에서 부적절한 악기가 반복되면 제어 신호만으로 해결하기 어렵습니다. 이때는 수동 음악 선택이나 더 구체적인 창작 지시가 나을 수 있습니다.
감정 곡선 수정 내역을 보관하면 다음 프로젝트에서 같은 장면 문법의 오류를 찾을 수 있습니다. 빠른 컷에서 각성도가 항상 늦게 오르거나 특정 표정을 부정 감정으로 반복 오인한다면 샘플링과 VLM 해석을 따로 점검해야 합니다. 완성 음악만 보관하면 이런 원인을 재현하기 어렵습니다.
영상 길이가 달라질 때도 같은 보간 설정을 그대로 쓰지 않습니다. 짧은 광고와 긴 서사 영상은 중요한 전환의 밀도가 다르므로 1 FPS가 놓치는 사건의 비율도 달라집니다. 실제 편집점과 감정 곡선의 꼭짓점을 비교해 필요한 시간 해상도를 정해야 합니다.
가이드 트랙을 사람이 다시 편곡한다면 어느 구간의 감정 변화가 자동 제어에서 왔는지 표시할 수 있습니다. 편집자가 유효한 부분만 재사용하고 어색한 전환을 교체하기 쉬워집니다. 최종 창작물을 자동 점수로 확정하기보다 수정 가능한 초안으로 제공할 때 두 제어 경로가 더 실용적입니다.
감정 제어가 장면의 이야기 구조와 맞는지는 전환 지점에서 따로 봐야 합니다. 전체 음악의 분위기는 맞아도 대사 중간에 강도가 갑자기 바뀌거나 장면 전환보다 늦게 반응하면 편집에는 쓰기 어렵습니다. 편집자에게 감정 곡선, 사용한 전역 앵커, 국소 토큰 변화와 해당 타임코드를 함께 보여 주면 어디를 고쳐야 하는지 찾기 쉽습니다. 사람 평가에서는 음악 자체의 선호도와 영상에 대한 적합도를 별도 질문으로 두어 익숙한 장르에 대한 취향이 정렬 점수를 대신하지 않게 해야 합니다.
함께 읽으면 이해가 이어지는 글
- 이미지, 오디오를 모두 다음 토큰으로 만들면 더 단순할까? LongCat-Next의 비용 — DiNA와 dNaViT가 텍스트, 이미지, 오디오를 이산 토큰으로 통합하는 방식, 단일 목적 함수의 이점과 시퀀스, KV 캐시 비용 및 검증법을 살펴봅니다.
- AI 규제 문서가 흩어져 있다면? AI Atlas Nexus로 리스크 연결하는 법 — AI Atlas Nexus가 NIST, MIT, EU AI Act의 리스크를 공통 지식 그래프로 연결하는 방식과 LLM 매핑을 사람의 검토 없이 확정하면 안 되는 이유를 정리합니다.
- Suno AI 음원에 워터마크 도입… 대량 다운로드 제한과 저작권 모니터링 강화 — Suno가 AI로 생성된 음원의 출처를 확인할 수 있는 비가청 오디오 워터마크와 핑거프린팅 기술을 도입한다고 발표했습니다. 음원 유통 스트리밍 서비스에 대한 무단 대량 배포를 막기 위한 다운로드 제한 정책 및 Musixmatch와의…
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.