포스트

5초 영상으로 120초를 만들 수 있을까? PackForcing의 4GB KV 조건

PackForcing은 논문 설정에서 약 5초 학습 클립으로 120초 영상을 생성하고 KV 캐시를 약 4GB로 제한했지만, 모든 장면이 2분 동안 정확히 유지된다는 보장은 아닙니다. 핵심은 긴 과거를 그대로 저장하지 않고 역할에 따라 보존, 압축, 선택하는 데 있습니다.

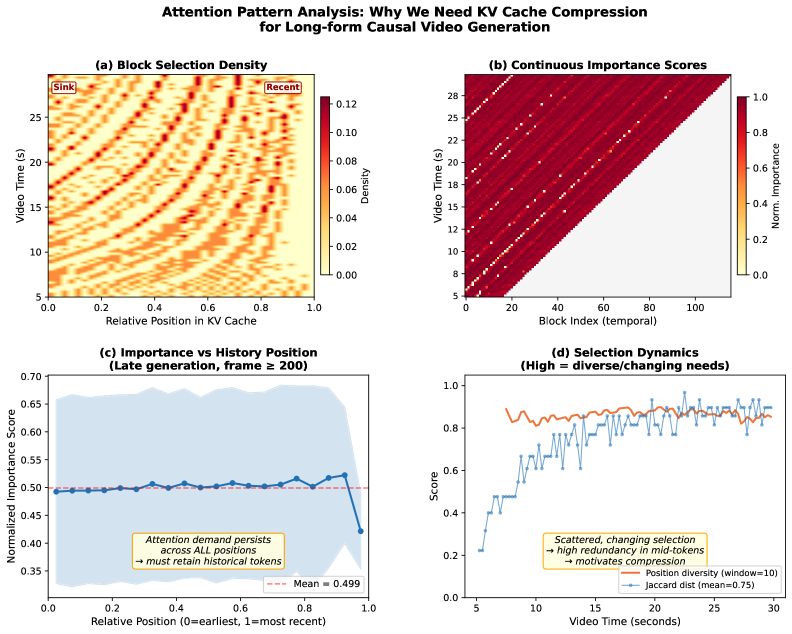
논문 자료는 causal video generation에서 프레임이 늘수록 KV 캐시가 선형으로 커지는 문제를 다룹니다. PackForcing은 과거 토큰을 Sink, Mid, Recent 세 구간으로 나누고 각기 다른 해상도와 보존 규칙을 적용합니다.
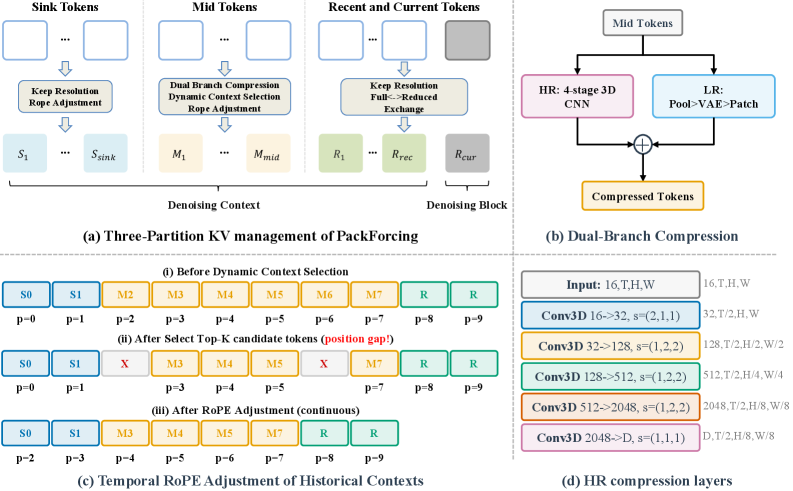
Sink, Mid, Recent로 나눈 PackForcing 구조

처음과 최근은 선명하게, 중간 과거는 압축한다

Sink 토큰은 영상 초반의 인물과 배경을 앵커로 남깁니다. Recent 토큰은 직전 움직임을 이어야 하므로 압축하지 않습니다. 가장 긴 Mid 구간은 3D CNN과 저해상도 VAE를 결합한 dual-branch compressor로 32배 줄입니다.

압축한 Mid 토큰도 모두 쓰지 않습니다. 현재 쿼리에 중요한 후보를 Dynamic Top-K로 골라 캐시 상한을 지킵니다. 토큰을 제거한 뒤 생기는 시간 위치의 빈틈은 Temporal RoPE Adjustment로 다시 정렬합니다. FIFO처럼 오래됐다는 이유만으로 버리는 대신, 시작 설정과 현재에 관련된 과거를 남기는 전략입니다.

긴 과거에서 실제로 참조되는 희소한 어텐션

120초와 4GB는 H200 평가 조건 안의 숫자다

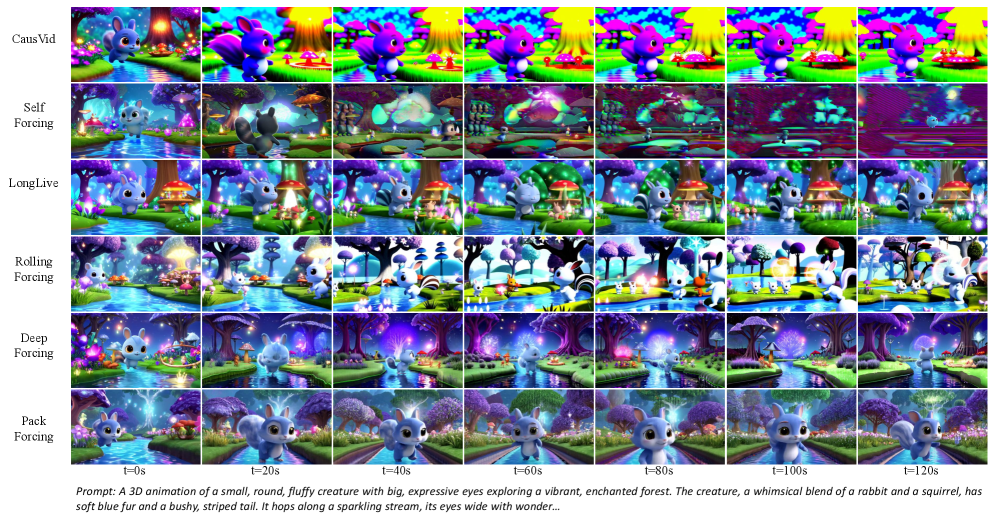
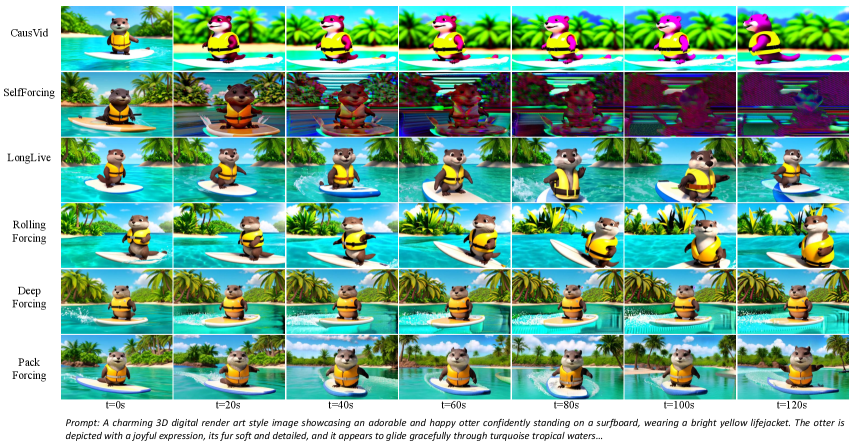
원문 표는 H200, 16 FPS 조건에서 KV 캐시 약 4GB와 120초 이상 생성을 제시합니다. VBench 일관성 점수도 PackForcing 26.07, Rolling-Forcing 22.45, DeepForcing 24.12로 소개합니다. 비교 결과는 동일한 모델, 해상도, 평가 절차 안에서 읽어야 합니다.

120초 지점의 모델별 생성 결과 비교

짧은 클립으로 학습했다는 말은 긴 영상 데이터가 언제나 불필요하다는 뜻이 아닙니다. 모델은 긴 시간에만 나타나는 서사 변화와 상태 전이를 직접 학습하지 못할 수 있습니다. 메모리 크기를 닫아도 생성 오류가 반복 입력되며 누적되는 문제는 남습니다.

압축에서 사라지는 디테일을 따로 찾는다

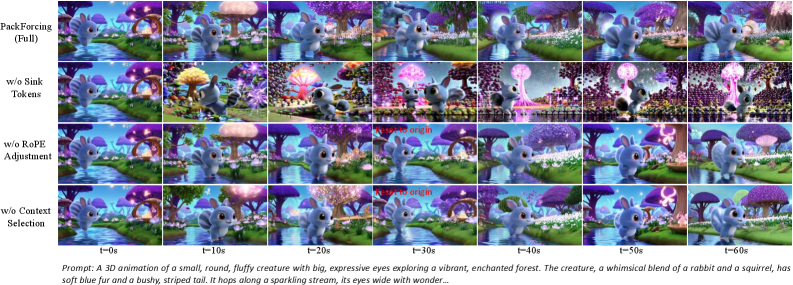
32배 Mid 압축은 비, 연기, 작은 표정처럼 오래된 미세 움직임을 잃을 수 있습니다. Top-K가 현재 장면과 겉보기에 비슷한 잘못된 과거를 고르면 인물이나 물체가 갑자기 바뀔 수도 있습니다. Sink가 초반 상태를 강하게 붙들면 의도한 장면 변화까지 방해할 가능성도 있습니다.

Sink와 RoPE 구성 요소를 뺀 제거 실험

원문의 파이썬 클래스는 세 구간과 Top-K 흐름을 설명하는 의사 코드입니다. query, sink, 실제 compressor와 gather 차원이 정의되지 않아 실행 가능한 구현이 아닙니다. 공개 코드와 체크포인트가 같은 설정을 제공하는지 확인하기 전에는 프로덕션 적용 절차로 사용할 수 없습니다.

PoC는 길이보다 시간대별 품질 곡선을 본다

검증할 때 5초, 30초, 60초, 120초 구간에서 인물 정체성, 배경 구조, 움직임 반복, 프롬프트 반영을 따로 채점합니다. 캐시 메모리와 FPS도 같은 시점에 기록해 고정 상한이 실제 장치에서 유지되는지 봅니다. H200 결과를 다른 GPU나 60 FPS 요구에 그대로 옮기면 안 됩니다.

최대 120초 생성이 가능한 프레임워크 개요

PackForcing은 “모든 과거를 보관해야 장기 일관성이 생긴다”는 가정을 깨는 유용한 메모리 설계입니다. 그러나 광고, 자율주행 합성 데이터에 쓰려면 시각적 자연스러움 외에 물체 상태와 물리 사건의 정확성을 별도로 검증해야 합니다.

메모리 상한과 장기 이해는 같은 문제가 아니다

KV 캐시가 4GB 부근에 머문다는 것은 계산 자원의 경계를 닫았다는 뜻이지, 2분 전 사건을 완전히 이해한다는 뜻은 아닙니다. 시작 장면과 최근 움직임은 비교적 선명하게 남아도 Mid 구간의 세부 사건은 압축 과정에서 약해질 수 있습니다. 등장인물이 중간에 물건을 집었다면 마지막 프레임의 외형만 자연스러워도 그 상태 변화가 유지되지 않을 수 있습니다.

그래서 장기 평가는 정체성뿐 아니라 상태 변수를 추적해야 합니다. 컵의 위치, 문이 열렸는지, 등장인물의 옷이 바뀌었는지처럼 시간에 따라 갱신되는 사실을 시점별로 표기하고 생성 결과와 비교합니다. 단순한 영상 유사도는 자연스러운 질감에 높은 점수를 주면서 사건 오류를 놓칠 수 있습니다.

Sink, Mid, Recent의 크기는 어떻게 정하나

Sink가 너무 짧으면 초반 배경과 인물 앵커가 사라지고, 너무 길면 이미 바뀐 설정을 계속 끌고 갈 수 있습니다. Recent가 짧으면 움직임이 끊기고, 길면 가장 비싼 고해상도 토큰이 캐시를 차지합니다. Mid 압축률과 Top-K는 그 사이의 사건 기억과 비용을 결정합니다. 세 값은 독립된 knob처럼 보여도 전체 상한 안에서 서로 자원을 빼앗습니다.

한 번에 모든 값을 바꾸지 말고 기준 설정에서 하나씩 sweep합니다. 각 설정마다 최대 VRAM, 프레임당 지연, 정체성, 상태 보존과 동작 반복을 기록합니다. 최적점을 하나의 평균으로 고르기보다 제품의 실패 비용에 가중치를 둡니다. 캐릭터 영상은 외형을, 로봇 합성 데이터는 객체 상태와 궤적을 더 무겁게 봐야 합니다.

5초 학습 클립의 한계는 어떻게 드러낼까

짧은 클립은 보행이나 카메라 이동 같은 국소 동작을 충분히 담을 수 있지만, 긴 원인과 결과를 직접 보여 주지 못합니다. 60초 뒤 되돌아오는 인물, 중간에 사라졌다 다시 등장하는 물체, 여러 shot에 걸친 목표 달성은 캐시만으로 학습되지 않을 수 있습니다. 모델이 그럴듯한 움직임을 이어 붙이는 것과 긴 계획을 지키는 것을 구분해야 합니다.

검증 세트에는 짧은 동작의 반복으로 해결할 수 없는 사건을 넣습니다. 초반에 색이나 수량을 지정하고 후반에 다시 확인하거나, 중간 선택이 마지막 결과를 바꾸게 만드는 식입니다. 실패가 압축 때문인지 학습 데이터의 시간 범위 때문인지 알아보기 위해 같은 캐시 구조에 더 긴 학습 클립을 넣은 기준선도 필요합니다.

보고된 120초를 재현할 때 무엇을 고정하나

모델 checkpoint, 해상도, FPS, frame 수, sampling step, precision과 GPU를 모두 적어야 합니다. “120초 영상”도 16 FPS와 24 FPS에서는 생성해야 할 토큰 수가 다릅니다. peak memory만 보지 말고 시간대별 할당량과 생성 속도를 남겨 캐시가 실제로 고정되는지 확인합니다. 영상 저장, 디코딩 메모리까지 포함한 프로세스 RSS도 별도로 봅니다.

재현 결과는 동일 seed 한 편으로 비교하지 않습니다. 장면 종류와 prompt 길이를 나누고 여러 seed에서 OOM, 속도와 품질 분산을 측정합니다. 논문의 상대 비교를 재현하지 못했을 때는 버전, 커널, 평가 코드 차이를 먼저 찾고, 더 작은 GPU에서 나온 결과를 원 논문의 배수와 직접 섞지 않습니다.

서비스에 넣으면 어떤 운영 문제가 생기나

사용자별 캐시가 유지되는 생성 서비스에서는 동시 세션 수가 총 VRAM을 결정합니다. 세션당 4GB라면 모델 가중치와 작업 공간을 제외하고도 수십 세션을 한 GPU에 넣기 어렵습니다. 최대 길이, idle timeout과 admission control을 정하고, 연결이 끊긴 캐시를 즉시 회수해야 합니다.

Top-K 선택과 압축 단계도 관측 가능해야 합니다. 후반에 객체가 바뀌었을 때 어떤 시간대의 토큰이 남았는지 확인할 수 없으면 튜닝이 추측이 됩니다. 설정, seed, 모델 버전과 시간대별 품질 지표를 저장하고, 새 checkpoint 배포 전 같은 장기 세트를 다시 돌리는 회귀 검사가 필요합니다.

캐시를 disk로 내리거나 session을 재개하는 기능을 추가하면 전송, 직렬화 비용과 호환성 문제가 생깁니다. 모델이나 RoPE 설정이 바뀐 뒤 옛 cache를 불러오지 않도록 format version을 두고, checksum과 소유 session을 확인해야 합니다. 복원 시간이 새로 생성하는 시간보다 길다면 재개 기능의 실익이 없으므로 길이별 break-even도 측정합니다.

함께 읽으면 이해가 이어지는 글

자주 묻는 질문

5초 영상만 학습하면 긴 영상 데이터가 필요 없나요?

아닙니다. 논문의 구조가 짧은 클립으로 긴 sampling을 가능하게 했다는 것과 긴 사건, 서사를 학습했다는 것은 다릅니다. 목표 업무에 장기 상태 변화가 있다면 그 능력을 별도로 평가해야 합니다.

KV 캐시 4GB는 어떤 GPU에서도 같은가요?

정밀도, 해상도, 프레임 수와 구현에 따라 달라질 수 있습니다. 논문의 H200 조건을 기준으로 보되 대상 하드웨어에서 peak VRAM과 속도를 직접 측정해야 합니다.

PackForcing은 무한 길이 생성을 보장하나요?

캐시 증가를 제한하는 설계는 길이를 늘리는 데 유리하지만 오류 누적과 의미 드리프트를 없애지 않습니다. 제품에는 최대 길이와 품질 중단 기준이 여전히 필요합니다.

THE END / OPSOAI

여기까지 읽었습니다

핵심 장면을 한 번 더 떠올려 보세요. 이해가 남았다면 이 책은 제 역할을 다했습니다.

다른 책 고르기
표지 1 —

←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.

CONTENTS

이 책의 목차

    11개 장 16 분읽는 시간