MonoArt는 사진 한 장에서 먼저 3D 형태를 만들고 파츠를 나눈 뒤, 형태와 움직임 쿼리를 분리해 관절 종류, 축, 범위를 추정합니다. 비디오 생성이나 다중 시점 추적을 생략하지만 보이지 않는 뒷면의 관절까지 사실로 복원할 수 있다는 뜻은 아닙니다.
사진 한 장에서 서랍의 축까지 찾을 수 있을까: MonoArt의 단계별 추론
한 번에 축을 맞히지 않고 구조를 쌓는다
이미지 특징에서 회전축과 이동 범위를 곧바로 회귀하면 형태 오류와 관절 오류가 섞입니다. MonoArt는 점진적 구조 추론으로 문제를 네 단계에 나눕니다. TRELLIS 기반 생성기가 표준 3D 형태와 tri-plane 피처를 만들고, part-aware semantic reasoner가 문, 서랍, 본체처럼 의미 있는 파츠 표현을 분리합니다.
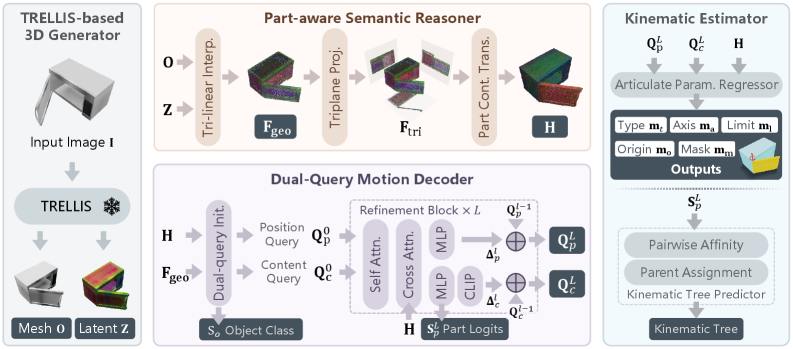
이 초기 형상이 이후 모든 판단의 기반입니다. TRELLIS 단계에서 가려진 부분을 잘못 만들면 파츠 구분과 관절 추정도 연쇄적으로 틀릴 수 있습니다. 단계가 분리돼 있어 중간 결과를 확인할 수 있다는 점이 이 오류를 진단하는 데 중요합니다.
중간 결과에서 어떤 오류를 먼저 찾을까
최종 관절 축만 보고 틀렸다고 하면 원인이 초기 메시인지 파츠 의미인지 운동 추론인지 알기 어렵습니다. 먼저 생성한 3D 형태가 입력 실루엣과 맞는지 확인하고, 다음으로 문, 서랍, 본체가 서로 다른 파츠로 분리됐는지 봅니다. 그 뒤 geometry query가 파츠 위치를 유지하는지, kinematic query가 올바른 부모, 자식 관계를 만드는지 단계별로 검사합니다.
예를 들어 서랍 앞판과 본체가 하나의 파츠로 합쳐졌다면 마지막 estimator가 직선 이동 축을 잘 고르기 어렵습니다. 파츠는 맞지만 축이 카메라 방향으로 기울었다면 단안 깊이 또는 운동 관계의 모호성이 원인일 수 있습니다. 중간 산출물을 저장하고 오류 유형을 연결하면 전체 모델 점수보다 수동 보정 위치를 빨리 찾을 수 있습니다.
평가 로그에는 입력 이미지, 표준 형상, 파츠 ID, kinematic tree와 최종 축, 범위를 같은 사례 ID로 묶습니다. 성공 예시만 렌더링하지 말고 어느 단계에서 처음 기준과 달라졌는지를 기록해야 새 카테고리에서 실패가 반복되는 이유를 설명할 수 있습니다.
두 쿼리가 형태와 운동 관계를 나눈다
Dual-Query Motion Decoder는 geometry query로 파츠의 모양과 위치를, kinematic query로 파츠 사이의 운동 관계를 추적합니다. 두 표현을 교차 어텐션으로 결합해 “어디에 있는 파츠인가”와 “어떻게 움직이는가”가 하나의 잠재 표현에서 충돌하는 문제를 줄입니다.
마지막 estimator는 회전형과 직선 이동형 같은 모션 종류, 원점, 축과 가동 범위를 명시적 파라미터로 출력하고 kinematic tree를 구성합니다. 이 결과는 로봇 시뮬레이터용 구조로 매핑할 수 있지만, 원문의 의사 코드처럼 자동으로 완전한 URDF와 물성까지 만들어 주는 실행 절차가 제시된 것은 아닙니다.
kinematic tree는 어떤 물리 규칙으로 확인할까
각 움직이는 파츠에는 부모가 하나인지, 루트까지 순환 없이 연결되는지 확인합니다. 회전 관절의 원점과 축이 실제 힌지 부근에 있는지, 직선 관절의 축이 서랍 레일 방향과 맞는지도 봅니다. 예측 범위가 메시를 본체와 관통시키거나 인접 파츠를 계속 충돌시키면 숫자가 그럴듯해도 사용할 수 없는 에셋입니다.
같은 물체에 문과 서랍이 함께 있다면 관절 종류를 바꿔도 렌더링 한 프레임은 비슷하게 보일 수 있습니다. 범위 전체를 애니메이션으로 재생하고 파츠 사이 간격, 충돌과 연결이 유지되는지 확인해야 합니다. 중립 자세뿐 아니라 최소, 최대 각도와 중간 자세를 검사하면 잘못된 축 원점이 더 잘 드러납니다.
질량, 마찰과 구동 힘은 이미지 한 장의 구조 추론만으로 정해지지 않습니다. MonoArt 출력에 이런 물성이 포함된다고 가정하지 말고, 시뮬레이터 변환 단계에서 별도 출처나 기본값을 명시합니다. 시각적으로 열리는 문과 물리적으로 안정적인 로봇 자산을 같은 완료 조건으로 두면 안 됩니다.
속도 비교는 같은 출력 범위에서 본다
원문은 보조 비디오를 생성해 추적하는 Articulate-Anything, 다중 시점 생성과 최적화를 쓰는 PhysX-Anything보다 MonoArt가 PartNet-Mobility에서 추론 시간과 F-score의 좋은 균형을 보인다고 설명합니다.
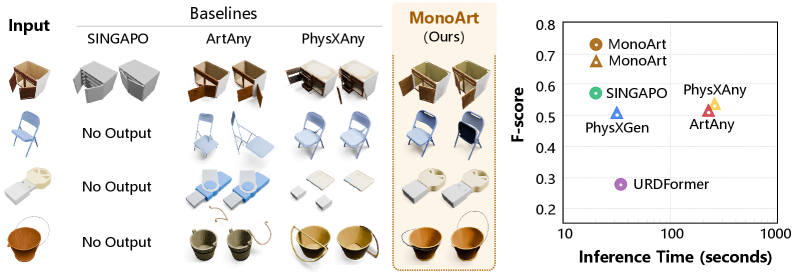
비디오 단계를 없앴다는 사실만으로 전체 에셋 제작 시간이 정해지지는 않습니다. 메시 정리, 파츠 충돌 검사, 축 보정과 시뮬레이터 변환이 뒤에 남을 수 있습니다. 같은 입력 이미지에서 파츠 분할, 축 방향, 관절 종류와 범위를 각각 채점하고 수동 수정 시간까지 포함해야 실무 이득을 판단할 수 있습니다.
속도와 정확도는 어떤 단위로 비교할까
비교 모델이 완성 메시만 출력하는지, 관절 트리와 범위까지 출력하는지 먼저 맞춥니다. 한 방법은 GPU 추론만 재고 다른 방법은 비디오 생성, 최적화와 후처리까지 포함하면 시간 비교가 공정하지 않습니다. 입력 준비부터 시뮬레이터에서 움직이는 에셋을 얻기까지의 전체 시간과 단계별 시간을 함께 기록합니다.
형상 F-score 하나로는 관절 품질을 알 수 없습니다. 파츠 분할 정확도, 회전, 직선 종류, 축 방향과 원점 오차, 범위 오차, 트리 연결과 충돌 실패를 별도로 둡니다. 자동 점수가 비슷하다면 사람이 메시와 축을 고치는 데 걸린 시간이 실제 제작 효율을 가를 수 있습니다.
카테고리별 결과도 필요합니다. 단순한 한 개 문, 여러 서랍, 대칭형 문과 내부가 가려진 물체를 한 평균에 섞으면 어느 대상에서 자동 초안이 유용한지 알 수 없습니다. 파일럿의 목표는 모든 물체를 자동 완성하는 것이 아니라 수동 제작 시간을 줄일 카테고리를 찾는 것입니다.
단안의 모호함을 어떻게 표시할까
정면에서 보이지 않는 힌지가 왼쪽인지 오른쪽인지, 닫힌 서랍이 얼마나 깊은지는 이미지로 결정되지 않을 수 있습니다. 모델이 하나의 축과 범위를 출력하더라도 여러 구조가 같은 픽셀을 설명할 수 있다는 사실은 남습니다. 낮은 확신 사례를 숨기지 않고 검토 대상으로 보내는 정책이 필요합니다.
입력을 수평 반전하거나 조금 자른 뒤 결과 축이 논리적으로 함께 바뀌는지 확인할 수 있습니다. 조명과 배경만 바꿨는데 관절 종류가 달라지면 객체 구조보다 시각적 편향에 의존했을 가능성이 있습니다. 가능한 경우 다른 시점 한 장이나 실제 동작 프레임을 추가해 후보를 줄이고, 단안 결과와 얼마나 달라지는지 기록합니다.
결과 UI에서는 메시만 보여 주지 말고 파츠 색, 부모, 자식 연결, 축과 범위 호를 겹쳐 표시하는 편이 좋습니다. 사용자가 틀린 파츠나 축을 선택해 고칠 수 있고 수정 내역을 저장해야 자동 초안을 안전하게 제작 과정에 넣을 수 있습니다.
논문 페이지의 결과를 기준으로 삼되 자신의 이미지에서는 틀린 축을 사람이 고칠 수 있는 UI와 물리 검증 단계를 둬야 합니다. MonoArt는 관절 에셋 생성의 초안을 빠르게 만드는 연구이지 안전한 로봇 조작에 바로 투입할 완성 에셋 검증기를 대신하지 않습니다.
도입 순서는 어떻게 잡을까
먼저 실제 관절 구조를 알고 있는 소수의 기준 에셋과 여러 난도의 단일 이미지를 준비합니다. MonoArt의 형상, 파츠와 운동 출력 각각을 기준과 비교하고 수동 보정 시간을 잽니다. 다음으로 잘린 물체, 반사 표면과 강한 가림을 넣어 자동 거부 또는 검토 경계가 작동하는지 봅니다.
초안이 안정적인 카테고리에만 시뮬레이터 변환을 연결합니다. 변환 뒤에는 전체 가동 범위의 충돌, 동역학 안정성과 로봇 정책이 기대한 접촉을 만드는지 별도 검증합니다. 실패한 에셋이 학습이나 안전 평가에 조용히 섞이지 않도록 버전과 승인 상태를 남깁니다.
추론 시간이 짧아도 수동 수정이 거의 줄지 않으면 도입 이득이 없습니다. 반대로 완전 자동은 아니어도 파츠 초안과 축 후보가 반복적으로 제작 시간을 줄이면 제한된 도메인에서 가치가 있습니다. 자동화 비율보다 오류를 발견하고 고칠 수 있는 전체 파이프라인으로 판단해야 합니다.
함께 읽으면 이해가 이어지는 글
- 냉장고 문을 열 때 손이 관통한다면: ArtHOI의 4D 재구성 — ArtHOI가 단안 비디오의 광학 흐름으로 관절 객체를 먼저 복원하고 사람 접촉을 맞추는 분리형 파이프라인, 제로샷 범위와 한계를 설명합니다.
- 손은 움직였는데 AI 영상 속 물체가 안 따라오면? Generated Reality의 2D, 3D 제어 — Generated Reality가 손의 2D 골격과 3D 관절, 머리 움직임을 함께 조건으로 써 상호작용 영상을 제어하는 방법과 실시간 적용의 한계를 살펴봅니다.
- 비디오 데이터를 더 모아도 움직임이 나쁜 이유: Motive의 선별법 — 정적 배경이 지배하는 손실에서 움직임 영역을 분리해 각 학습 클립의 기여도를 매기고 선별하는 과정과 오분류 위험
자주 묻는 질문
MonoArt는 사진 한 장만으로 보이지 않는 관절도 정확히 복원하나요?
아닙니다. 가려진 뒷면과 내부 힌지는 관측 근거가 없어 학습된 형태 사전에 의존하므로, 결과를 후보 에셋으로 보고 다중 시점이나 물리 검사로 확인해야 합니다.
Dual-Query Motion Decoder가 나누는 두 정보는 무엇인가요?
geometry query는 파츠의 모양과 위치를, kinematic query는 파츠 사이의 운동 관계를 추적하고 교차 어텐션으로 결합해 관절 파라미터를 예측합니다.
로봇 시뮬레이터에 바로 넣어도 되나요?
바로 투입하기보다 파츠 메시, 부모, 자식 관계, 관절 종류, 원점, 축, 범위와 충돌을 검사하고 실제 동작이나 기준 에셋과 대조한 뒤 변환해야 합니다.
표지 1 —
←→ 키와 좌우 스와이프를 지원합니다. 읽던 페이지는 이 기기에 저장됩니다.
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.